品牌角色走进新场景
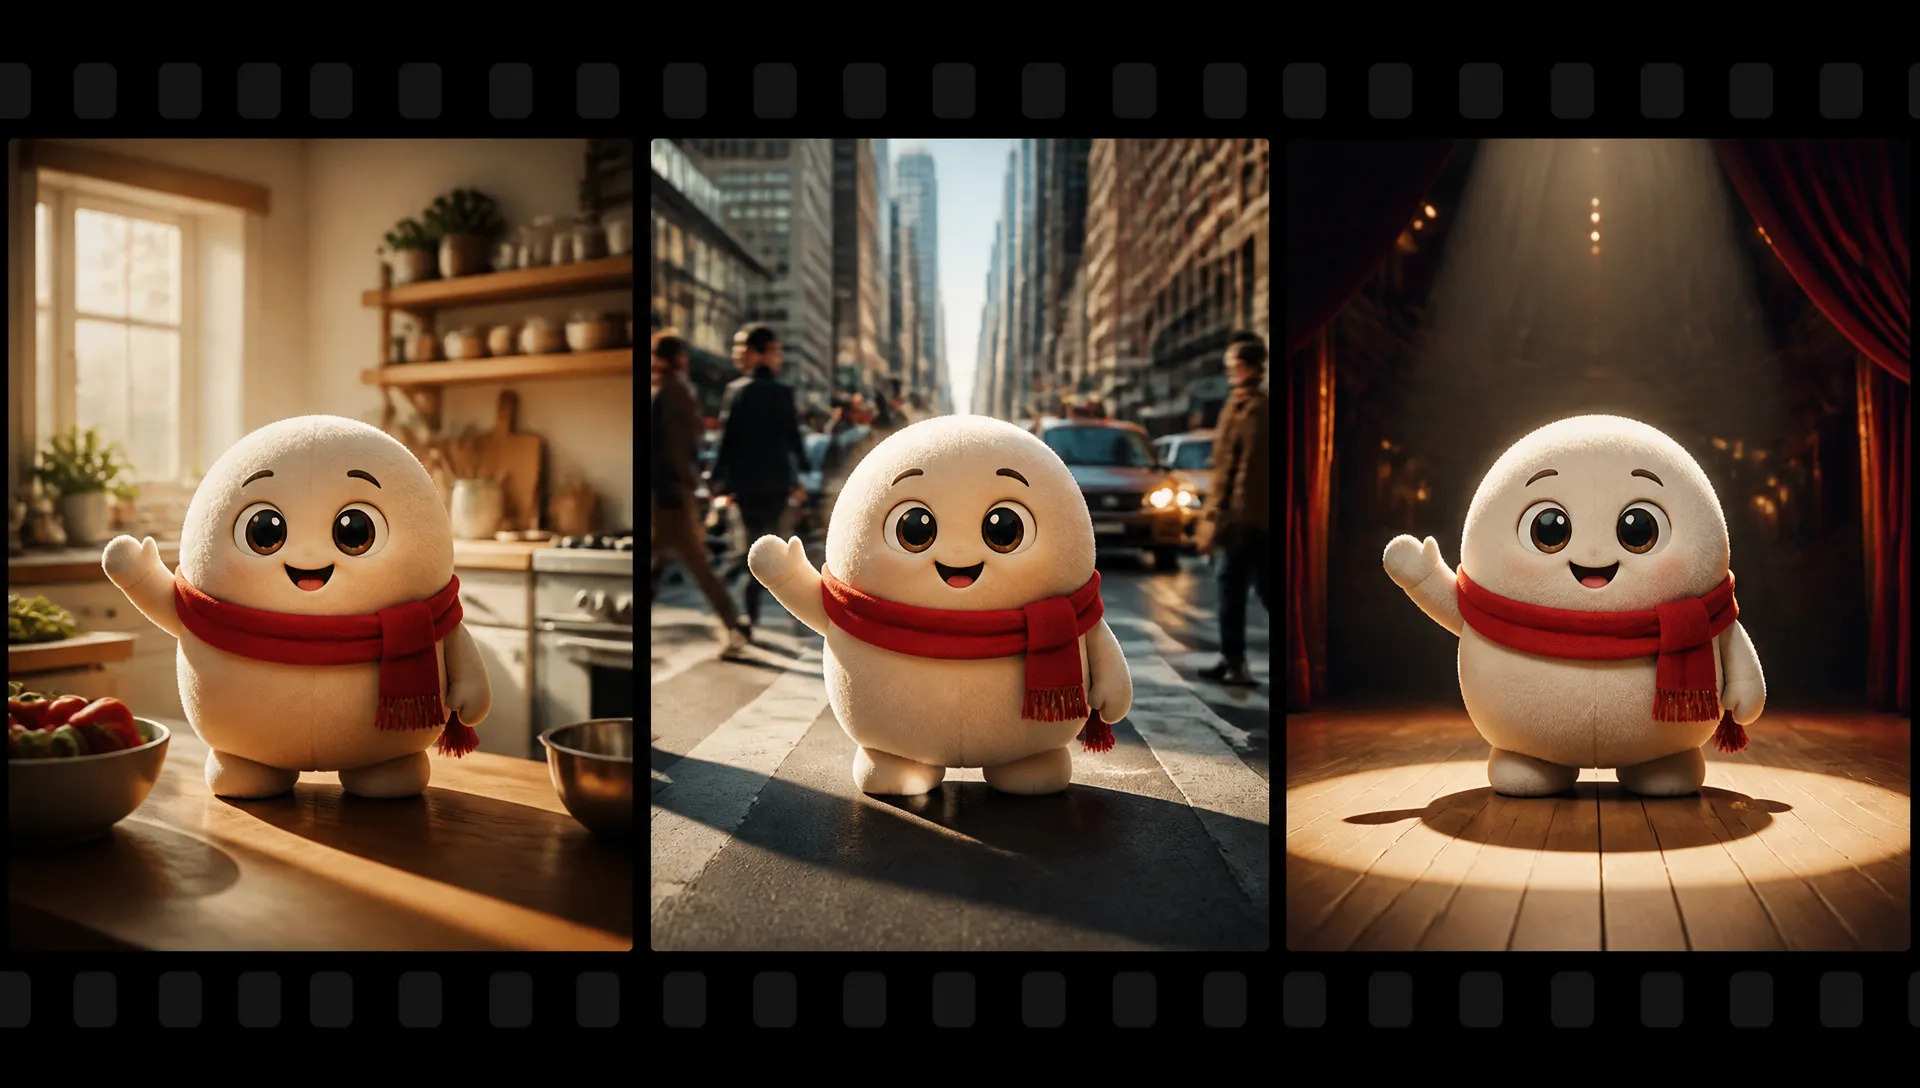
吉祥物或代言人保持完全一致,放进厨房、街头或舞台。
Vidu 最新视频模型:最多 12 个参考主体、3 段参考声音,单条 3 到 16 秒,原生音频,最高 4K。
一次充值积分,通用所有模型,想用再用。 · 按需充值,不存在月度清零。
Powered by Vidu AI's API on ZOOOP
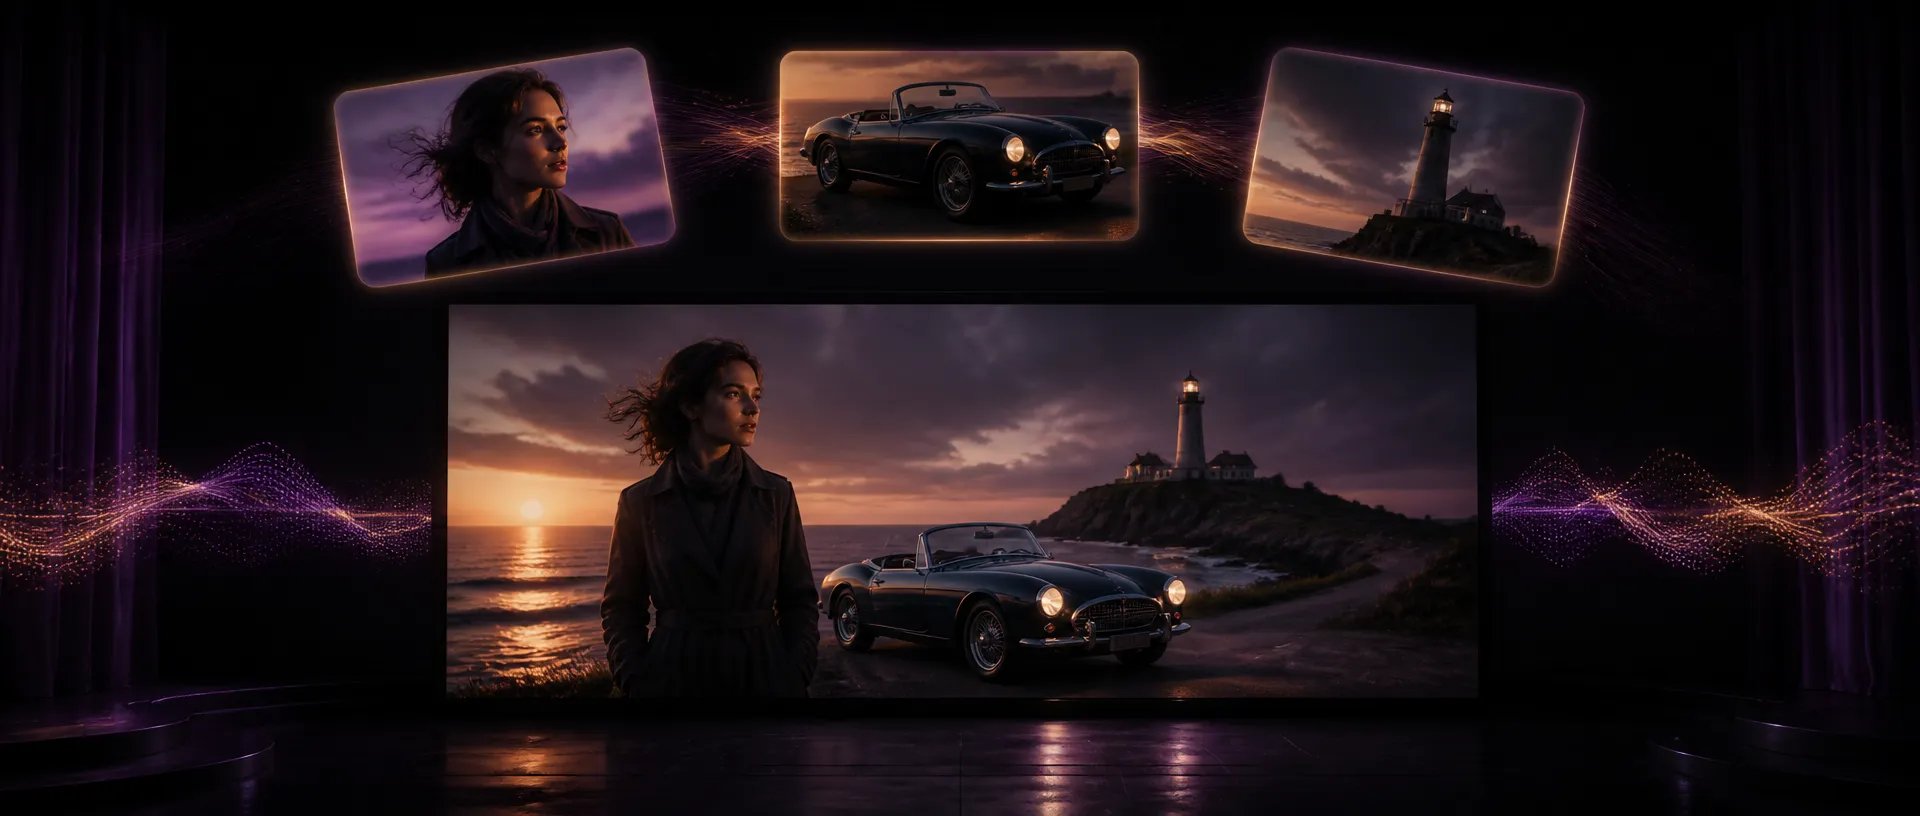
附上最多 12 张角色、产品或场景的图片,模型会让每一个在整段视频里保持一致。
加最多 3 段 3 到 12 秒的 MP3 声音片段,生成的对白会跟着这些声音走。
五档分辨率:先用 540p 出草稿,选中的那条再用 1080p、2K 或 4K 出成片。
时长 3 到 16 秒任选,对白、音效、环境音同步生成。只要画面时可以关掉声音。
吉祥物或代言人保持完全一致,放进厨房、街头或舞台。
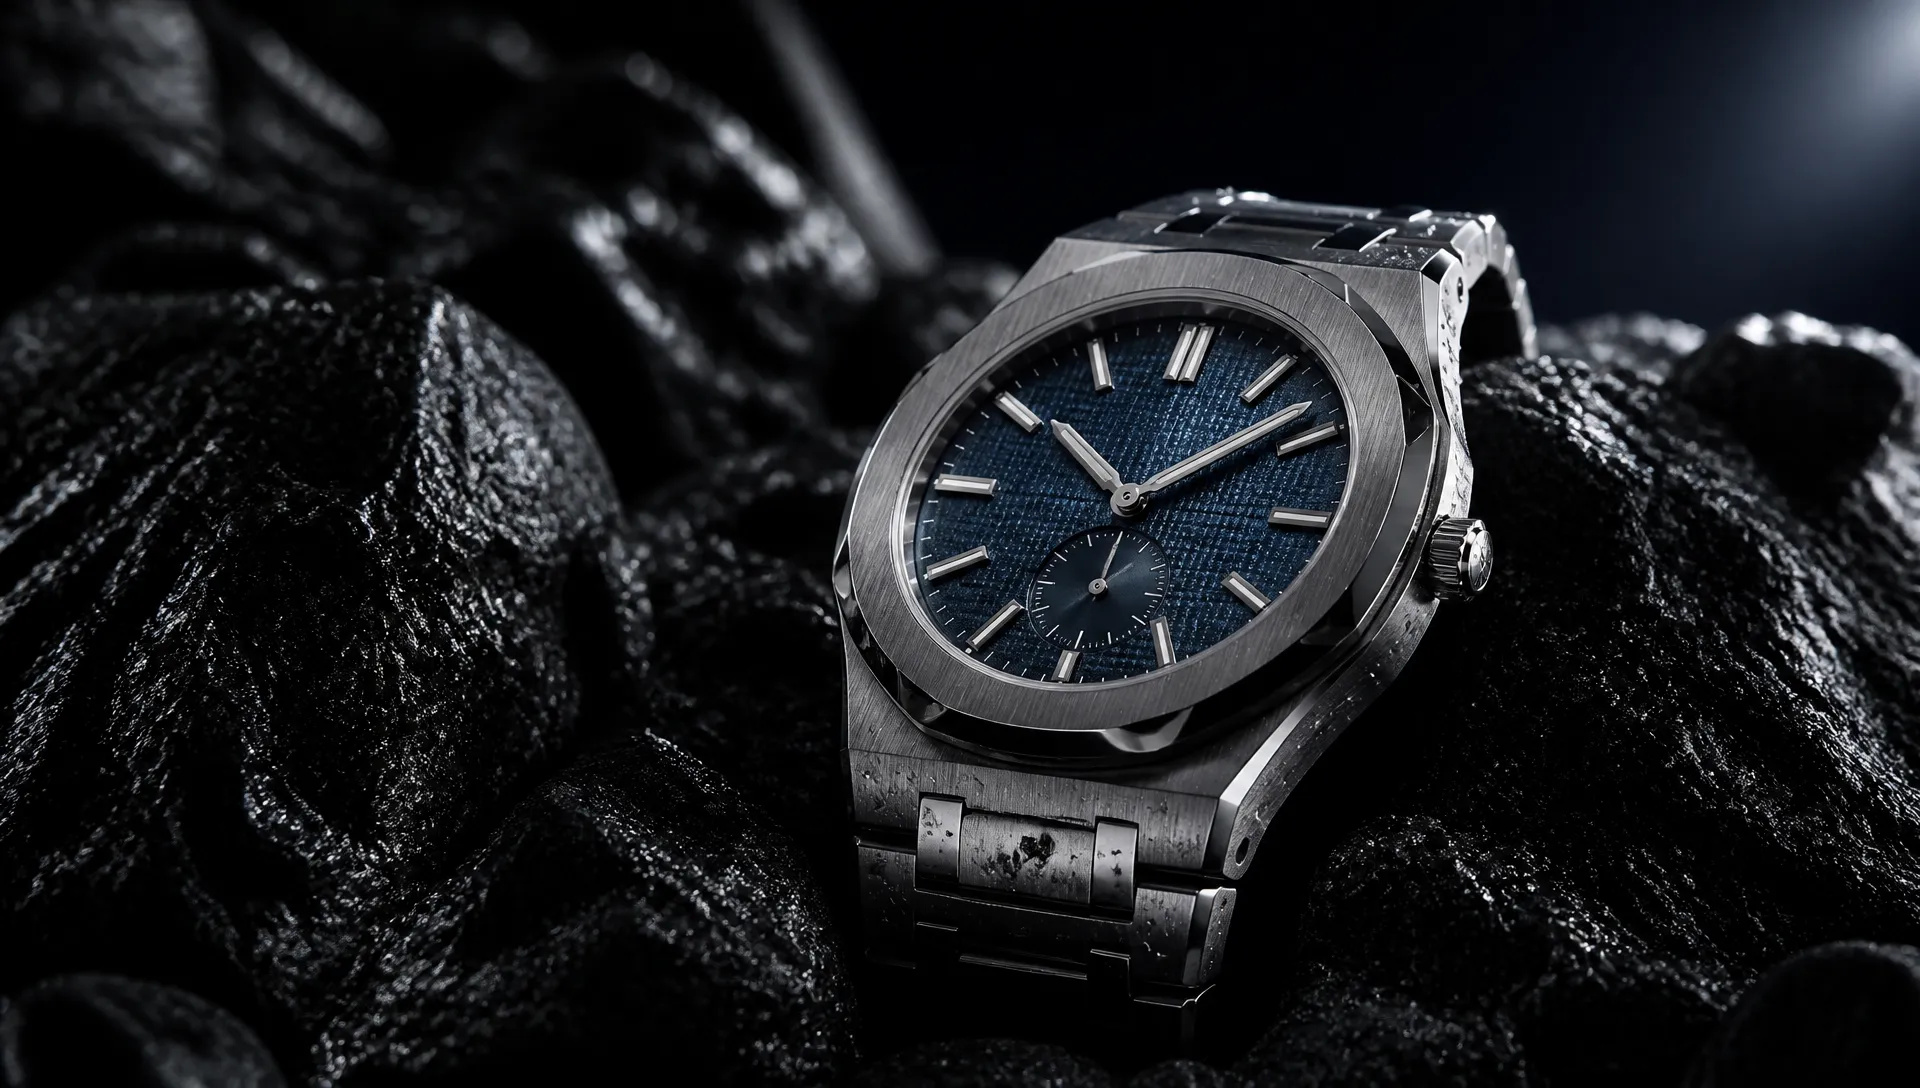
把一张产品静图做成精致的镜头,最终用 4K 渲染,上大屏也够清楚。
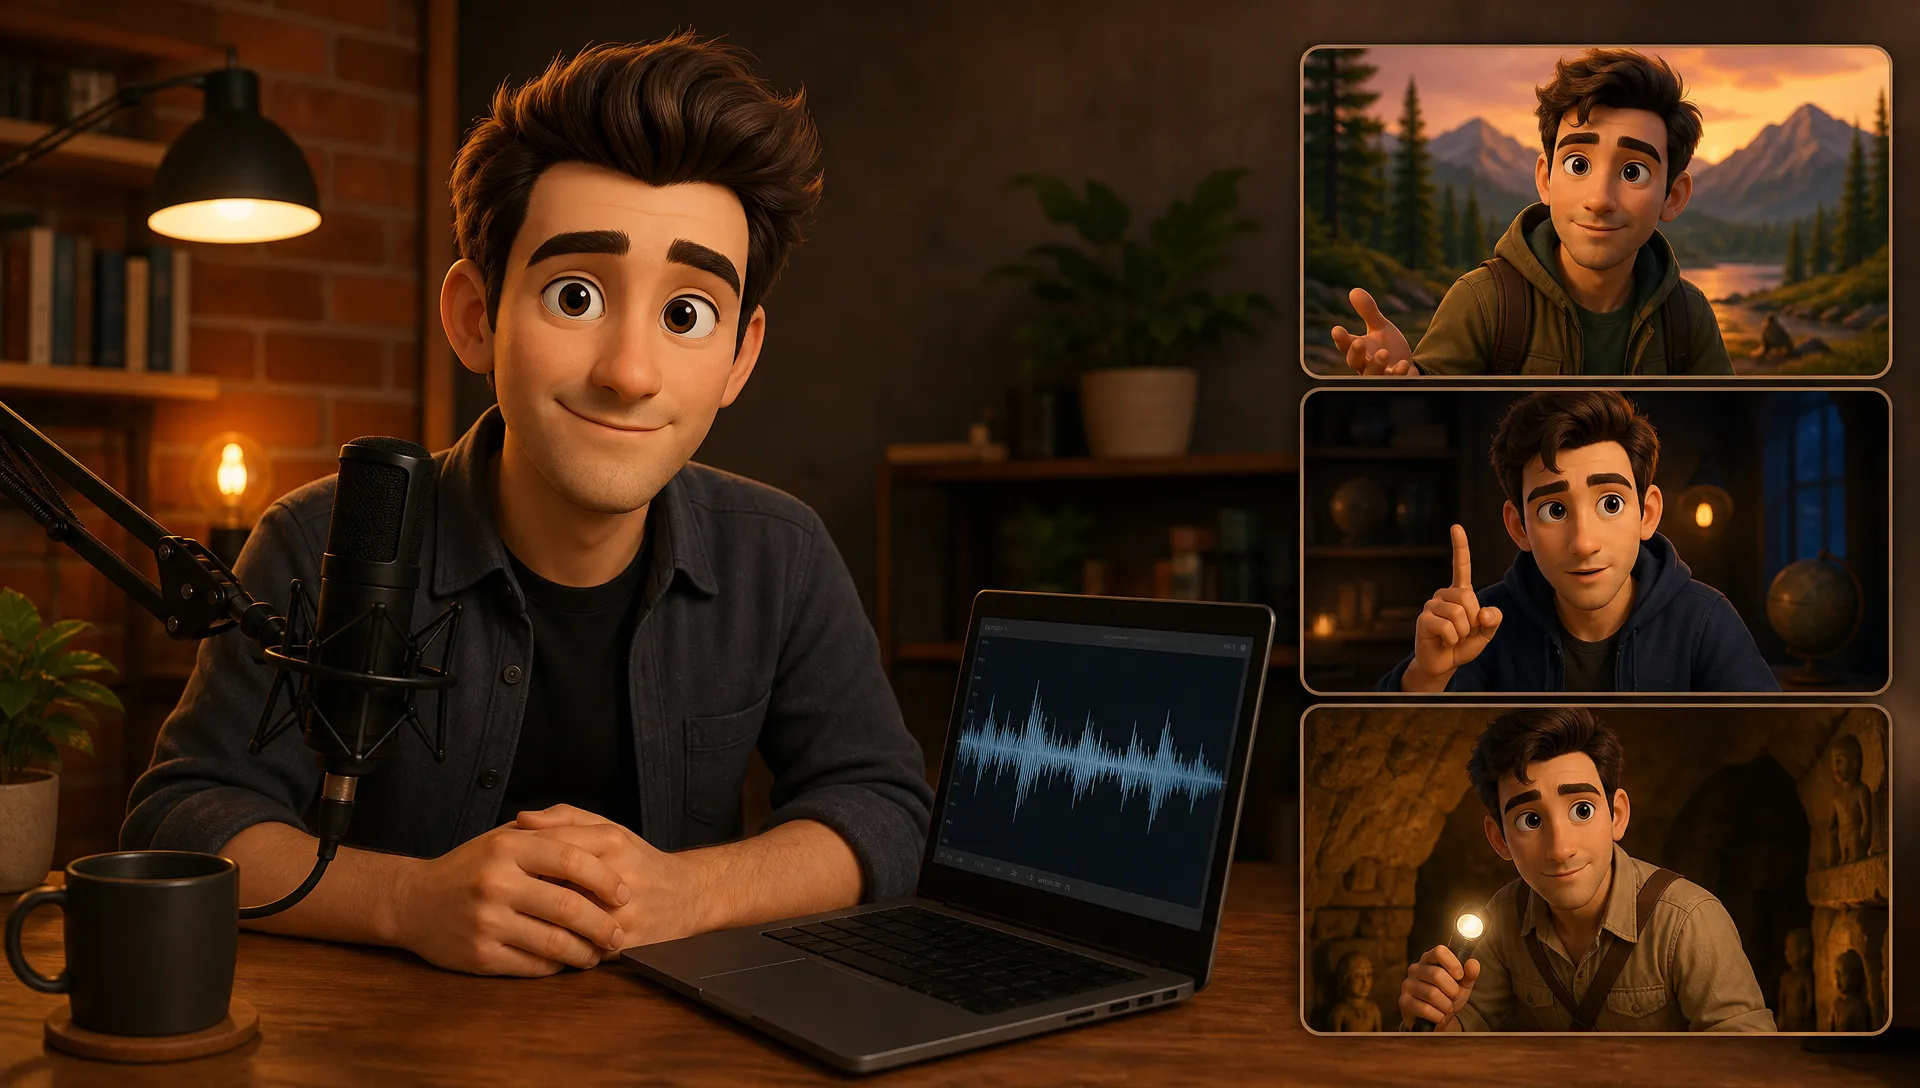
每一集都用同一段声音参考,旁白或角色的声音始终如一。
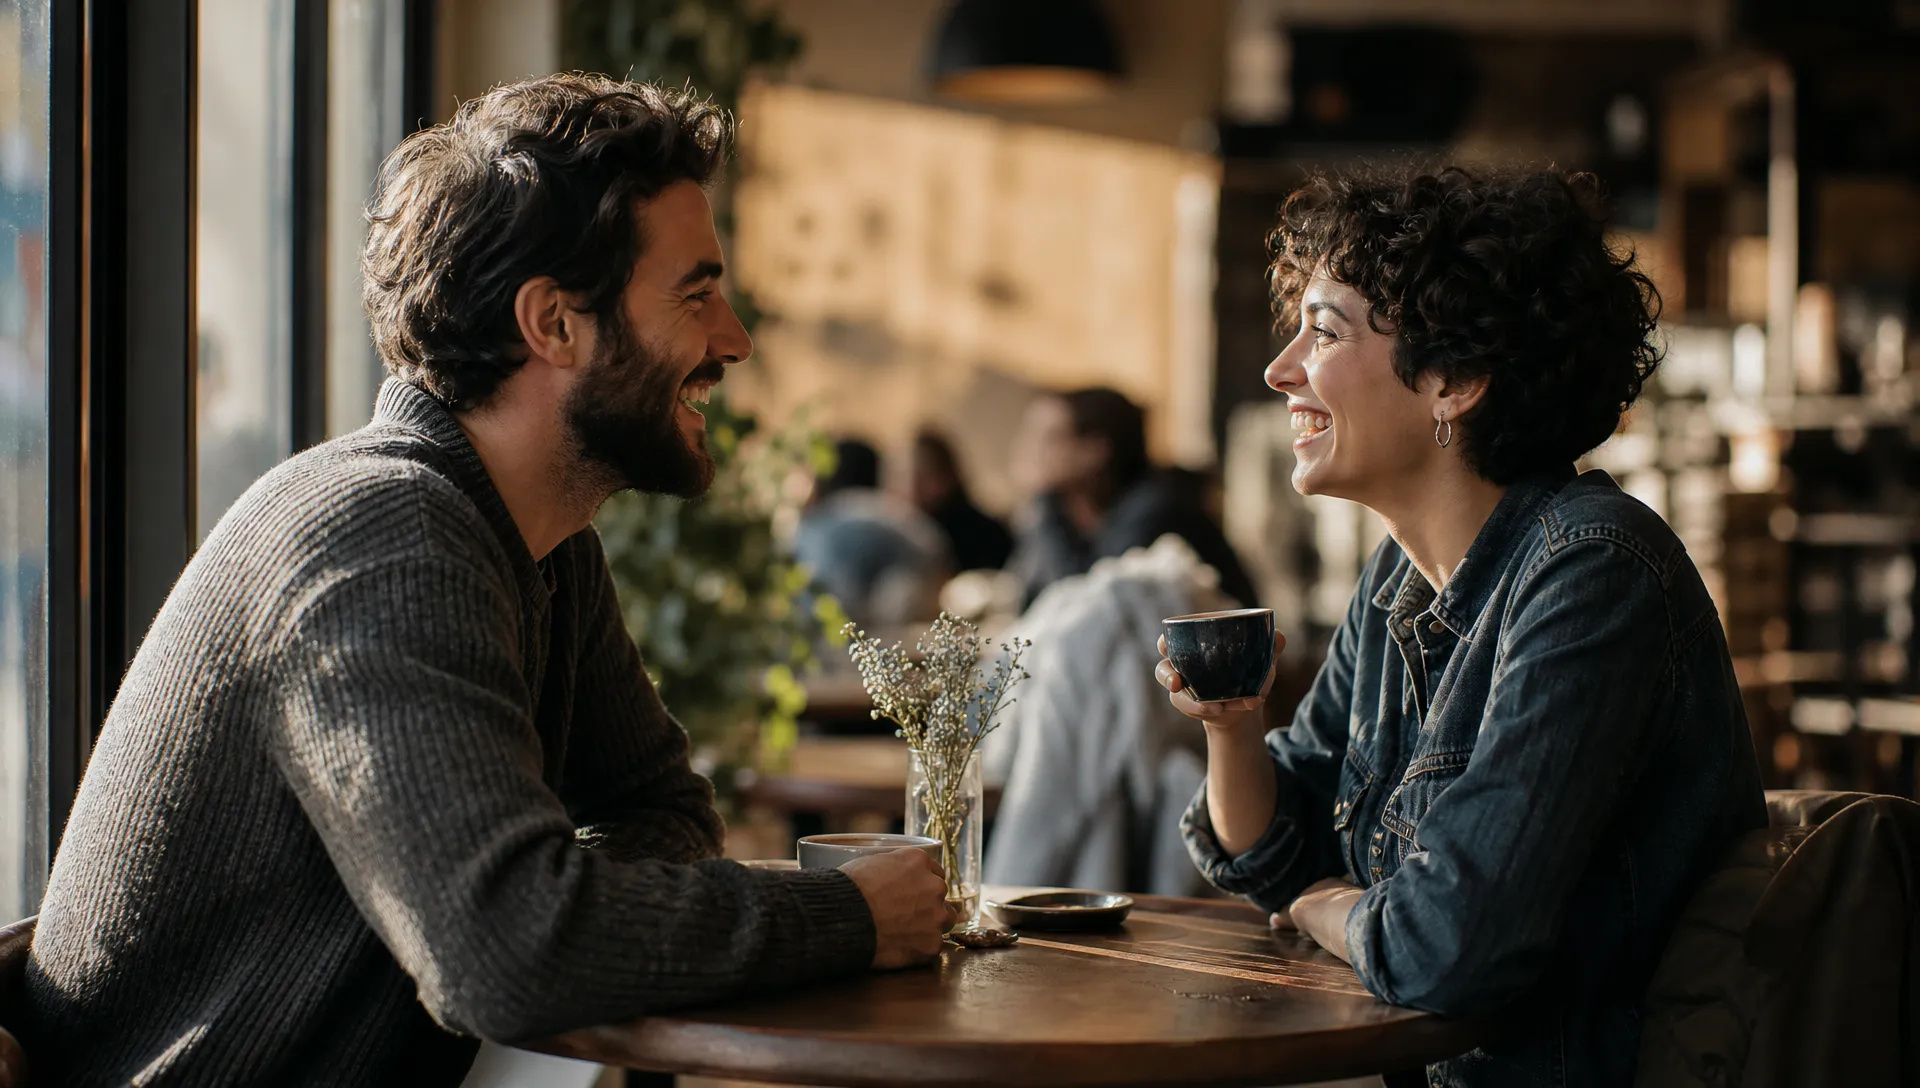
一个镜头里放进好几个角色参考,比如两个朋友在咖啡馆见面。
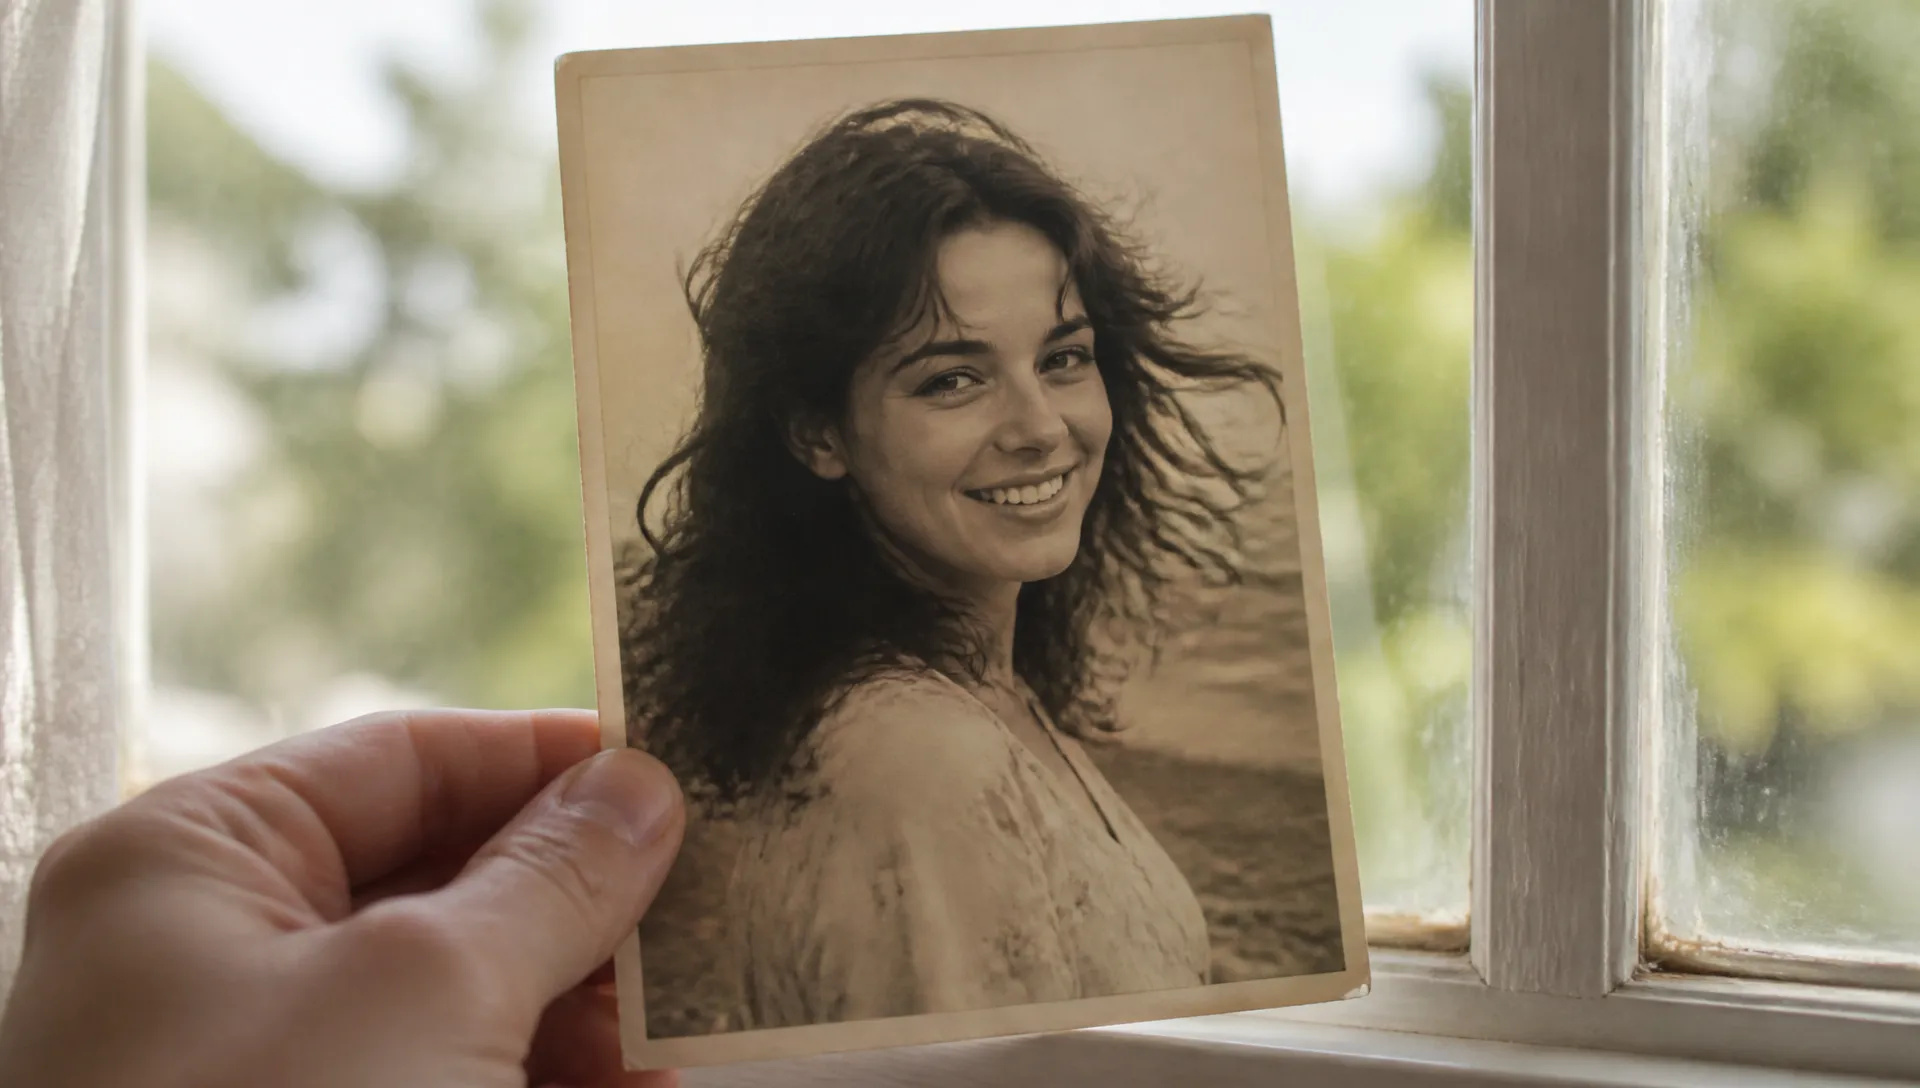
从一张照片开始,让画面动起来:头发被风吹起、一个微笑、镜头轻轻漂移。
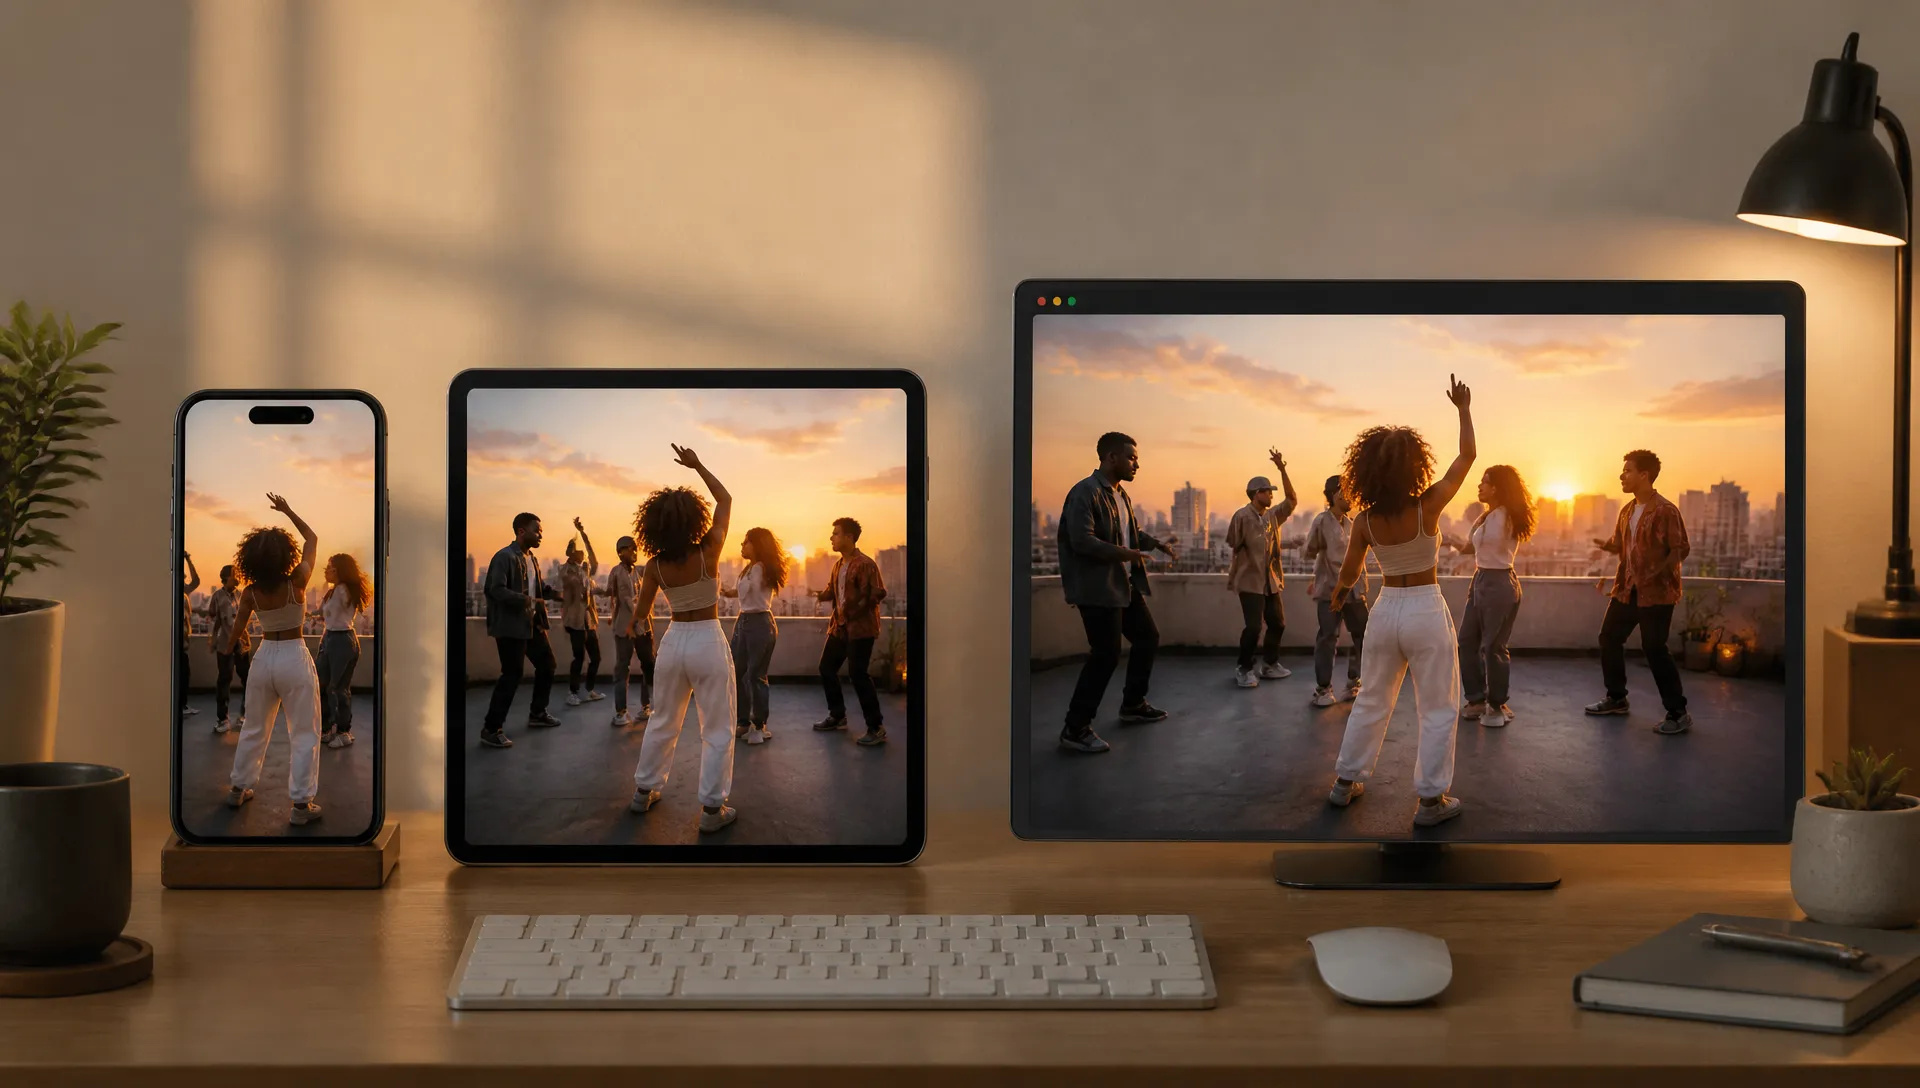
参考生视频可以出 9:16 做短视频,也可以出 1:1、4:3 发信息流。
Vidu Q4 的专长是参考:主体多、声音稳、最高 4K。镜头需要别的能力时,再换下面的模型。
在本页打开 Vidu Q4,选模式:首帧,或参考图(可加参考声音)。
上传首帧或参考图,写清楚要发生什么。
选时长(3 到 16 秒)、分辨率(540p 到 4K),参考模式下再选画幅。
先用低档位出一条看效果,满意了再用高分辨率重出。
Vidu Q4 的强项是同时让很多东西保持一致。大多数视频模型只适合一两张参考,Q4 一个镜头最多能吃 12 张参考图,再加最多 3 段参考声音。一群角色、一个产品、一个场景都能保持原样,生成的对白也是对的声音。
第一项核心能力是带主体和声音的参考生视频。附上图片,在提示词里写清谁做什么,还可以再加 3 到 12 秒的 MP3 声音片段。在我们的测试里,两个机器人参考在 9:16 竖屏里并排站在夕阳下的屋顶上轻轻摇摆,造型没有互换;单个角色朝镜头挥手打招呼时,声音和画面一起生成。
第二项是分辨率跨度大。从 540p 到 4K 共五档,可以先便宜地试一条,满意的再用 2K 或 4K 出给大屏,不用换模型。
第三项是够长,还带声音。时长 3 到 16 秒任选,对白、音效、环境音同步生成;只要画面时也可以关掉声音。
不擅长的地方:没有纯文生模式,也不支持尾帧。纯文生视频用 Gemini Omni 1.1 Flash 或 MiniMax H3 Max,首尾帧过渡用 MiniMax H3 Max。它目前还是预览版,表现可能会随版本变化。单镜头超过 16 秒,可以用 Wan V3.0,最长 30 秒。
一个合理的用法:几个主体或某个声音必须保持一致,或者成片必须是 4K 时,选 Vidu Q4。要快速出首帧片用 MiniMax H3 Max,要编辑或续写用 Gemini Omni 1.1 Flash。
它是 Vidu 最新的视频模型,2026 年 10 月以预览版发布。在 ZOOOP 上可以让首帧动起来,或用最多 12 张参考图、最多 3 段参考声音生成场景,自带原生音频。
不能。Vidu Q4 需要一张首帧或至少一张参考图。纯文生视频请用 Gemini Omni 1.1 Flash 或 MiniMax H3 Max。
上传最多 3 段 MP3,每段 3 到 12 秒。生成的语音会跟着这些声音走,同一个角色在不同片子里听起来都一样。
每次生成 3 到 16 秒任选。
540p、720p、1080p、2K、4K。参考模式有 16:9、9:16、1:1、4:3、3:4;首帧模式跟随你的图片比例。
不支持,只有首帧。要做首尾帧过渡,请用 MiniMax H3 Max 或 Gemini Omni 1.1 Flash。
Vidu Q4
Prompt*
Reference Images*
Reference Voices
选择比例*
视频分辨率*
时长*
登录后,你的生成结果会出现在这里。
创建账号免费。