让静态图动起来
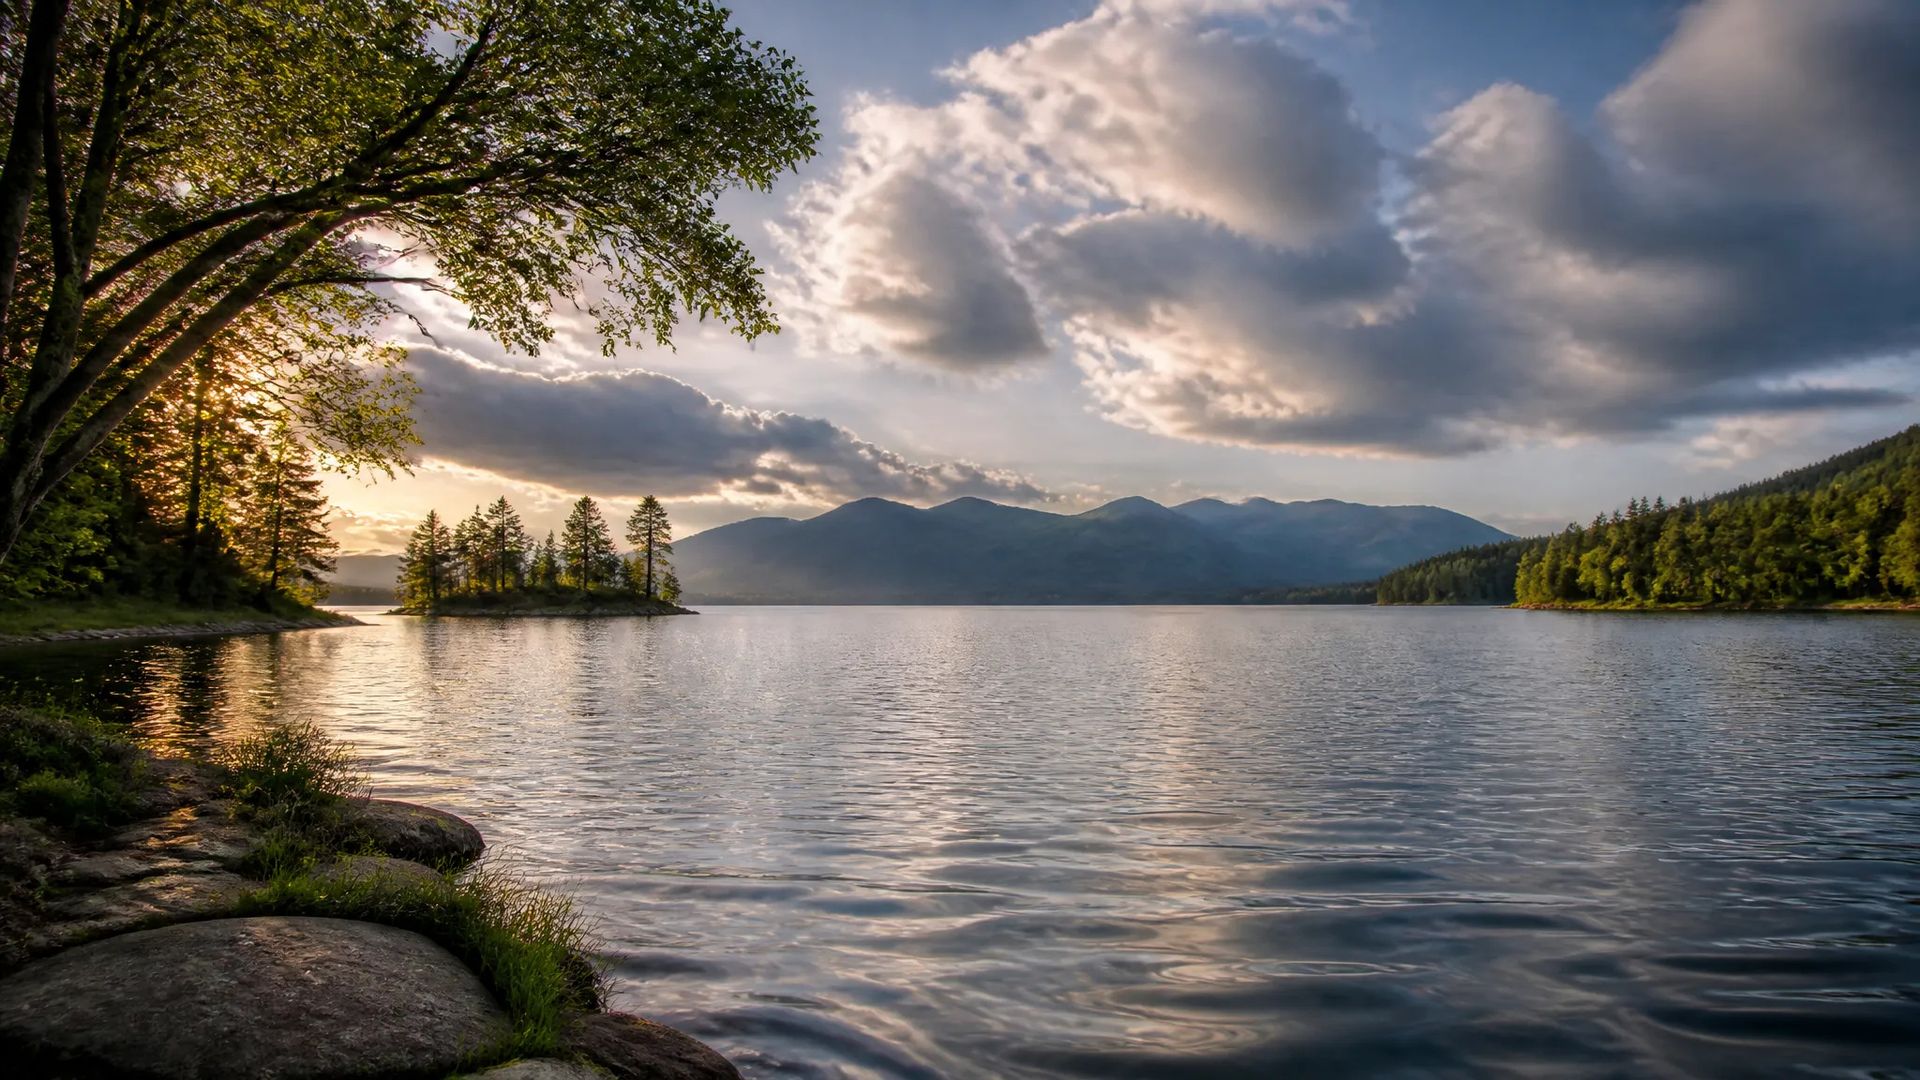
传一张静图——比如一张安静的湖畔风景——Grok Imagine V1.5 一次推理就给它加上粼粼水波、摇曳枝叶和流动云层并配环境音,无需手 K 关键帧。
xAI 的 Grok Imagine 1.5 视频模型——让静图动起来、用文字写场景,或用最多 7 张参考图引导,全都带原生同步音频。
一次充值积分,通用所有模型,想用再用。 · 按需充值,不存在月度清零。
Powered by xAI's API on ZOOOP
Grok Imagine V1.5 在 Image-to-Video Arena 公开榜预览阶段拿下第一——相比 1.0,在运动质量和「单张静图如何忠实地变成动态镜头」上明显进步。
每段视频都在同一次推理里附带同步音频——对白、环境音、音效,说话角色还带对口型。无需单独的运动模型、TTS 或 Foley 步骤。
1.5 的核心升级是稳定性——主体、面部、场景元素在整段视频里保持一致,不再逐帧漂移或扭曲。
可以从一张图开始、只用文字开始,或用最多 7 张参考图开始,720p 或 480p、1 到 15 秒成片。文生和参考模式支持从 16:9 到 9:16 共七种画幅。
传一张静图——比如一张安静的湖畔风景——Grok Imagine V1.5 一次推理就给它加上粼粼水波、摇曳枝叶和流动云层并配环境音,无需手 K 关键帧。
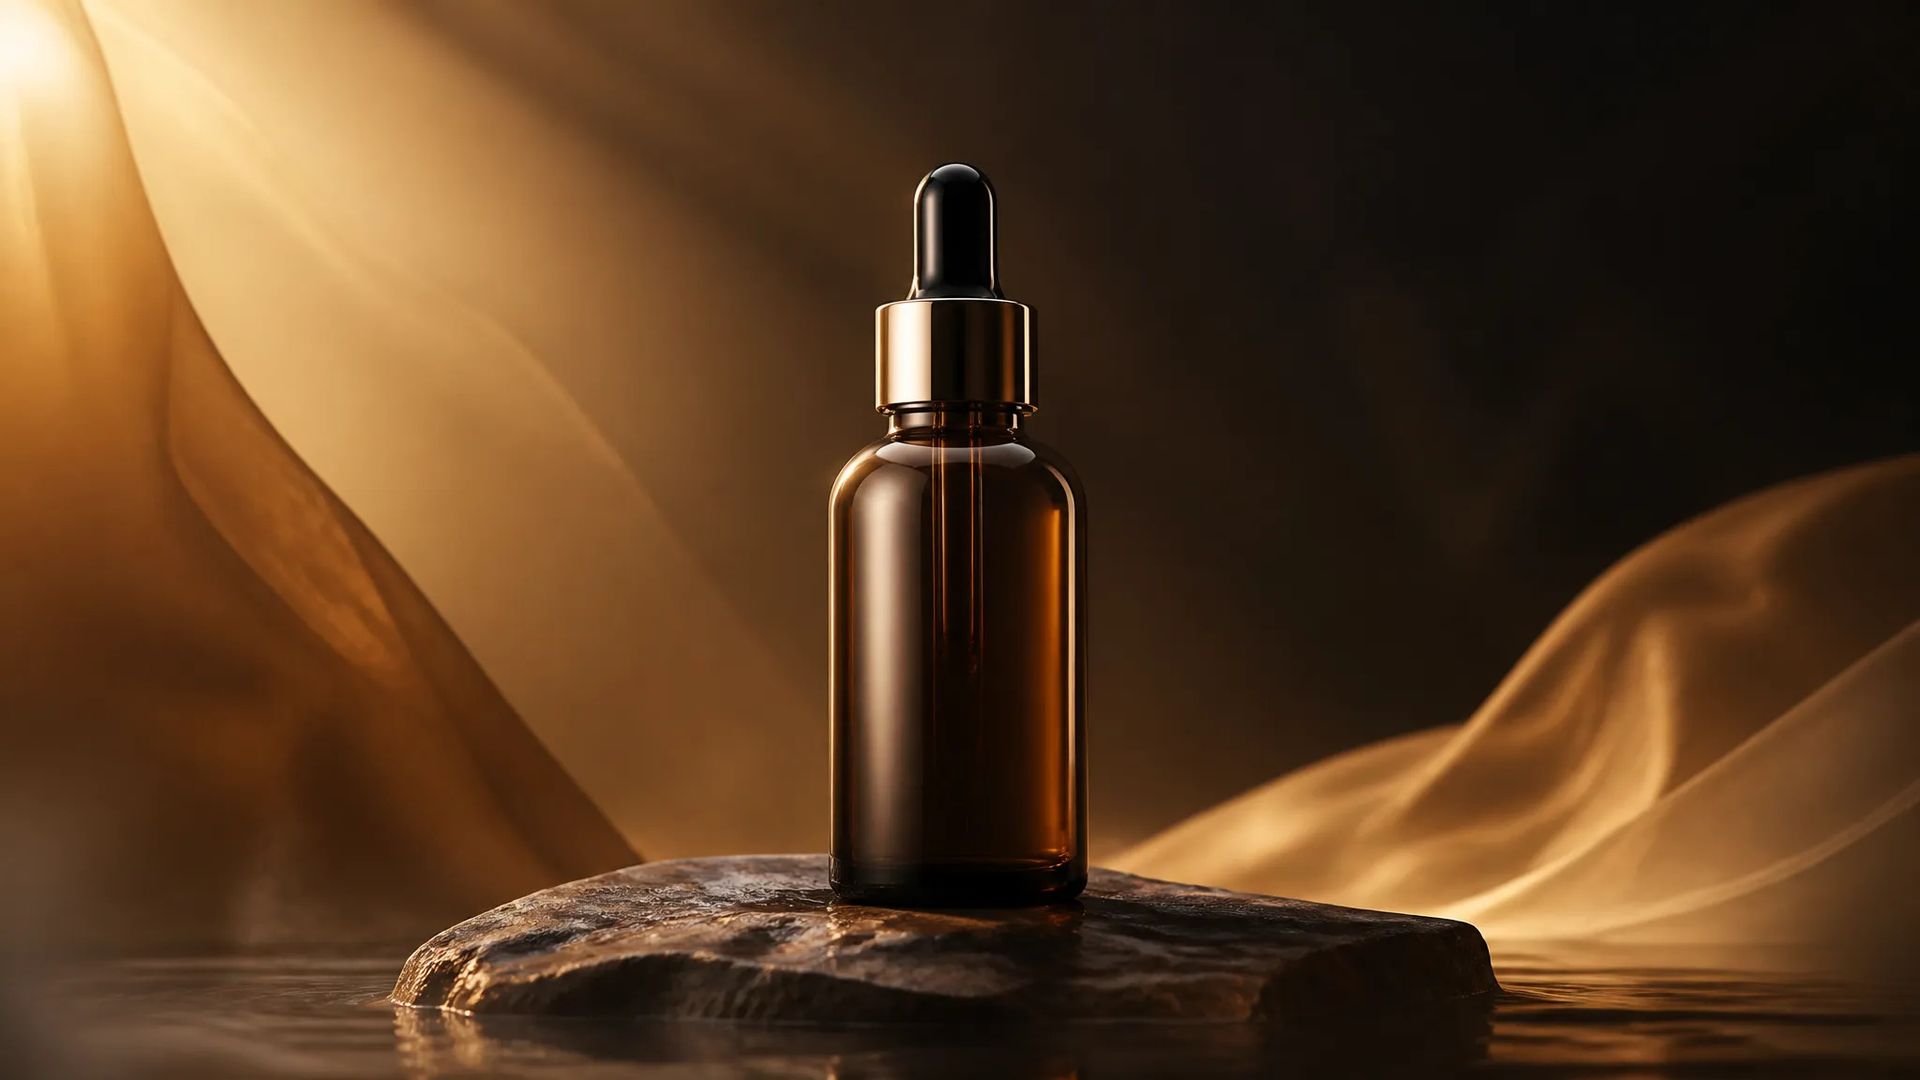
把一张产品静图变成短展示或旋转循环并配环境音——无需实拍,直接用于电商详情和社媒。
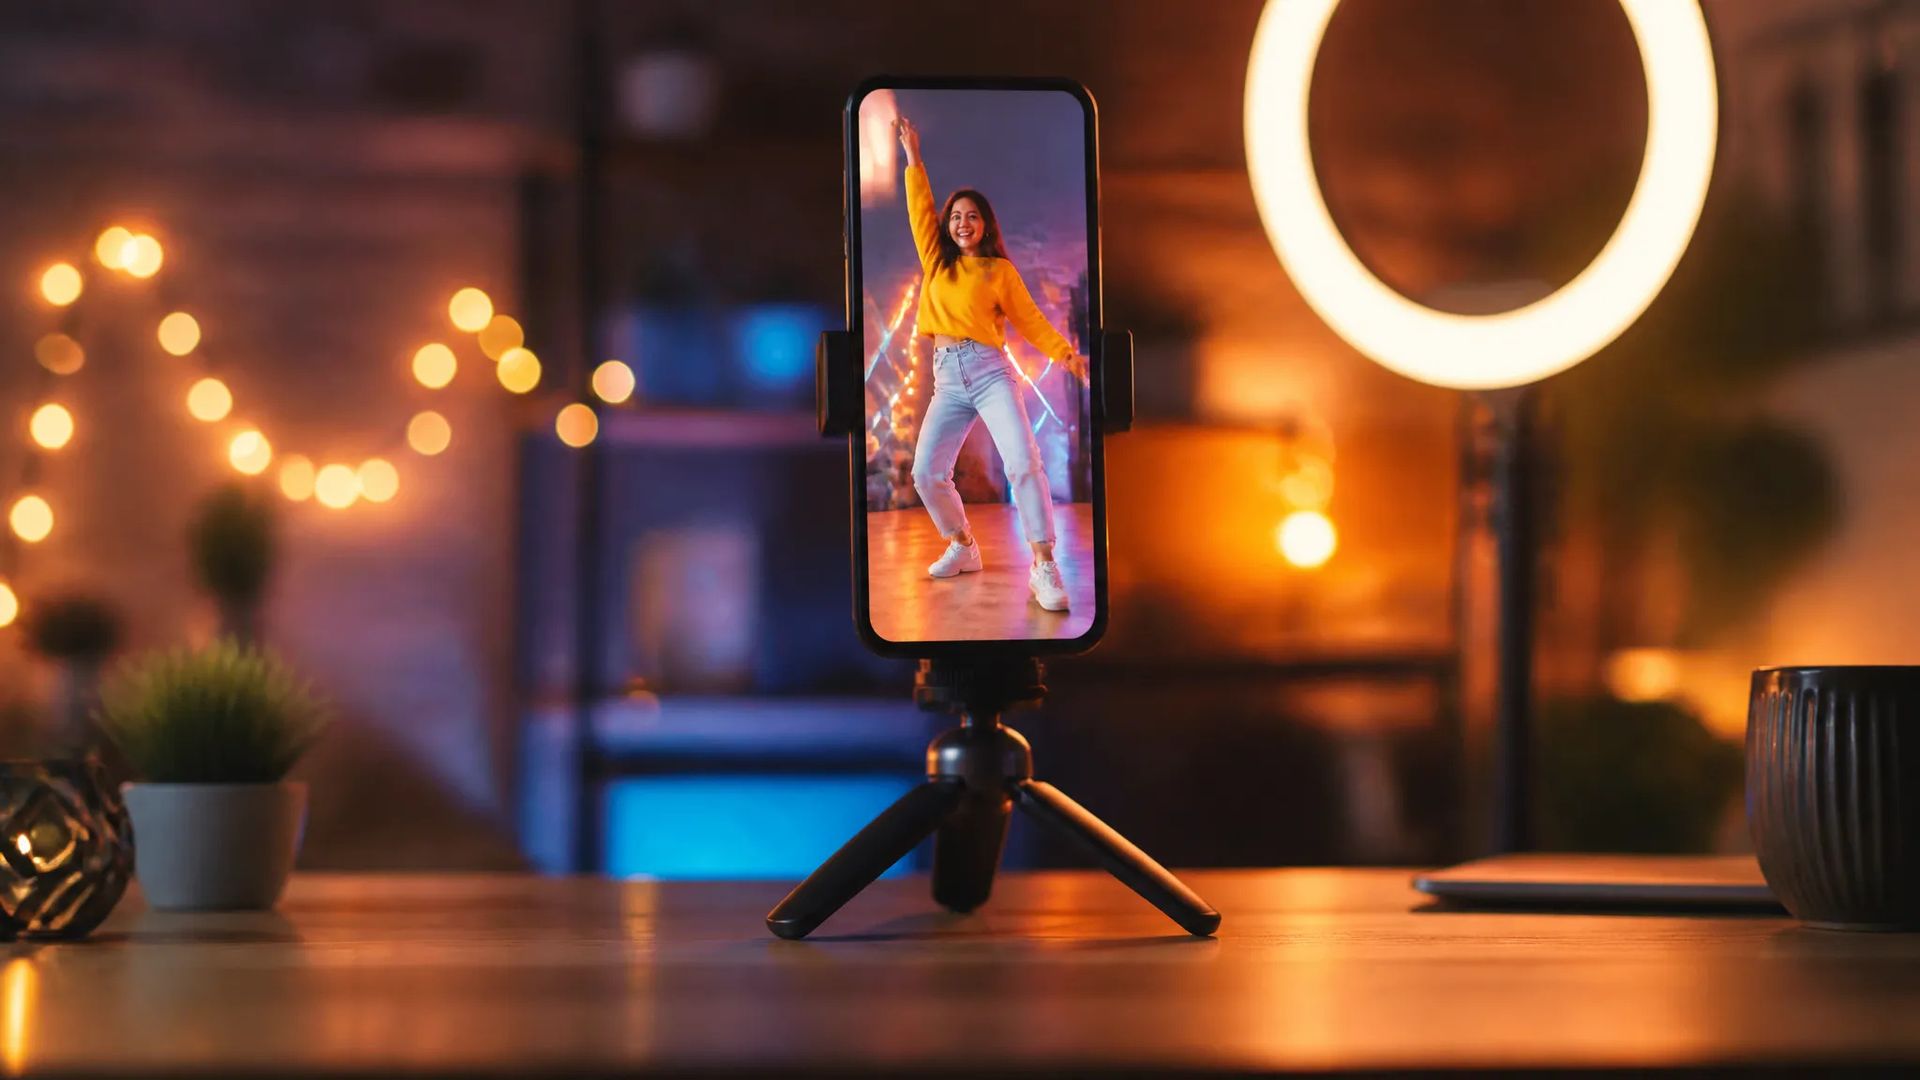
快速图生视频 + 原生音频,让 V1.5 成为 TikTok / Reels 类短片的理想选择——一张图一步变成带声竖屏短片。
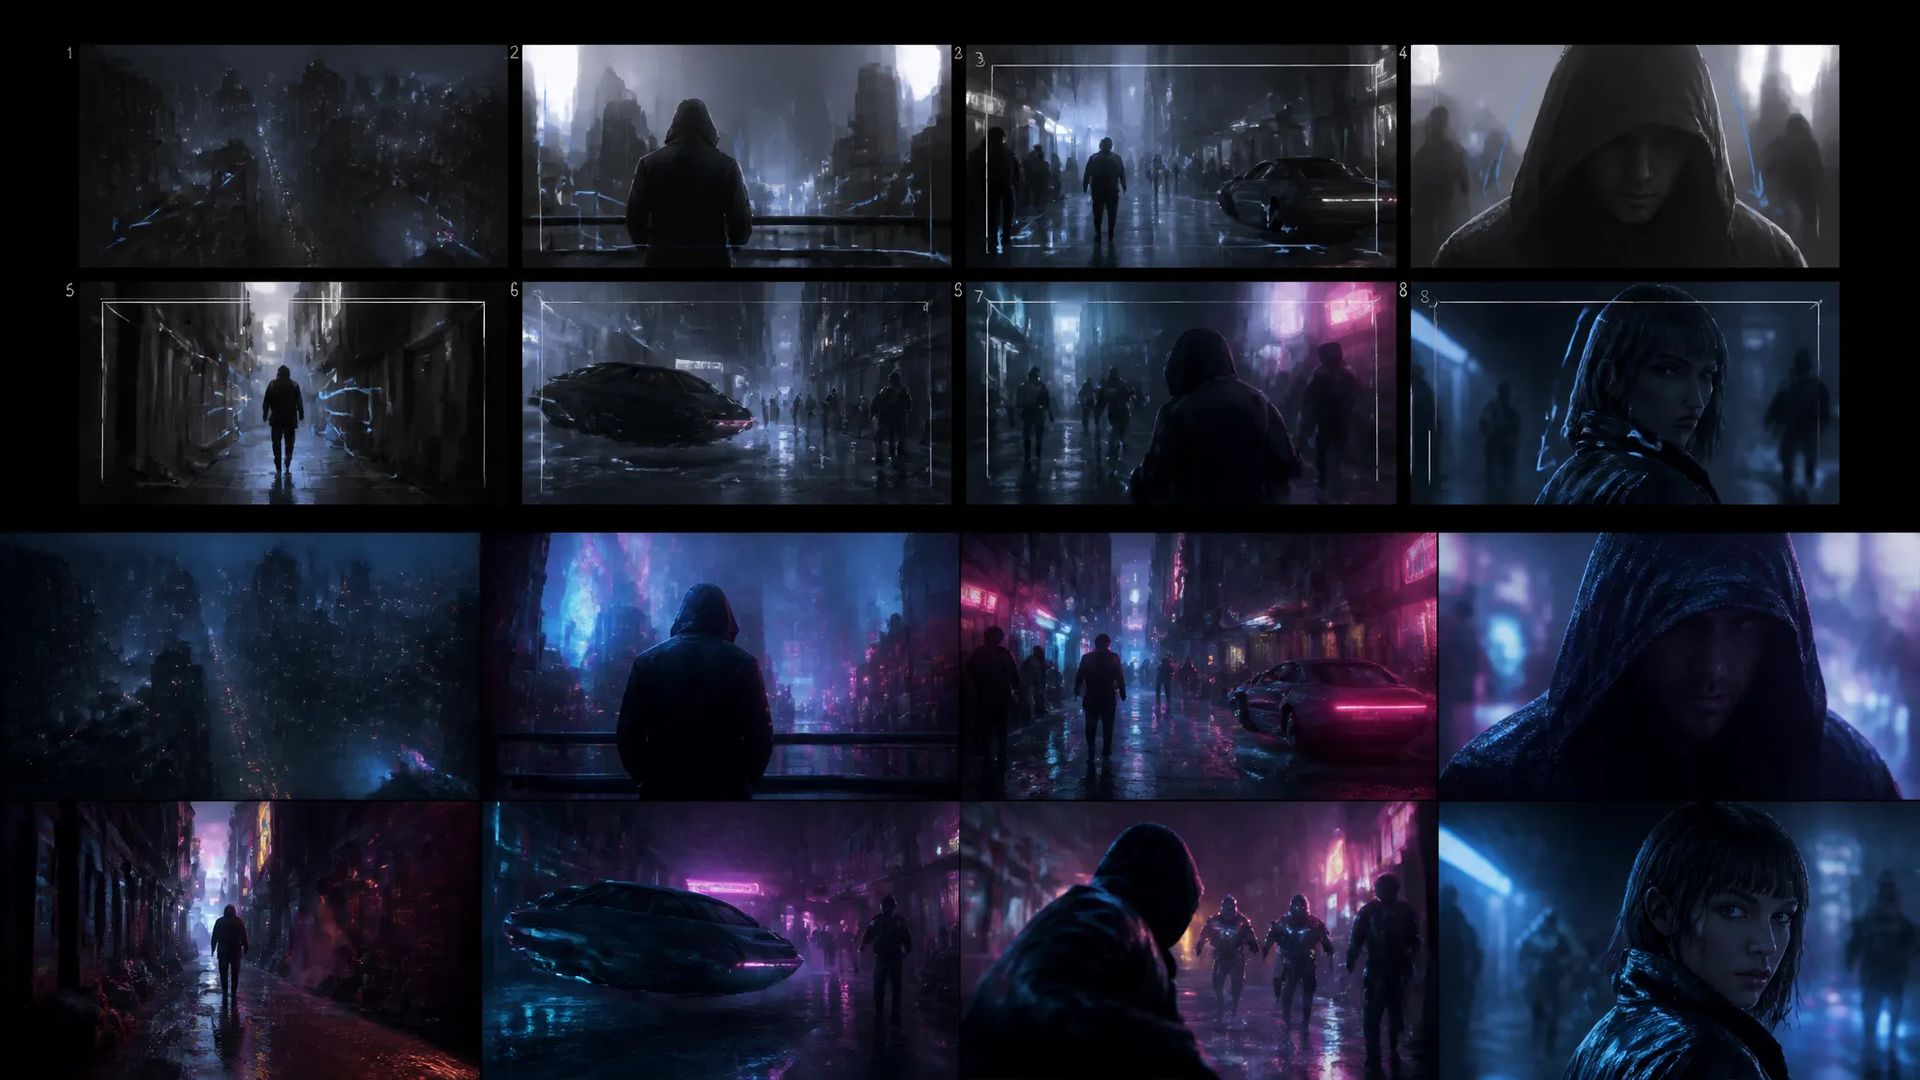
把一张场景概念图——比如霓虹闪烁的赛博朋克街道——动起来,在交给更重的模型出终稿前先看看这个节拍动起来读感如何。
按场景挑视频模型。积分在 ZOOOP 上所有模型通用。
从本页打开 Grok Imagine V1.5,选择模式:起始图,或者文字(可加参考图)。
上传起始图;或者写好场景,附上最多 7 张参考图。
写描述运动的 prompt,然后设定分辨率(720p 或 480p)和时长(1–15 秒)。
生成——原生同步音频随片一起出。
Grok Imagine V1.5 是 xAI 做带声短视频的模型。你可以给它一张起始帧和一段描述运动的 prompt,也可以从零写一段场景,或附上最多 7 张人物、产品或风格参考图,它在一次推理里生成运动——外加原生同步音频。预览阶段它在 Image-to-Video Arena 公开榜拿下第一,相比 1.0,在运动质量和「起始图如何忠实地延续进动态镜头」上都明显更强。
最突出的能力是原生同步音频。每段视频回来时都带着与画面一起生成的对白、环境音和音效,说话角色还有对口型。对一段带声社媒短片或说话头像视频,这把通常要三个工具的流水线——运动模型、再 TTS、再 Foley——压成一条 prompt。1.5 的第二个大提升是时间一致性:面部、主体、场景元素在整段视频里保持一致,不再逐帧漂移或扭曲——而这正是上一版最明显的短板。
成片 1 到 15 秒、720p 或 480p,出片快,所以试一个运动想法、带声看一眼、再重出都很快。这种短的、带声的镜头正是它的甜点区。
它弱在哪:V1.5 不生成静态图片,所以如果想让某张特定的画面动起来,先用原版 Grok Imagine 或别的图像模型出图再喂进来。分辨率上限 720p,不是 1080p 或 4K 的收尾模型——要高分辨率交付,Kling V3 或 Seedance V2.5 是更对的目标。而且它动的是单个镜头,不是多镜头切换序列;要带硬切的分镜视频,换 Kling V3。
一个合理的心理模型:只要任务是「让这张图动起来,带声」或「把这个场景拍出来,带声」,就选 Grok Imagine V1.5——说话角色、产品动效、社媒原生短片、快速预演。等需要更高分辨率或多镜头剪辑时,把这个镜头交给更重的视频模型走终稿。
它是 xAI 带原生同步音频的视频模型。给一张起始图和一段 prompt 就能让静图动起来;写一段场景就能文生视频;再加最多 7 张参考图,能让人物、产品或风格保持一致。它不生成静态图片。
带——每段视频都在同一次推理里附带原生同步音频(对白、环境音、音效),说话角色还带对口型。无需单独的 TTS 或 Foley 步骤。
输出 720p 或 480p,时长 1 到 15 秒(默认 5 秒)。文生和参考模式支持 16:9、4:3、3:2、1:1、3:4、2:3、9:16;起始图模式跟随起始图的比例。它是为带声短镜头打造的,不面向长视频或 4K 交付。
V1.5 是更新的视频模型——预览阶段在 Image-to-Video Arena 拿第一,时间一致性和音频都比 1.0 更好,并且图生视频、文生视频、参考图都支持。原版 Grok Imagine 还能生成和编辑静态图,也能编辑或续写视频。要画面最好的带声短片用 V1.5;要出图,或想一个模型走图像加视频流程,用原版。
对带声短片很划算——原生音频在同一次推理里生成,省掉了普通流水线里单独的配音、配乐、音效步骤。但要 1080p 收尾或多镜头序列,更重的视频模型才是更值的花法。
首尾帧生成视频文字 / 参考图生成视频
首尾帧生成视频文字 / 参考图生成视频
首尾帧生成视频文字 / 参考图生成视频
首尾帧生成视频文字 / 参考图生成视频
首尾帧生成视频文字 / 参考图生成视频
首尾帧生成视频文字 / 参考图生成视频
Grok Imagine V1.5
Prompt*
首帧*
视频分辨率*
时长*
登录后,你的生成结果会出现在这里。
创建账号免费。