Google

Gemini Omni 1.2 Flash

Google 最新视频模型:单条最长 15 秒、原生音频、参考图更稳,生成、编辑、续写一个模型搞定。

积分包或订阅
积分包永不过期
了解更多

积分包或月度订阅,一份余额通用 ZOOOP 所有模型。 · 按需充值,积分包的积分用完为止。

Powered by Google's API on ZOOOP

核心能力

一条 15 秒,一次生成

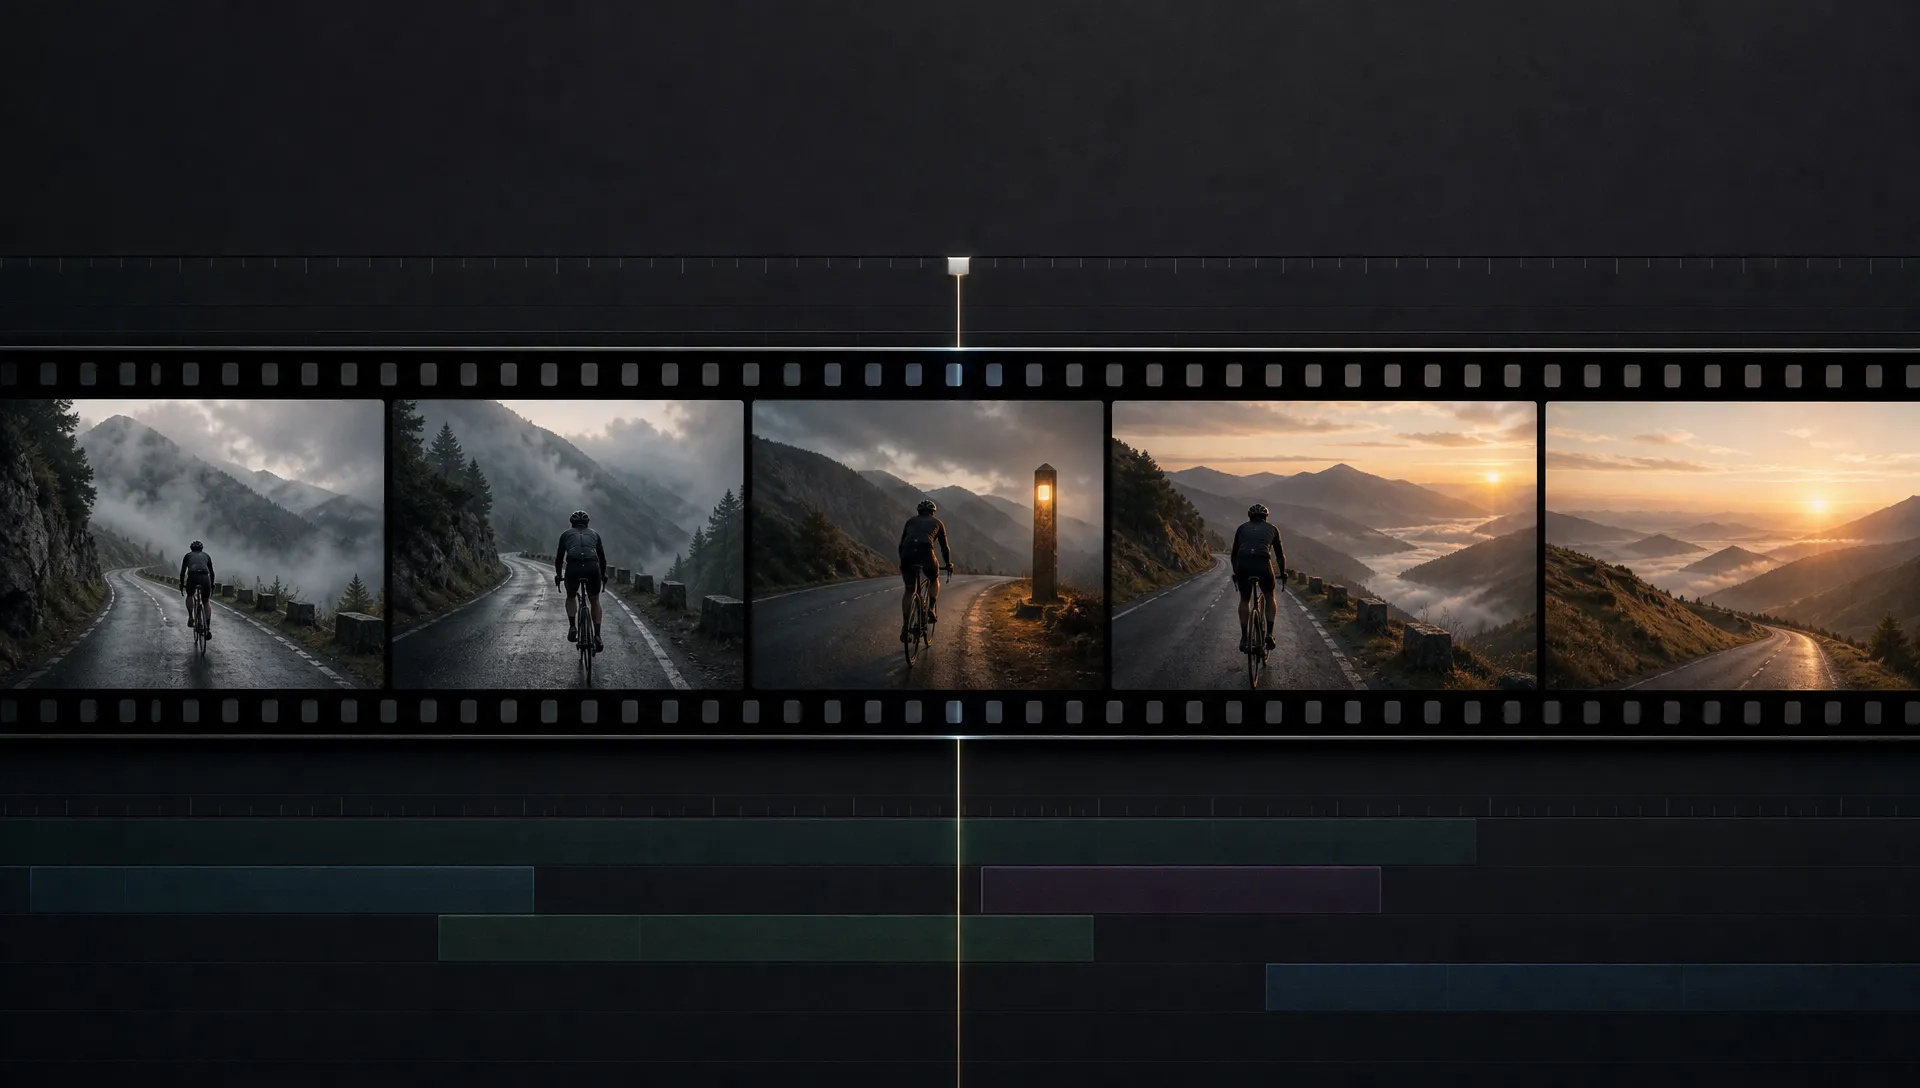
时长 3 到 15 秒,按秒选。一条完整的社媒广告、一段产品讲解、一个有起承转合的小场景,一次就能生成,不用再拼三段。

参考图一直稳到最后一帧

最多 10 张角色、产品或场景参考图,再加最多 3 段、每段 3 秒的动作参考。脸、衣服、包装文字和品牌色在运镜过程中保持不变,比 Omni 1.1 漂得更少。

改完还能接着改

一句话换背景、换天气、换光线或换衣服,源视频最长 15 秒。对改好的结果再改一次,一步步做出多个广告版本,不用从头重新生成。

原生音频,对白更自然

对白、音效、环境音和画面在同一次生成里出来。1.2 的台词更自然,口型更清楚,多人说话时声音也分得更开。

使用场景

一条完整的 15 秒广告

一条完整的 15 秒广告

开场出产品、中段展示使用、结尾落在主视觉,一次生成,音乐和音效都对得上。
一镜到底的运镜

一镜到底的运镜

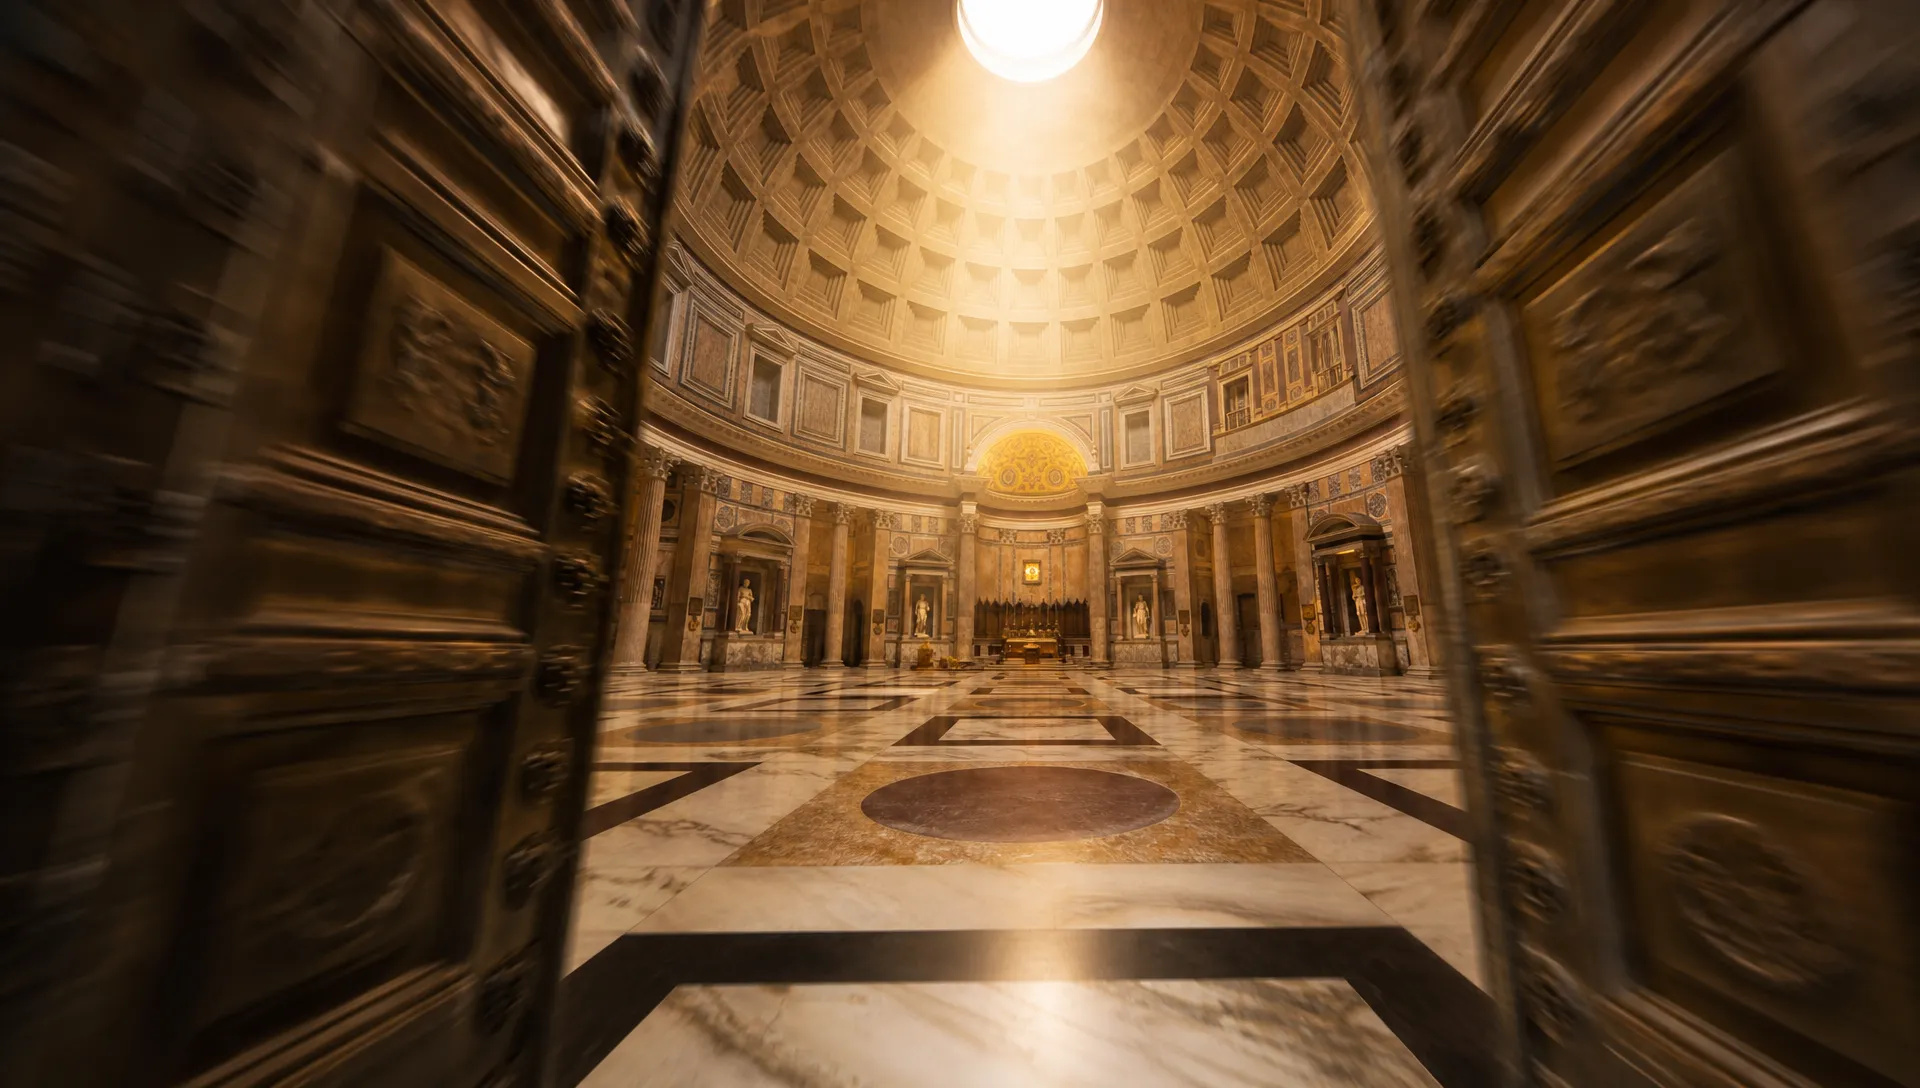
FPV 无人机穿门而过、绕雕像环绕、从特写拉到城市全景,意外的跳剪明显更少。
用商品图做虚拟试穿

用商品图做虚拟试穿

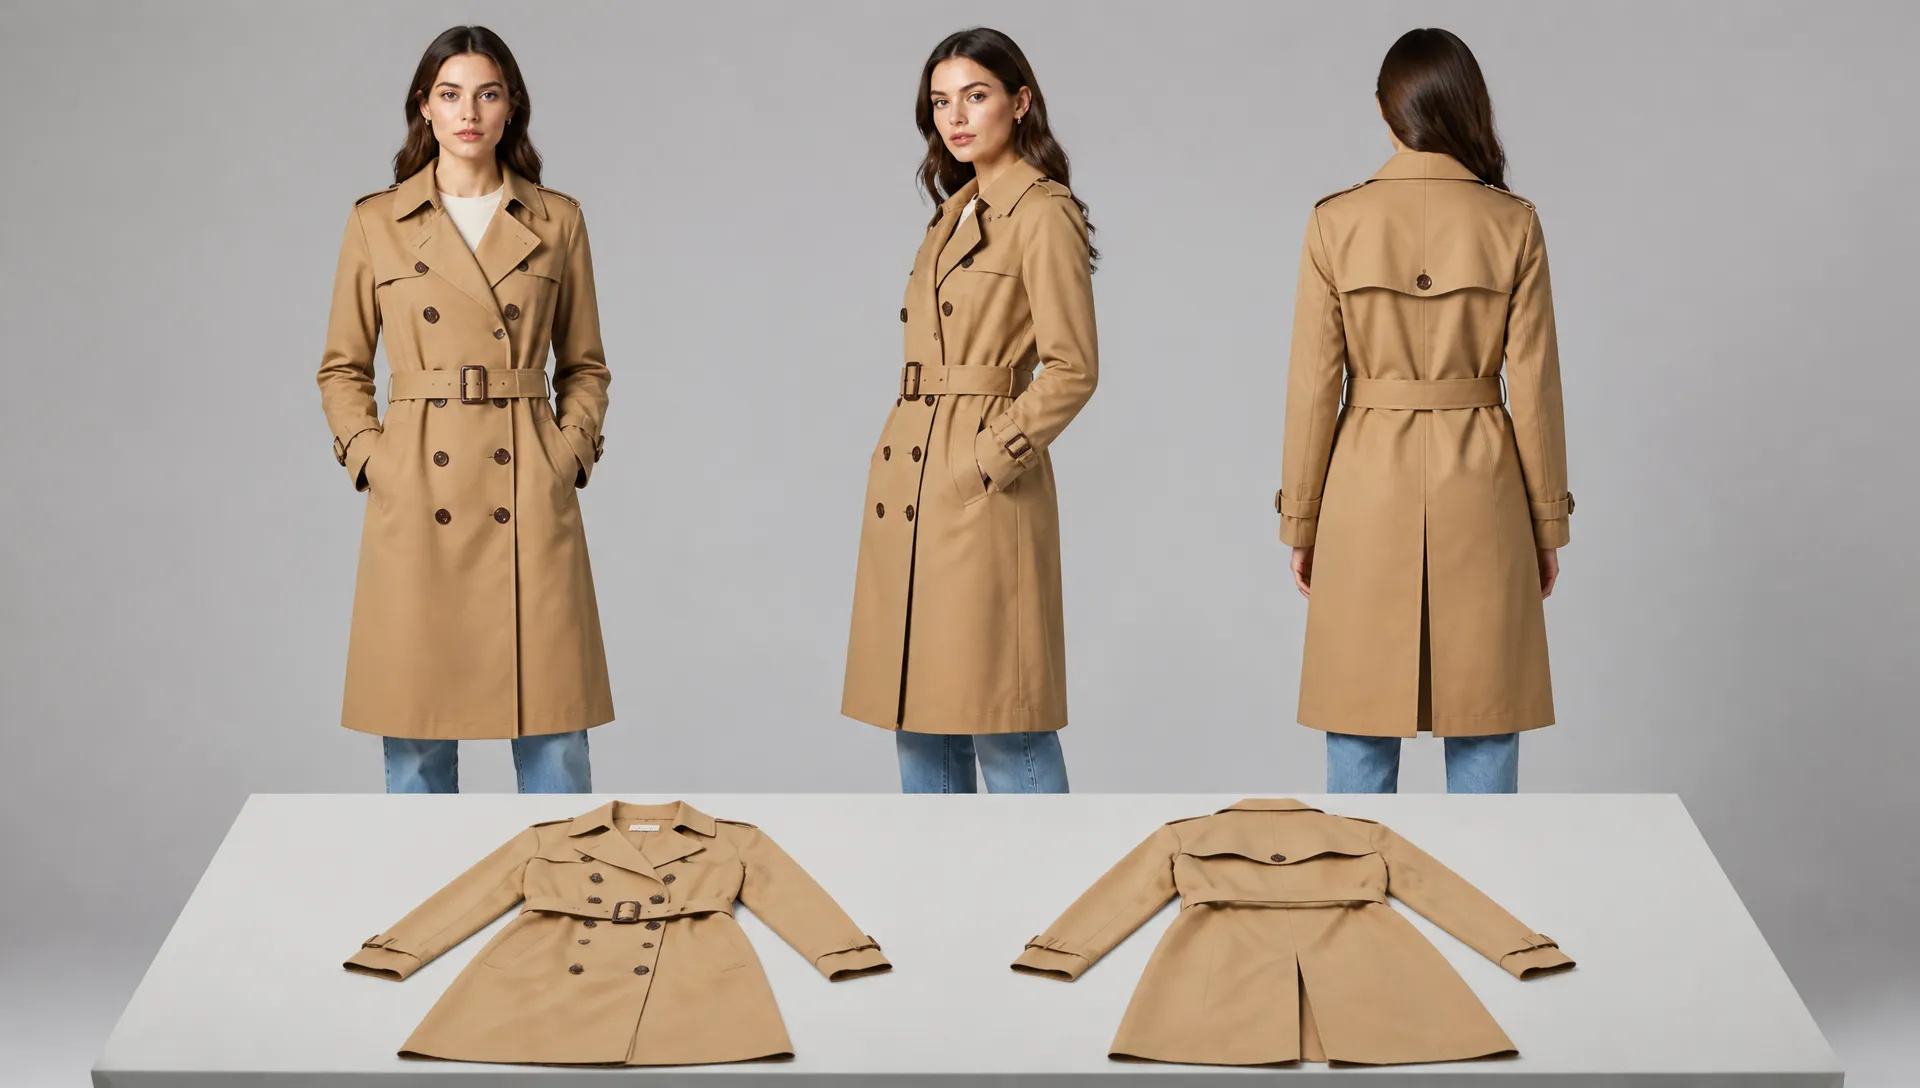
一张模特照加一套衣服的正反面图,生成一段转身展示,剪裁、垂感和背面细节都对得上。
首尾帧过渡

首尾帧过渡

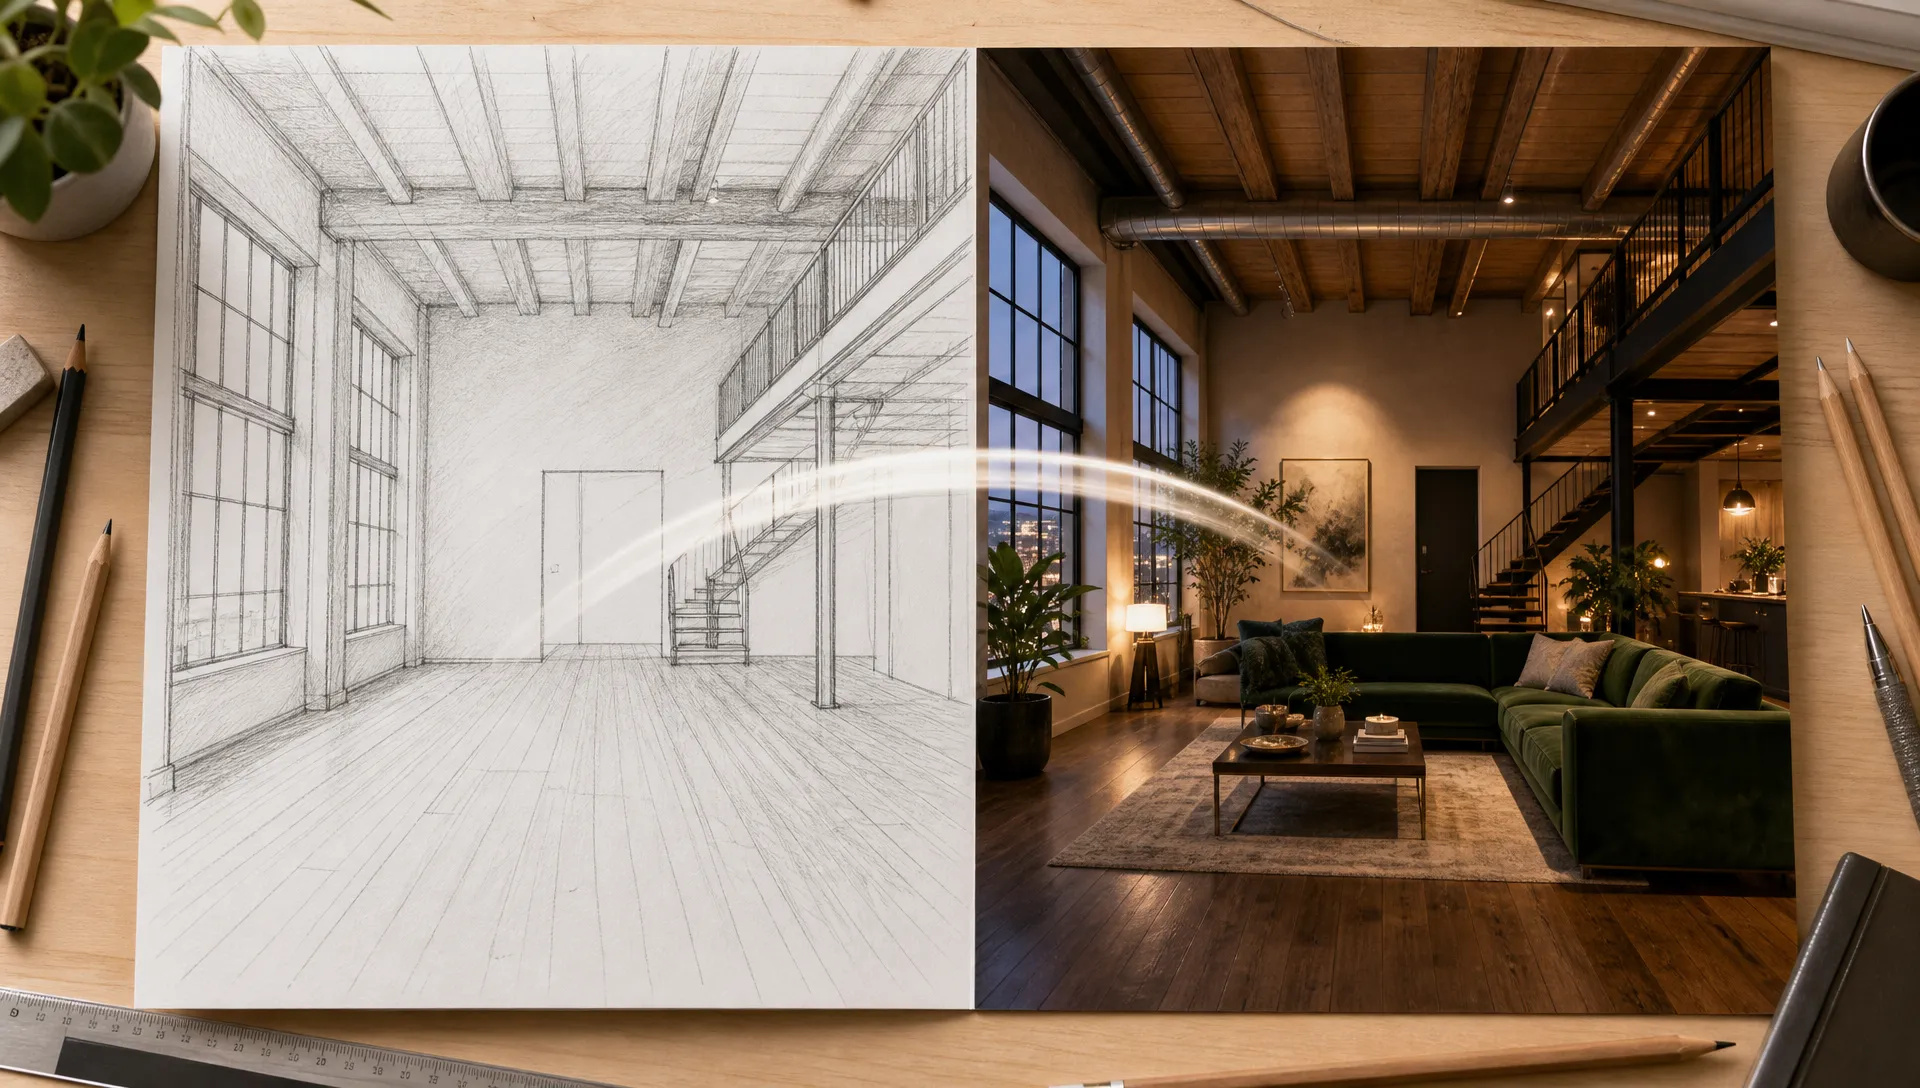
给一张首帧和一张尾帧(草图和装修好的房间、没拆的盒子和打开后的产品),中间的变化交给模型。
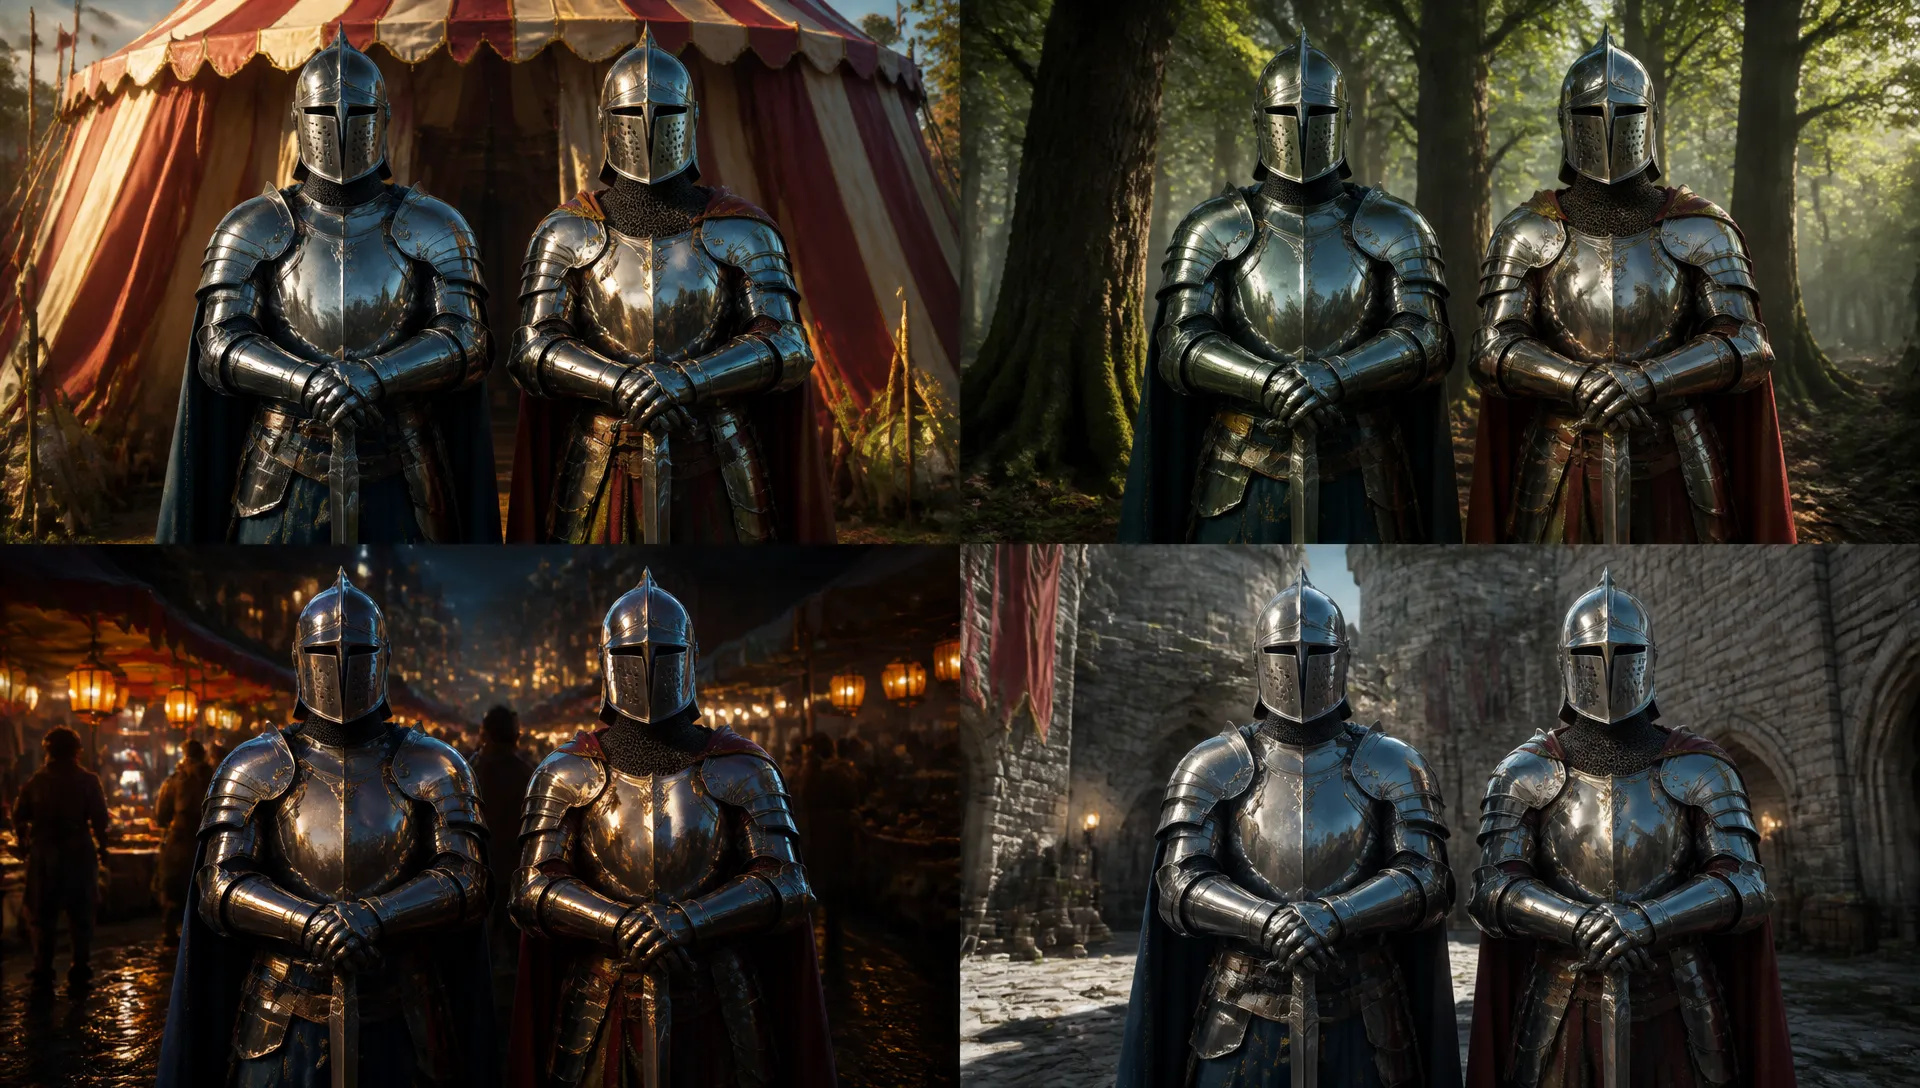
一次改一处,做出多个版本

一次改一处,做出多个版本

演员和机位不动,几次编辑把背景从影棚换成森林、再换成夜市。

任何片子都能续

任何片子都能续

在视频结尾再加 3 到 10 秒:模型参照最后 10 秒往下接,人接着走,声音也接得上。

如何选对模型

Gemini Omni 1.2 Flash 是全能型:一个模型就能生成、编辑、续写带声音的视频,现在单条最长 15 秒。镜头需要它做不到的事时,再换模型。

生成、编辑、续写 15 秒带原生音频的视频Gemini Omni 1.2 Flash ←
把某个人换进已有的视频MiniMax H3
单条最长 30 秒、方形或 4:3 画幅Wan V3.0
多镜头叙事、编辑最长 30 秒的视频Seedance V2.5
把舞者的动作原样搬到角色身上Kling V3 Pro
一张照片加一段配音做数字人口播Kling Avatar V2

如何使用

01

在本页打开 Gemini Omni 1.2 Flash,选模式:文生或参考、首帧、编辑、续写。

02

用自然语言写镜头,包括运镜,以及想要或不想要的声音(英文提示词效果最好)。

03

选时长(3 到 15 秒)、画幅(16:9 或 9:16)和分辨率(360p 到 4K)。

04

生成,再对结果做编辑,或把满意的 360p 草稿换到更高分辨率重出。

深入了解

Gemini Omni 1.2 Flash 擅长什么,不擅长什么

Gemini Omni 1.2 Flash 延续了 Omni 1.1 最有用的地方:一个模型同时负责生成、编辑和续写,声音和画面在同一次生成里出来,同时去掉了大家最先碰到的限制:时长。Google 在 2026 年 11 月 5 日发布 1.2,单条最长 15 秒,参考图跟得更紧,对白更自然,价格也更低。从 2026 年 12 月 3 日起,Google 会把所有 Omni 1.1 的请求自动转到 1.2,所以新项目直接用 1.2 就好。

第一个关键变化是 15 秒生成。时长从 3 到 15 秒按秒选,足够放下一条完整的社媒广告:开场、产品使用、结尾主视觉,配乐和画面同步,不用拼三段再祈祷光线对得上。我们实测的一条 15 秒竖版视频一次生成,声音全程连贯。

第二个是 参考图更稳。可以加最多 10 张图(角色的多个角度、产品、场景)和最多 3 段、每段 3 秒的动作参考。Google 专门让 1.2 从第一帧到最后一帧保持脸、衣服、包装文字和品牌色一致,运镜时的变形也更少。这让"用商品正反面图做虚拟试穿""产品 360 度展示""用现成角色设定图做广告"变得可行。

第三个是 编辑可以循环做。上传最长 15 秒的视频,描述要改的地方:条纹帐篷换成橡树林,晴天街道变成雨天,卫衣换成皮夹克。演员、构图和节奏保持不变。改出来的结果本身就是一条新视频,可以再改一次,这正是 Google 演示的"多轮对话式编辑",也是用一条素材做出多个投放版本的办法。续写从另一头入手:它参照任何视频的最后 10 秒,再接 3 到 10 秒,声音也接得上。

运镜也更好控制。长的一镜到底(FPV 穿门、环绕、慢慢拉远)比 1.1 少了很多不想要的跳剪。

不足的地方:画幅只有 16:9 和 9:16,加尾帧时最长 10 秒,声音总是开着,只能引导不能关。1080p 和 4K 是从原生 360p、720p 放大来的。Google 的安全过滤比较严,部分知名人物的照片会被拒绝,要把特定的人换进已有视频,MiniMax H3 更合适。需要超过 15 秒的单条或方形画幅,Wan V3.0 能到 30 秒;要编辑超过 15 秒的视频,用 Seedance V2.5。

一个合理的用法:带声音、之后可能还要改的片子,默认用 Gemini Omni 1.2 Flash,因为同一个模型能接着编辑和续写自己生成的内容。要把人换进素材用 MiniMax H3,长镜头或方形画幅用 Wan V3.0,多镜头叙事用 Seedance V2.5,想要可灵的画面风格和原生 1080p 就用 Kling V4。

常见问题

Gemini Omni 1.2 Flash 有什么新东西?+

Google 在 2026 年 11 月 5 日发布了它。单条视频从最长 10 秒变成 15 秒,参考图从第一帧到最后一帧都跟得更紧,对白和口型更自然,连续运镜中不想要的跳剪更少。Google 也把价格比 Omni 1.1 下调了约 30%。

Gemini Omni 1.1 Flash 会怎样?+

Google 正在下线它:从 2026 年 12 月 3 日起,调用 Omni 1.1 的请求会自动转到 Omni 1.2。在 ZOOOP 上,1.2 覆盖了 1.1 能做的一切,片子更长、价格更低,没有理由再留在旧版本。

一条视频最长多久?+

文生、参考生和首帧生成是 3 到 15 秒,加了尾帧时最长 10 秒。编辑支持最长 15 秒的源视频,续写在片尾再加 3 到 10 秒。

能关掉声音吗?+

不能,声音总是会生成。可以在提示词里引导,比如写"不要对白""不要背景音乐",或者生成后静音。

4K 是原生的吗?+

不是。Omni 1.2 Flash 原生生成 360p 和 720p,1080p 和 4K 是从这些画面放大来的。探索阶段用 360p,满意的那版再用高分辨率重出。

上传素材有什么限制?+

最多 10 张参考图,参考视频最多 3 段、每段最长 3 秒,参考视频里的声音会被忽略。Google 的安全过滤对提示词和输出都生效,部分知名人物的照片会被拒绝,每条输出都带有 Google 肉眼不可见的 SynthID 水印。
更多模型

MiniMax
MiniMax H3
MiniMax
Wan AI
Wan V3.0
Wan AI
ByteDance
Seedance V2.5
ByteDance
Kling AI
Kling V4
Kling AI
OpenAI
GPT Image 2.6
OpenAI
OpenAI
GPT Image 2.5
OpenAI
OpenAI
GPT Image 2.0
OpenAI
ByteDance
Seedance V2.0
ByteDance
ByteDance
Seedance V2.0 Fast
ByteDance
ByteDance
Seedance V1.5 Pro
ByteDance
ByteDance
Seedance V1.0 Pro
ByteDance
ByteDance
Seedance V1.0 Pro Fast
ByteDance
ByteDance
Seedream 5.5
ByteDance
ByteDance
Seedream 5.0 Pro
ByteDance
ByteDance
Seedream 5.0 Flash
ByteDance
ByteDance
Seedream 5.0 Lite
ByteDance
ByteDance
Seedream 4.5
ByteDance
ByteDance
Seedream 4
ByteDance
ByteDance
Dreamactor V2
ByteDance
MiniMax
MiniMax H3 Max
MiniMax
MiniMax
Minimax Music V2.6
MiniMax
MiniMax
MiniMax H3 Max Turbo
MiniMax
MiniMax
Minimax Music V2
MiniMax
MiniMax
Speech-2.8-HD
MiniMax
MiniMax
Speech-2.8-Turbo
MiniMax
Kling AI
Kling O3
Kling AI
Kling AI
Kling V3
Kling AI
Kling AI
Kling V3 Pro
Kling AI
Kling AI
Kling V2.6 Pro
Kling AI
Kling AI
Kling V2.6
Kling AI
Kling AI
Kling Lipsync
Kling AI
Kling AI
Kling Avatar V2
Kling AI
Kling AI
Kling O1
Kling AI
Midjourney
Midjourney V8.2
Midjourney
Midjourney
Midjourney V8.1
Midjourney
Midjourney
Midjourney
Midjourney
Alibaba
Happy Horse V1.1
Alibaba
Alibaba
Happy Horse
Alibaba
xAI
Grok Imagine V1.5
xAI
xAI
Grok Imagine
xAI
xAI
xAI TTS
xAI
Google
Nano Banana 2.1
Google
Google
Nano Banana 2 Lite
Google
Google
Nano Banana Pro
Google
Google
Nano Banana 2
Google
Google
Nano Banana
Google
Google
Lyria 3 Pro
Google
Google
Lyria 3
Google
Google
Gemini 3.8 Flash TTS
Google
Google
Lyria2
Google
Google
Gemini 3.1 Flash TTS
Google
Wan AI
Wan V2.2
Wan AI
Wan AI
Wan V2.2 Turbo
Wan AI
Wan AI
Wan V2.5
Wan AI
Wan AI
Wan V2.6
Wan AI
Wan AI
Wan V2.6 Flash
Wan AI
Wan AI
Wan V2.7
Wan AI
Pixverse AI
Pixverse V6
Pixverse AI
Pixverse AI
Pixverse V5.5
Pixverse AI
Pixverse AI
Pixverse V5
Pixverse AI
Pixverse AI
Pixverse Lipsync
Pixverse AI
Vidu AI
Vidu Q4
Vidu AI
Vidu AI
Vidu Q3 Pro
Vidu AI
Vidu AI
Vidu Q3
Vidu AI
Vidu AI
Vidu Q3 Turbo
Vidu AI
Vidu AI
Vidu Q2 Pro
Vidu AI
Vidu AI
Vidu Q2 Turbo
Vidu AI
Flux AI
Flux 2 Pro
Flux AI
Flux AI
Flux 2
Flux AI
Flux AI
Flux 2 Flash
Flux AI
ElevenLabs
Eleven V4
ElevenLabs
ElevenLabs
Multilingual V3
ElevenLabs
ElevenLabs
Multilingual V2
ElevenLabs
ElevenLabs
Sound Effects V3
ElevenLabs
ElevenLabs
Sound Effects V2
ElevenLabs
Hailuo AI
Hailuo 2.3
Hailuo AI
Hailuo AI
Hailuo 2.3 Fast
Hailuo AI
Hailuo AI
Hailuo 02
Hailuo AI
Lightricks
LTX-2.3 Pro
Lightricks
Lightricks
LTX-2.3 Fast
Lightricks
Lightricks
LTX-2.3
Lightricks
Pika AI
Pika V2.2
Pika AI
Qwen
Qwen3-TTS
Qwen
Inworld
Inworld TTS
Inworld
Bilibili Index
Index TTS 2
Bilibili Index
Resemble AI
Chatterbox TTS Multilingual
Resemble AI
Open Source
ACE-Step
Open Source
Open Source
LUX TTS
Open Source
CassetteAI
Music Generator
CassetteAI
Recraft
Text to Vector V4.1
Recraft
Recraft
Text to Vector V4.1 Pro
Recraft
Recraft
Image to Vector
Recraft
Meta
Muse Image
Meta