静止画に命を吹き込む
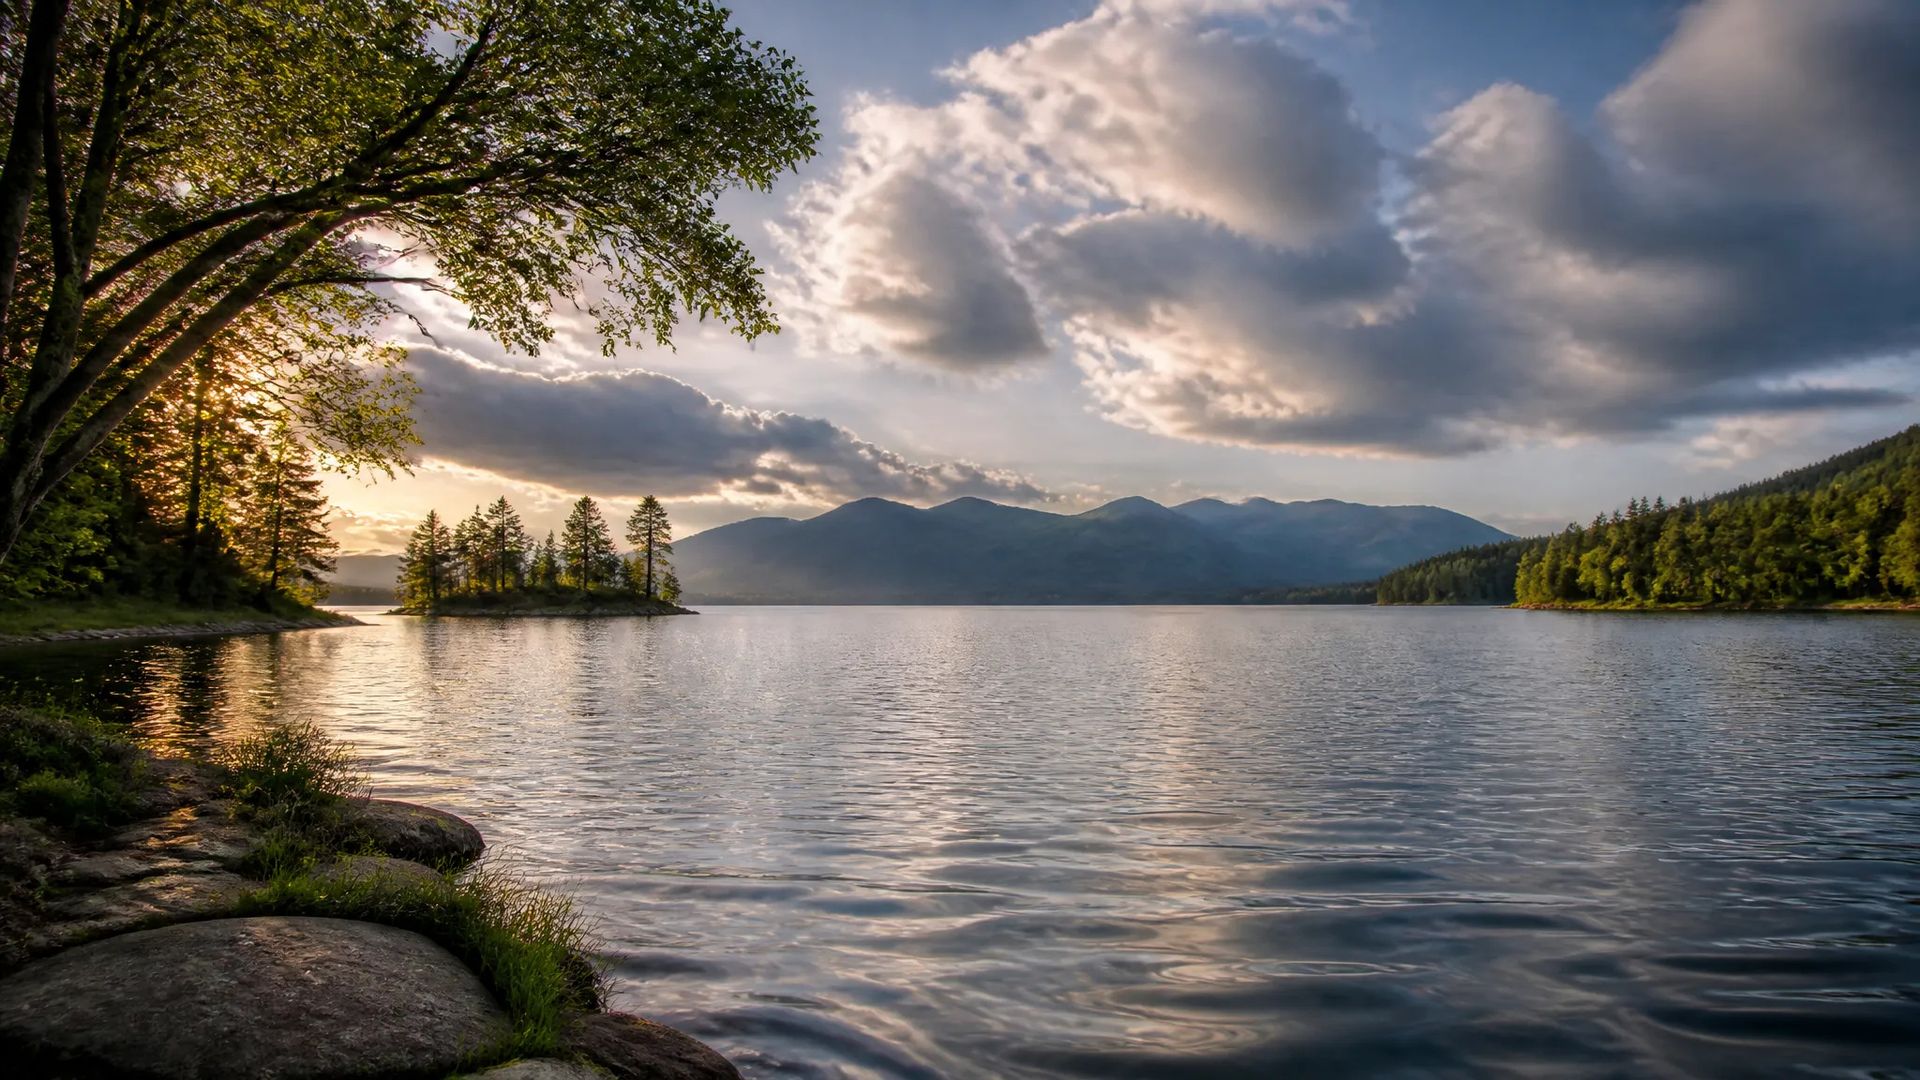
静止画を 1 枚——例えば静かな湖畔の風景——ドロップするだけで、Grok Imagine V1.5 が 1 回のパスでさざ波、揺れる枝、流れる雲に環境音を追加。キーフレーム作業不要。
xAI の Grok Imagine 1.5 動画モデル——静止画を動かす、シーンを文章で描く、最大 7 枚の参照画像でガイドする。そのすべてがネイティブ同期音声付き。
クレジットを一度支払う-ZOOOPのすべてのモデルで使用してください。 · 必要に応じて補充してください。毎月の負担はありません。
Powered by xAI's API on ZOOOP
Grok Imagine V1.5 はプレビュー段階で Image-to-Video Arena 公開リーダーボードの 1 位を獲得——1.0 と比較してモーション品質と「静止画が忠実に動画ショットへ変わる度合い」で明確な進化を遂げました。
すべてのクリップが同じパスで生成された同期音声付きで出荷——対話、環境音、効果音、話すキャラクターにはリップシンク付き。別途のモーションモデル、TTS、フォリーステップ不要。
1.5 の主要アップグレードは安定性——被写体、顔、シーン要素がクリップ全体で一貫性を保ち、フレーム間でドリフトやワープしません。
画像から、テキストだけから、または最大 7 枚の参照画像から始めて、720p または 480p で 1〜15 秒のクリップを生成。テキストモードと参照モードでは 16:9 から 9:16 まで 7 種類のアスペクト比を選べます。
静止画を 1 枚——例えば静かな湖畔の風景——ドロップするだけで、Grok Imagine V1.5 が 1 回のパスでさざ波、揺れる枝、流れる雲に環境音を追加。キーフレーム作業不要。
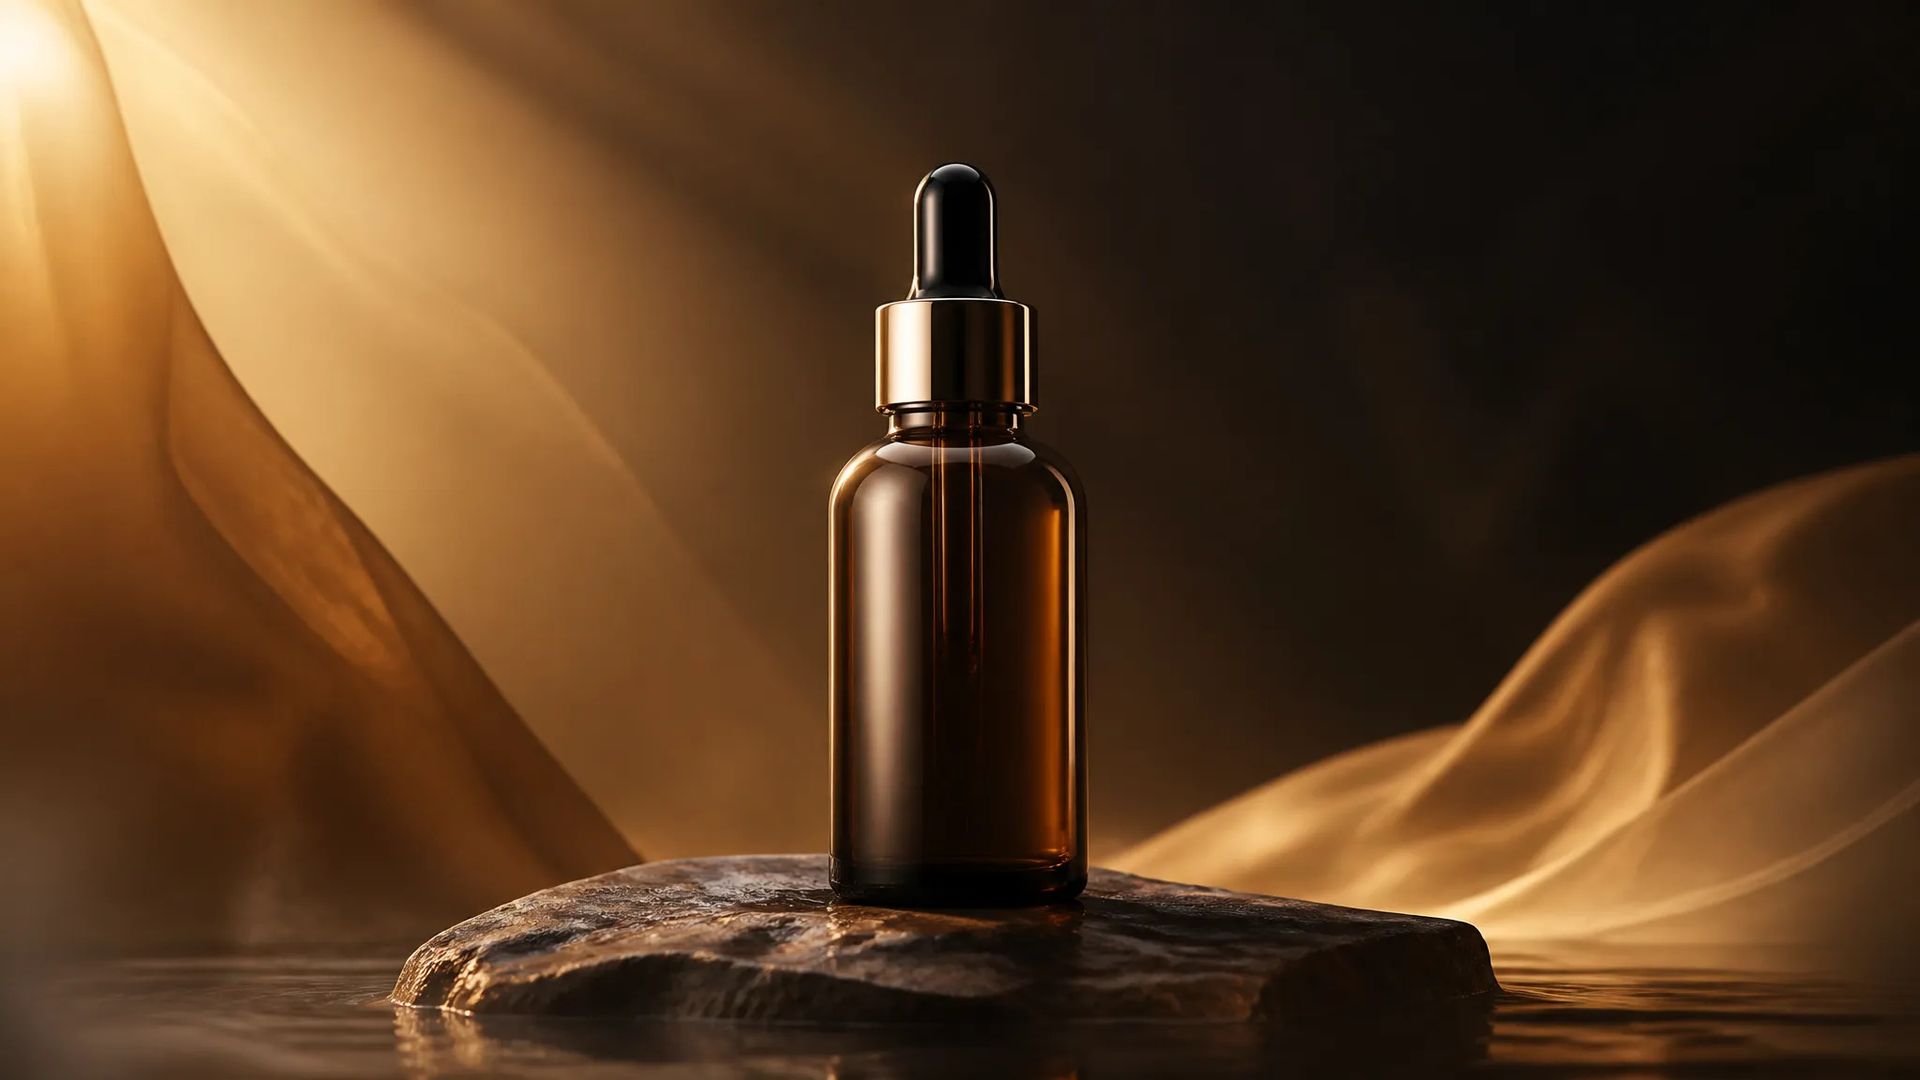
製品の静止画を短いリビールやループ回転に環境音付きで変換——撮影なしで EC 商品ページや SNS 投稿にそのまま使用可能。
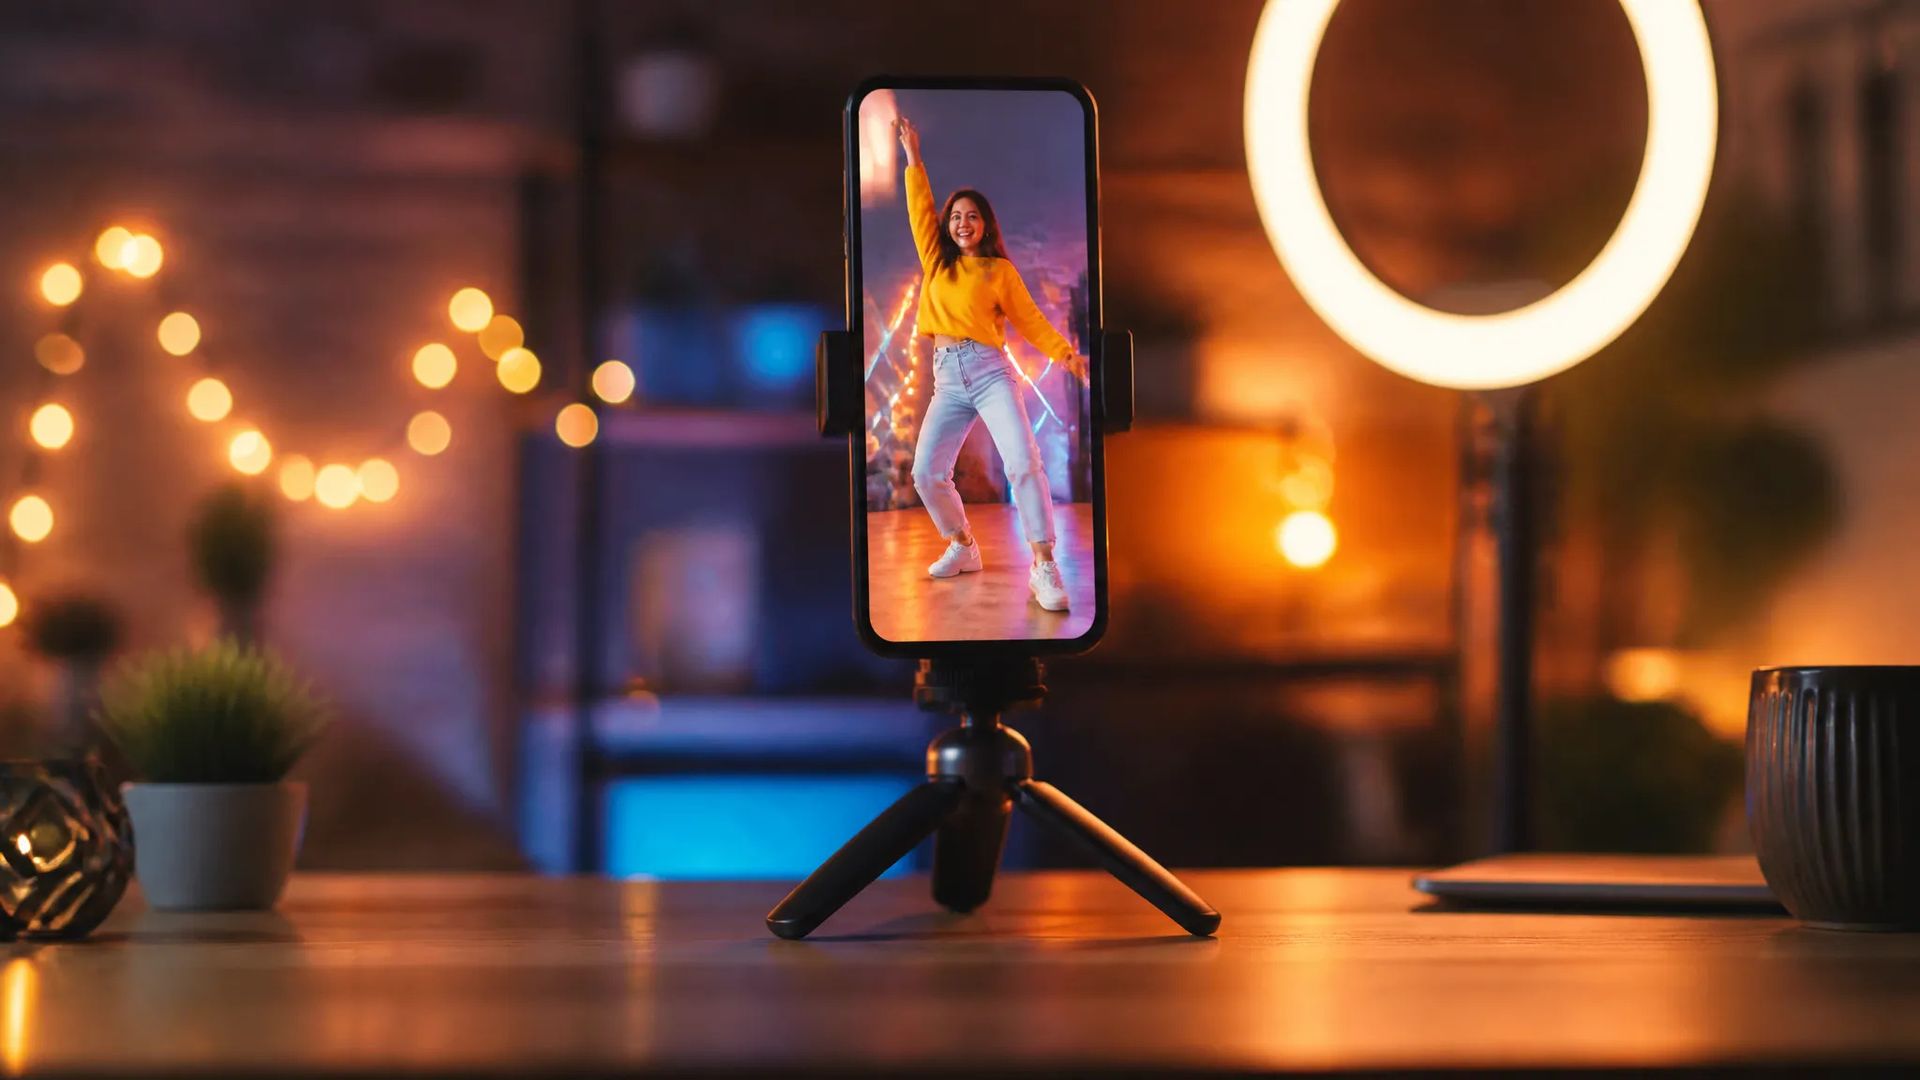
高速画像to動画+ネイティブ音声で、V1.5 は TikTok / Reels スタイルのショートに最適——1 枚のフレームを 1 ステップで音声付き縦型クリップにアニメ化。
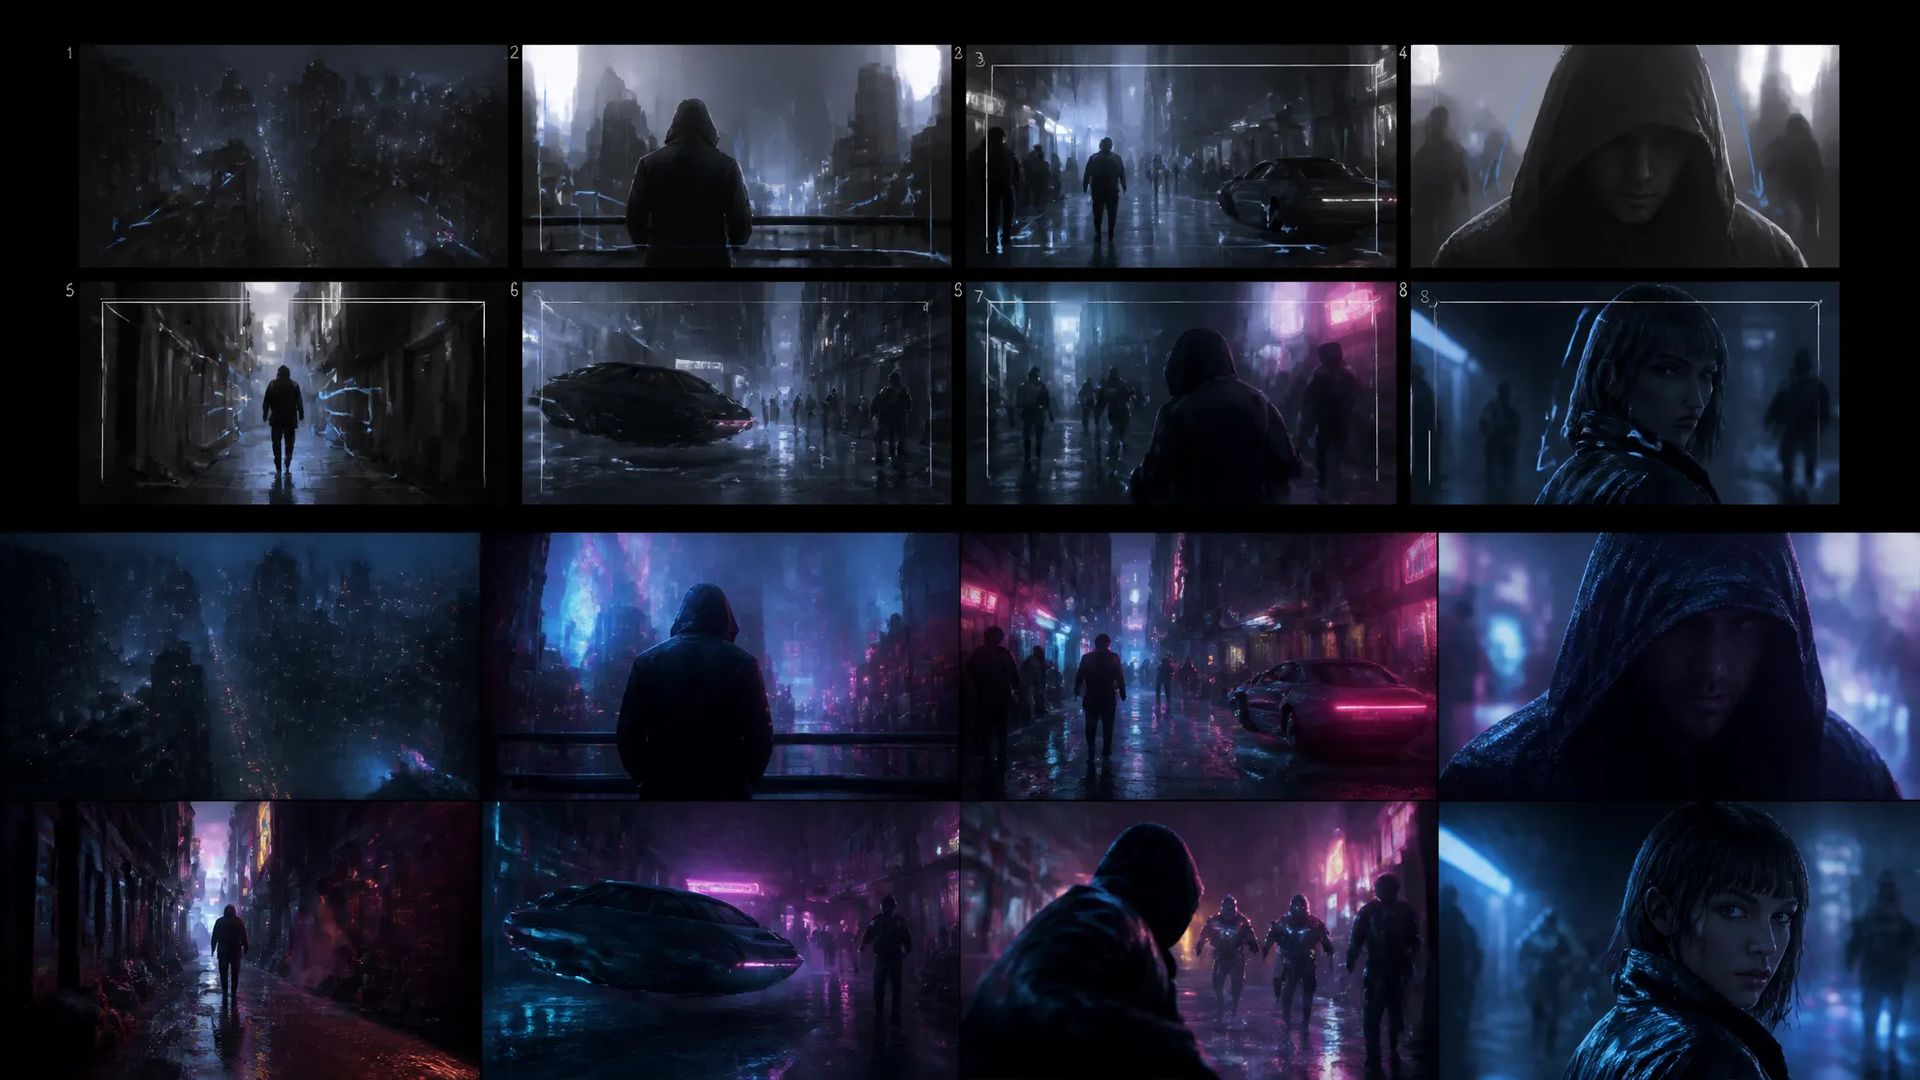
シーンコンセプト——例えばネオン輝くサイバーパンクの街——をアニメ化し、重いモデルに最終レンダリングを委託する前にモーションでの読みを確認。
作業に合った動画モデルを選びましょう。クレジットは ZOOOP 上のすべてのモデルで共通です。
このページから Grok Imagine V1.5 を開き、モードを選択:開始画像、またはテキスト(参照画像は任意)。
開始画像をアップロード、またはシーンを書いて最大 7 枚の参照画像を添付。
モーションを記述するプロンプトを書き、解像度(720p または 480p)と長さ(1〜15 秒)を設定。
生成——ネイティブ同期音声がクリップと一緒に出力されます。
Grok Imagine V1.5 は xAI の音声付き短尺動画クリップ向けモデルです。開始フレームとモーションを記述するプロンプトを与えるか、シーンをゼロから書くか、人物・製品・スタイルの参照画像を最大 7 枚添付すると、モーション——加えてネイティブ同期音声——を 1 回のパスで生成します。プレビュー段階で Image-to-Video Arena 公開リーダーボードの 1 位を獲得、1.0 と比較してモーション品質と「開始画像が動画ショットに忠実に継承される度合い」の両方で明確に強化されています。
際立った能力はネイティブ同期音声。すべてのクリップが映像と一緒に生成された対話、環境音、効果音付きで返却、話すキャラクターにはリップシンク付き。音声付きソーシャルショートやトークヘッドクリップにとって、これは通常 3 つのツールのパイプライン——モーションモデル、次に TTS、次にフォリー——を 1 つのプロンプトに圧縮します。1.5 のもう 1 つの大きな進歩は時間的一貫性:顔、被写体、シーン要素がクリップ全体で一貫性を保ち、フレームごとのドリフトやワープがなくなり、これは以前のバージョンで最も目立った弱点でした。
クリップは1〜15 秒、720p または 480pで高速に返却、モーションアイデアを試し、サウンド付きで確認し、再生成するのが素早い。この短く、音声付きのショットがまさにスイートスポットです。
弱い点:V1.5 は静止画を生成しないため、特定のフレームをアニメ化したい場合は、まずオリジナル Grok Imagine や別の画像モデルで生成してから投入。解像度は最大 720pで、1080p や 4K の仕上げモデルではない——高解像度納品には Kling V3 や Seedance V2.5 がより適切。そして単一ショットをアニメ化し、マルチカットシーケンスは対象外;ハードカットのあるストーリーボード動画には Kling V3 に切り替え。
合理的なメンタルモデル:「この画像を動かす、音声付き」や「このシーンを見せる、音声付き」がタスクなら Grok Imagine V1.5 を選択——話すキャラクター、製品モーション、SNS ネイティブショート、高速プレビズ。より高い解像度やマルチショット編集が必要になったら、このショットをより重い動画モデルに卒業させて仕上げ。
xAI のネイティブ同期音声付き動画モデルです。開始画像とプロンプトを与えればその静止画をアニメ化、シーンを書けばテキストto動画、最大 7 枚の参照画像を加えれば人物・製品・スタイルを一貫させられます。静止画は生成しません。
はい——すべてのクリップが同じパスで生成されたネイティブ同期音声(対話、環境音、効果音)付きで出荷、話すキャラクターにはリップシンク付き。別途の TTS やフォリーステップは不要です。
出力は 720p または 480p、クリップは 1〜15 秒(デフォルト 5 秒)。テキストモードと参照モードは 16:9、4:3、3:2、1:1、3:4、2:3、9:16 に対応し、画像モードは開始画像の縦横比に従います。長尺動画や 4K 納品向けではなく、音声付き短いショット用に設計されています。
V1.5 は新しい動画モデル——プレビュー段階で Image-to-Video Arena の 1 位を獲得、1.0 より時間的一貫性と音声が優れ、画像to動画、テキストto動画、参照画像のすべてに対応します。オリジナル Grok Imagine は静止画の生成・編集もでき、動画の編集や延長も可能です。音声付きで最も見栄えのよい短いクリップには V1.5 を、画像生成や 1 モデルで画像+動画を回したい場合はオリジナルを使用。
音声付き短いクリップには優れた価値——ネイティブ音声が同じパスで生成されるため、一般的なパイプラインで必要な別途のボイス、ミュージック、効果音ステップをスキップ。1080p 仕上げやマルチショットシーケンスには、より重い動画モデルが適切な投資です。
最初と最後のフレームビデオテキストとビデオへの参照
最初と最後のフレームビデオテキストとビデオへの参照
最初と最後のフレームビデオテキストとビデオへの参照
最初と最後のフレームビデオテキストとビデオへの参照
最初と最後のフレームビデオテキストとビデオへの参照
最初と最後のフレームビデオテキストとビデオへの参照
Grok Imagine V1.5
Prompt*
スタートフレーム*
解像度*
デュレーション*
サインインすると、あなたの世代がここに表示されます。
アカウントの作成は無料です。