Erzählung und Erklärvideos
Vertonen Sie ein Produktvideo, ein Kursmodul oder einen Dokumentarfilmabschnitt mit einem natürlichen, gleichbleibenden Vortrag.
ElevenLabs' ausdrucksstärkstes Sprachmodell: über 90 Sprachen, Audio-Tags, die der Reihe nach greifen, und eine schnelle, günstige Turbo-Version.
Credit-Pakete oder ein Monatsabo, ein Guthaben für alle Modelle auf ZOOOP. · Laden Sie bei Bedarf auf; Paket-Credits bleiben, bis Sie sie verwenden.
Powered by ElevenLabs's API on ZOOOP
Setzen Sie Tags wie [laughs], [whispers] oder [sighs] direkt in den Text. Eleven V4 folgt einer Abfolge von Tags zuverlässiger als v3, sodass eine Zeile ruhig beginnen, in ein Lachen ausbrechen und im Flüsterton enden kann.
Sprache in mehr als 90 Sprachen mit denselben Stimmen, wobei die emotionale Bandbreite über Sprachgrenzen hinweg erhalten bleibt.
Standard ist die ausdrucksstärkste. Turbo behält fast denselben Vortrag zu einem deutlich niedrigeren Preis bei und liefert das Audio schneller, was zu langen Skripten und Entwürfen passt.
Zwanzig ausgewählte Stimmen und ein Stabilitätsregler: Senken Sie ihn für einen lebendigeren Vortrag, erhöhen Sie ihn, damit jede Zeile einer langen Erzählung gleich klingt.
Vertonen Sie ein Produktvideo, ein Kursmodul oder einen Dokumentarfilmabschnitt mit einem natürlichen, gleichbleibenden Vortrag.
Geben Sie jeder Figur eine andere Stimme und setzen Sie Tags für Lachen, Seufzen und Flüstern direkt in die Zeilen.
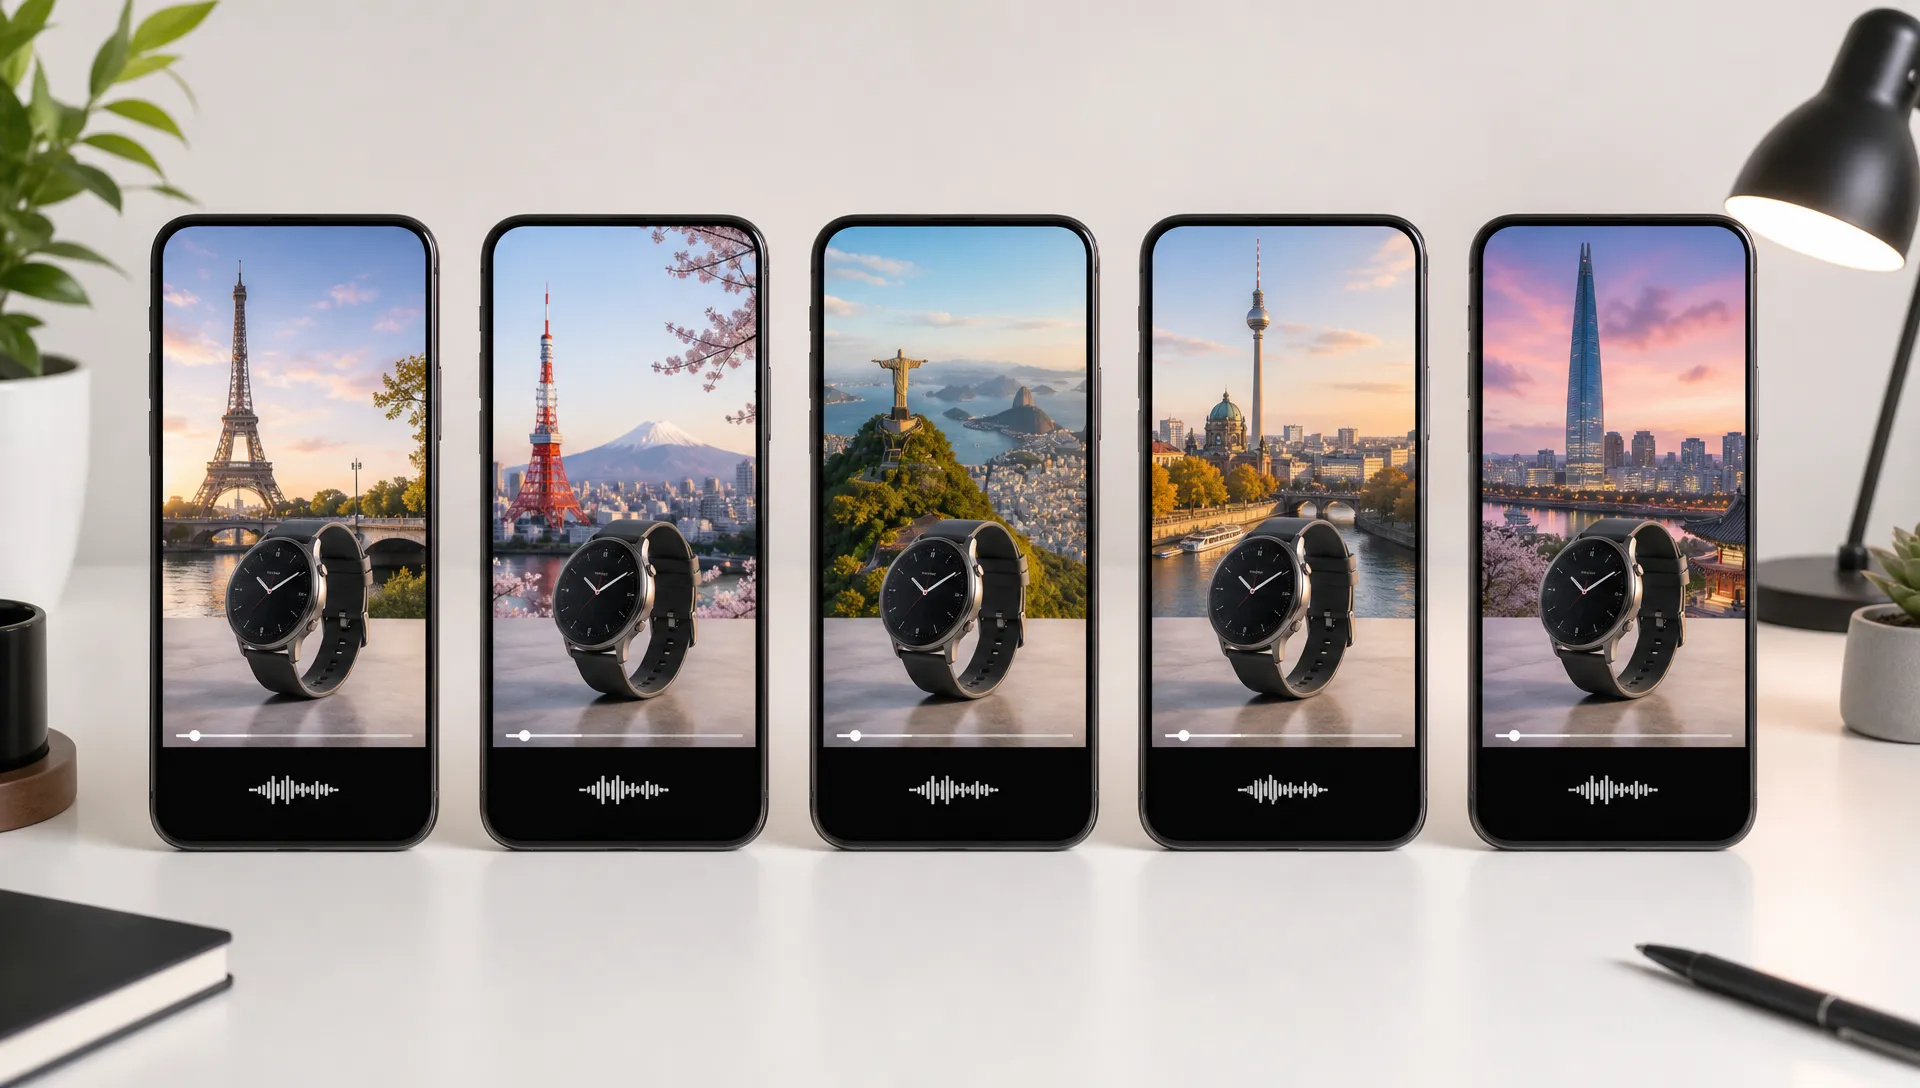
Lesen Sie dasselbe Skript in mehreren Sprachen mit derselben Stimme für jeden Markt.
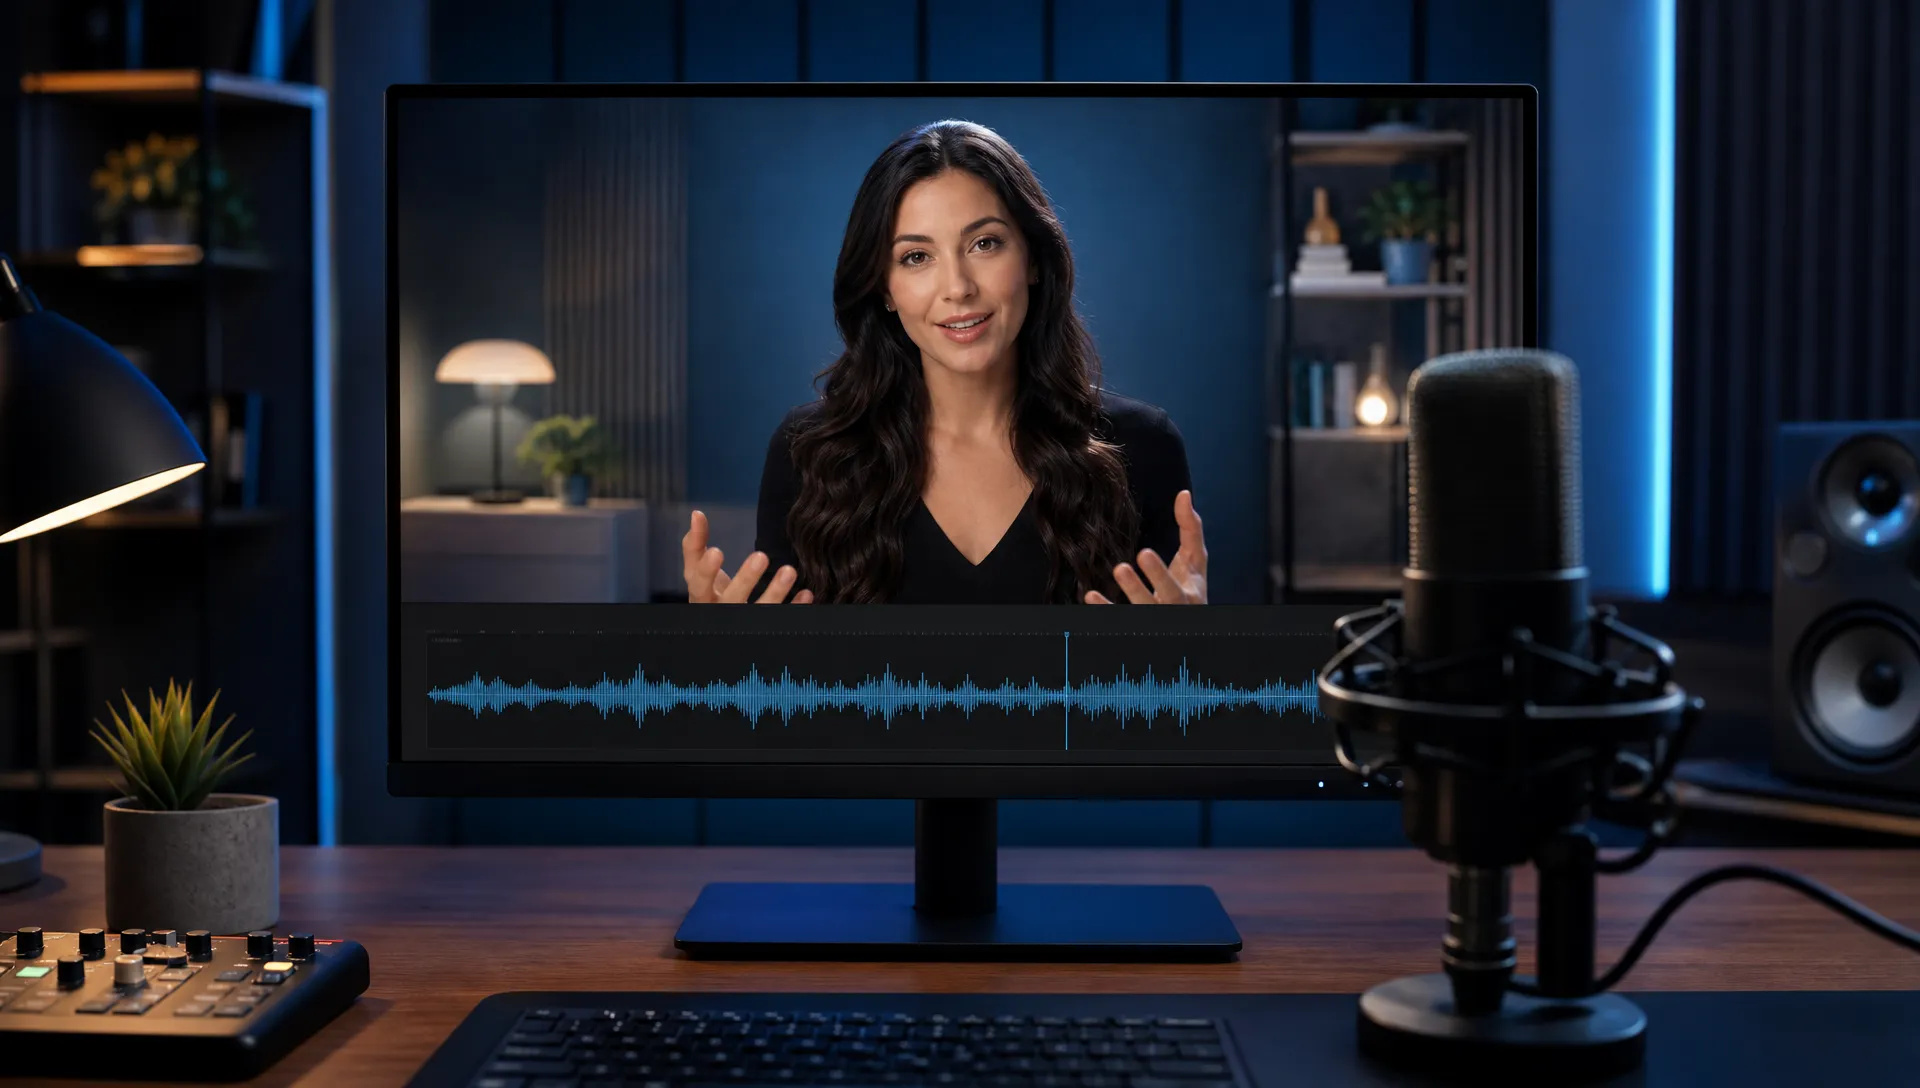
Erzeugen Sie zuerst die Sprachspur und steuern Sie damit ein Avatar-Modell wie Kling Avatar V2.
Wählen Sie das passende Sprachmodell. Ihre Credits gelten überall auf ZOOOP.
Öffnen Sie Eleven V4 auf dieser Seite oder wählen Sie es in den Audio-Tools aus und entscheiden Sie sich für Standard oder Turbo.
Fügen Sie Ihr Skript ein und ergänzen Sie Tags wie [laughs] oder [whispers] an den gewünschten Stellen.
Wählen Sie eine Stimme und stellen Sie die Stabilität (Stability) ein.
Generieren Sie und laden Sie das Audio herunter oder senden Sie es auf Ihre Leinwand.
Eleven V4 ist die Antwort von ElevenLabs auf den schwierigsten Teil synthetischer Voiceovers: die Darbietung. Die meisten Text-to-Speech-Systeme lesen die Wörter korrekt vor; nur wenige sprechen sie wie ein Schauspieler. ElevenLabs hat Eleven v4 im September 2026 auf einer neuen Architektur veröffentlicht und nennt es sein bisher emotionalstes Modell.
Die wichtigste Fähigkeit ist die Regie im Skript selbst. Schreiben Sie Tags wie [laughs], [whispers] oder [sighs] genau dorthin, wo sie passieren sollen, und v4 führt sie der Reihe nach aus, zuverlässiger als v3. So kann eine einzelne Zeile ruhig beginnen, in ein Lachen ausbrechen und zu einem Flüstern absinken. Diese emotionale Bandbreite trägt sich über mehr als 90 Sprachen hinweg, sodass sich dieselbe Darbietung mit derselben Stimme für mehrere Märkte lokalisieren lässt.
Es gibt zwei Versionen. Standard ist die ausdrucksstärkste und die richtige Wahl für fertige Voiceovers. Turbo behält fast denselben Vortrag bei, liefert das Audio schneller und kostet deutlich weniger, was es zum sinnvollen Standard für lange Erzählungen, Entwürfe und große Mengen macht. Auf ZOOOP wählen Sie aus 20 ausgewählten Stimmen und stellen die Stabilität (Stability) ein: niedriger für einen lebendigeren, abwechslungsreicheren Vortrag, höher, damit jede Zeile eines langen Skripts konsistent bleibt.
Wo es schwächer ist: Jede Generierung nimmt bis zu 5.000 Zeichen auf, lange Skripte müssen also in Abschnitte geteilt werden. Es gibt kein separates Stilfeld; die Regie steht als Tags im Text. Wenn Sie das Skript lieber sauber halten und den Vortrag getrennt beschreiben möchten („warm und langsam", „eine dramatische Nachrichtensendung"), ist Gemini 3.8 Flash TTS genau so aufgebaut. Stimmklonen ist mit Eleven V4 auf ZOOOP nicht möglich.
Ein vernünftiges Denkmodell: Machen Sie Eleven V4 zum Standard für Erzählung und Figurenstimmen, Standard für den finalen Mix und Turbo für Entwürfe und lange Lesungen. Greifen Sie zu Gemini 3.8 Flash TTS, wenn Sie Stilanweisungen möchten, zu Multilingual V3, um zu einem bestehenden v3-Projekt zu passen, und zu Kling Avatar V2, um die Stimme in ein sprechendes Video zu verwandeln.
ElevenLabs hat Eleven v4 im September 2026 als sein bisher emotionalstes Modell veröffentlicht. Es basiert auf einer neuen Architektur, spricht mehr als 90 Sprachen und folgt Abfolgen von Audio-Tags wie [laughs] und [whispers] zuverlässiger als Eleven v3.
Standard für fertige Voiceovers, bei denen jede Nuance zählt. Turbo für lange Skripte, Entwürfe und große Mengen: Der Vortrag bleibt fast gleich, kostet deutlich weniger und das Audio kommt schneller zurück.
Bis zu 5.000 Zeichen pro Generierung. Teilen Sie längere Skripte in Abschnitte auf und generieren Sie sie nacheinander mit derselben Stimme.
Emotionen und Geräusche in eckigen Klammern, zum Beispiel [laughs], [whispers], [sighs], [excited] oder [door slams]. Setzen Sie sie genau dorthin, wo der Effekt eintreten soll.
Nicht mit Eleven V4 auf ZOOOP. Wählen Sie aus den 20 verfügbaren Stimmen oder nutzen Sie ein Stimmklon-Modell für Ihre eigene Stimme.
Eleven V4
Text*
Voice*
Stability*
Ihre Generationen werden hier erscheinen, sobald Sie sich anmelden.
Die Erstellung eines Kontos ist kostenlos.