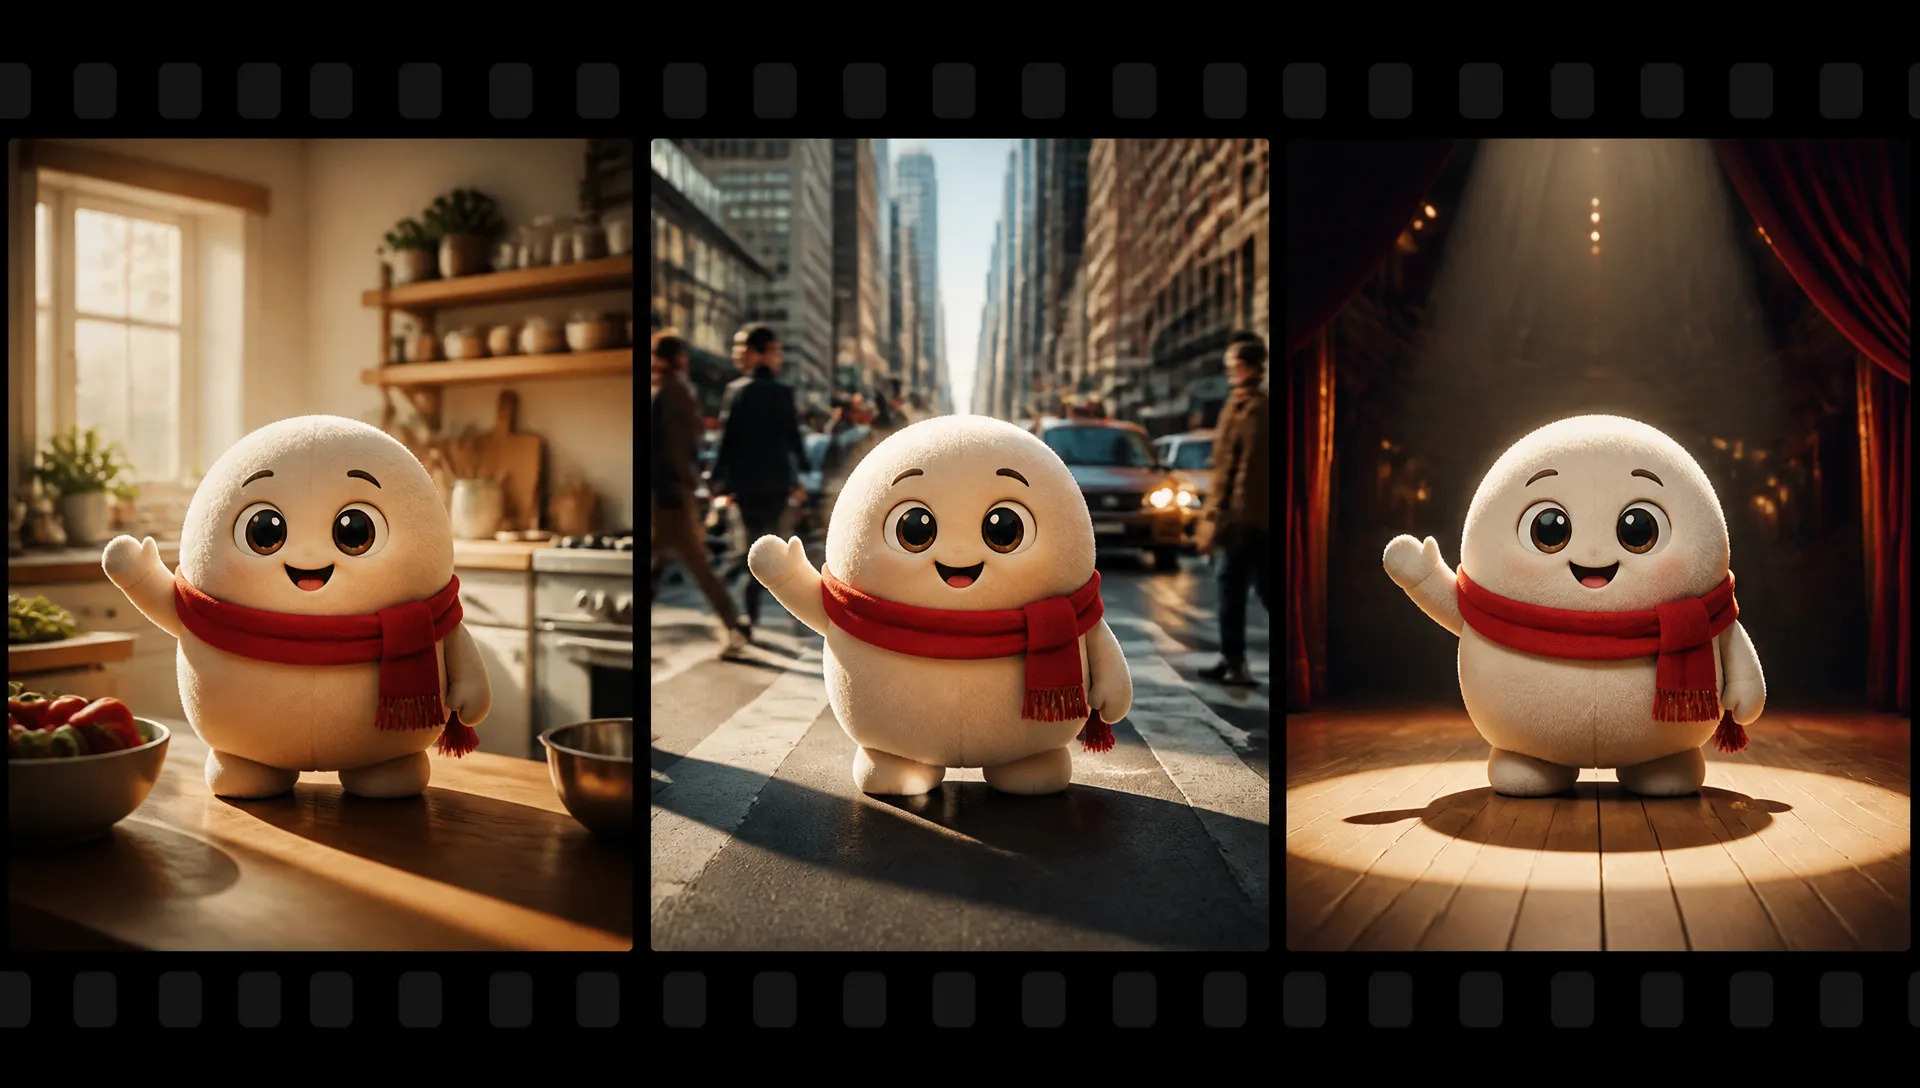
品牌角色走進新場景
吉祥物或代言人保持完全一致,放進廚房、街頭或舞台。
Vidu 最新影片模型:最多 12 個參考主體、3 段參考聲音,單段 3 到 16 秒,原生音訊,最高 4K。
一次儲值積分,通用所有模型,想用再用。 · 按需儲值,不存在月度清零。
Powered by Vidu AI's API on ZOOOP
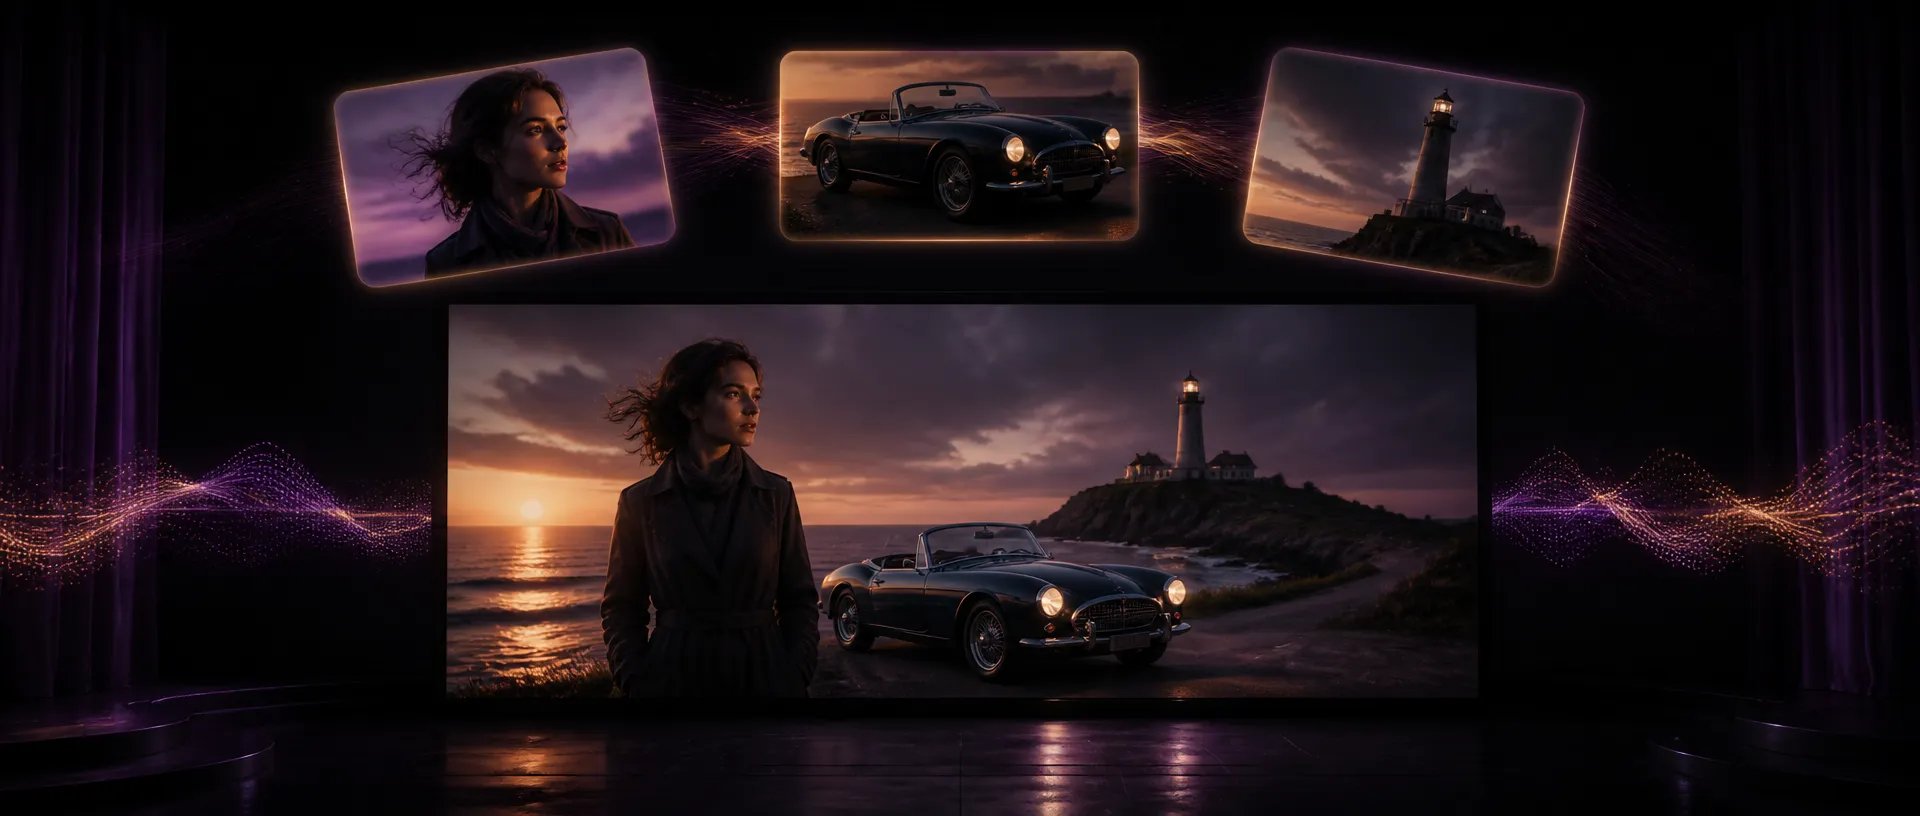
附上最多 12 張角色、產品或場景的圖片,模型會讓每一個在整段影片裡保持一致。
加入最多 3 段 3 到 12 秒的 MP3 聲音片段,生成的對白會跟著這些聲音走。
五檔解析度:先用 540p 出草稿,選中的那一版再用 1080p、2K 或 4K 輸出成片。
時長 3 到 16 秒任選,對白、音效、環境音同步生成。只要畫面時可以關掉聲音。
吉祥物或代言人保持完全一致,放進廚房、街頭或舞台。
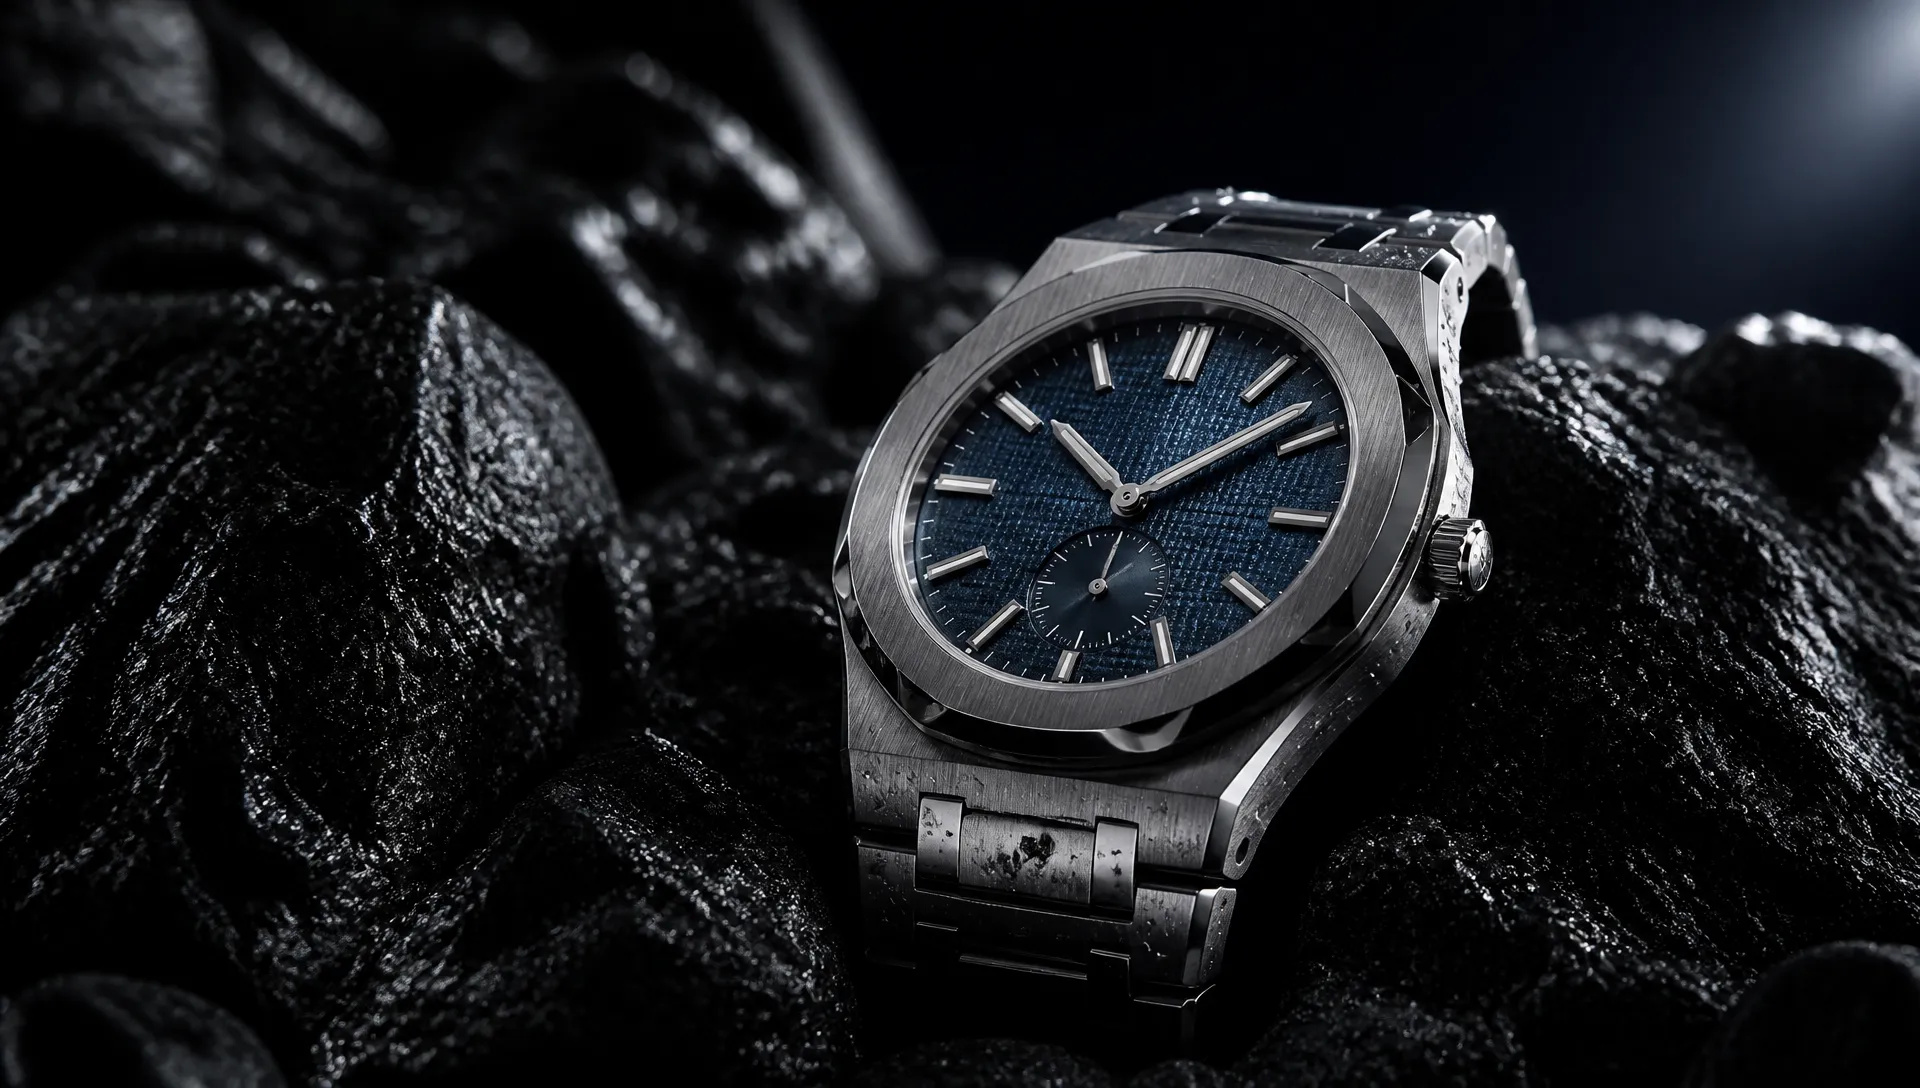
把一張產品靜態圖做成精緻的鏡頭,最終用 4K 輸出,上大螢幕也夠清楚。
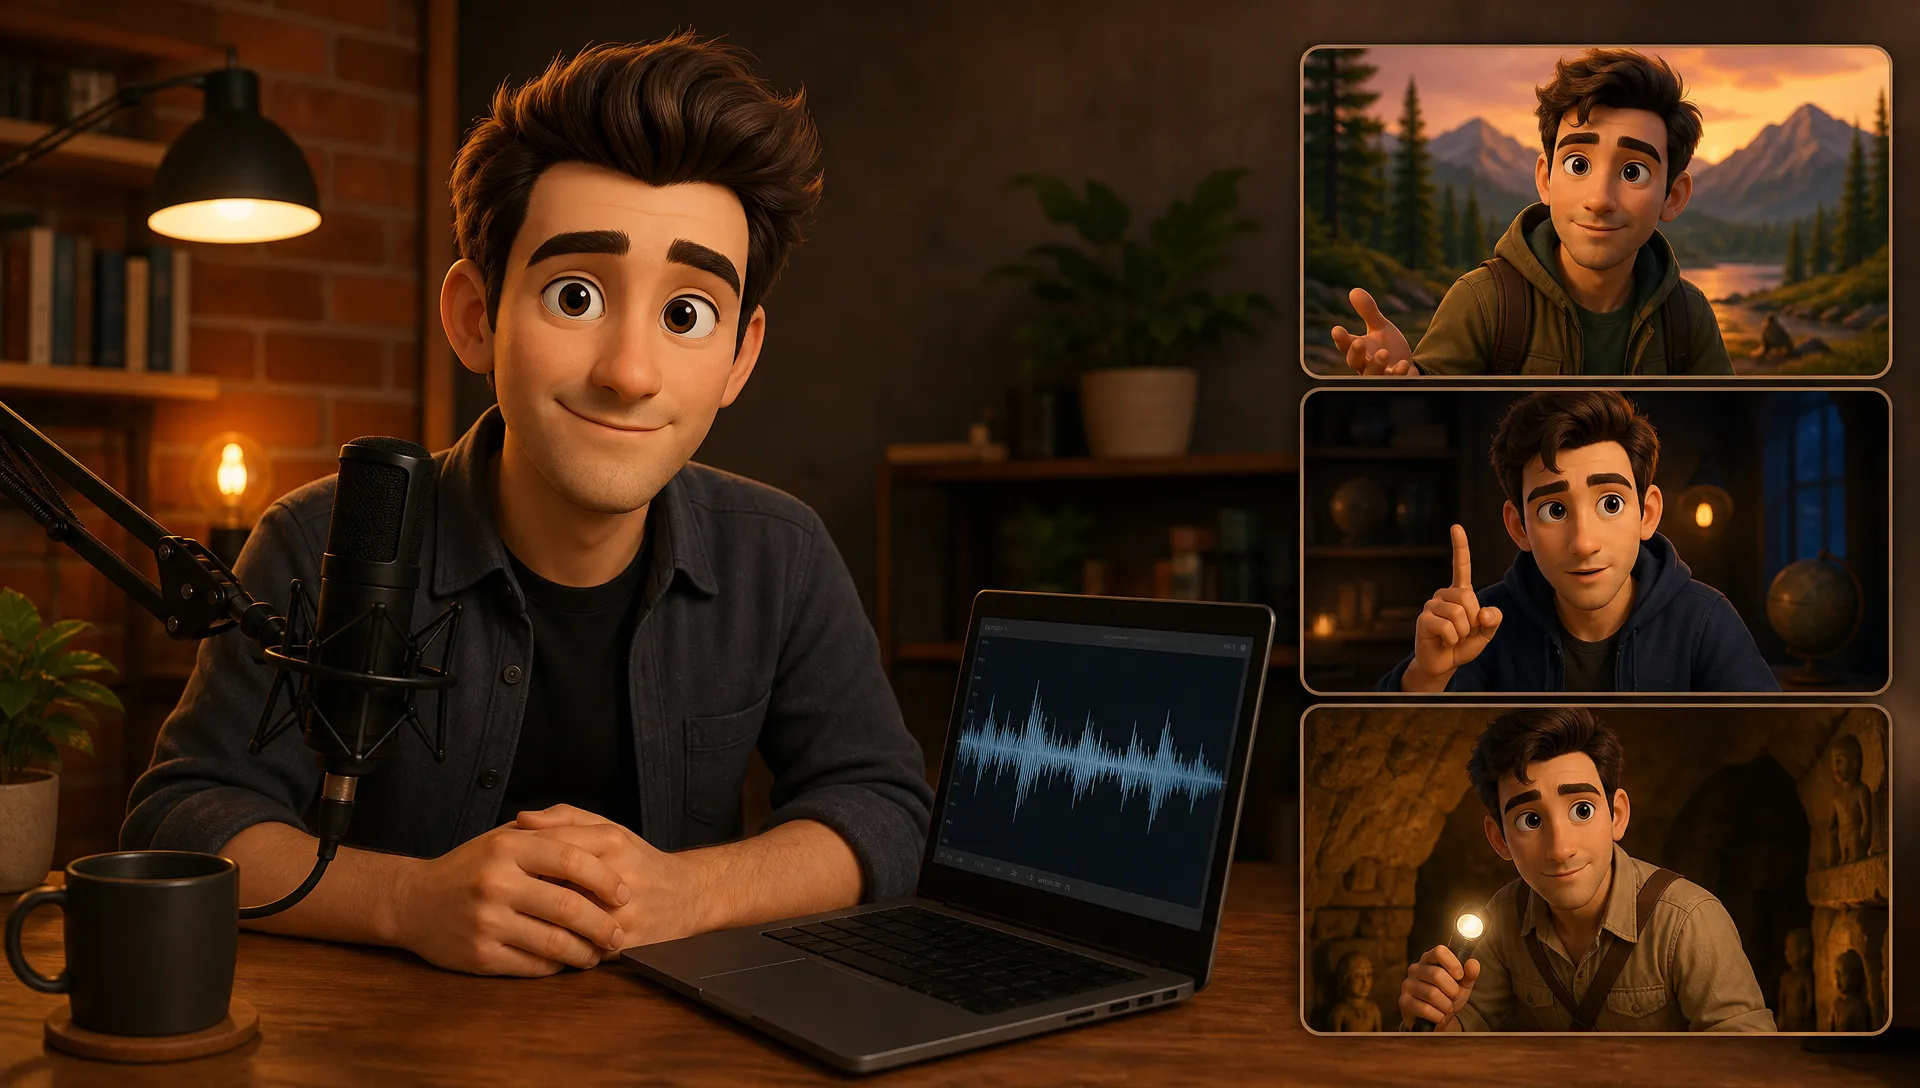
每一集都用同一段聲音參考,旁白或角色的聲音始終如一。
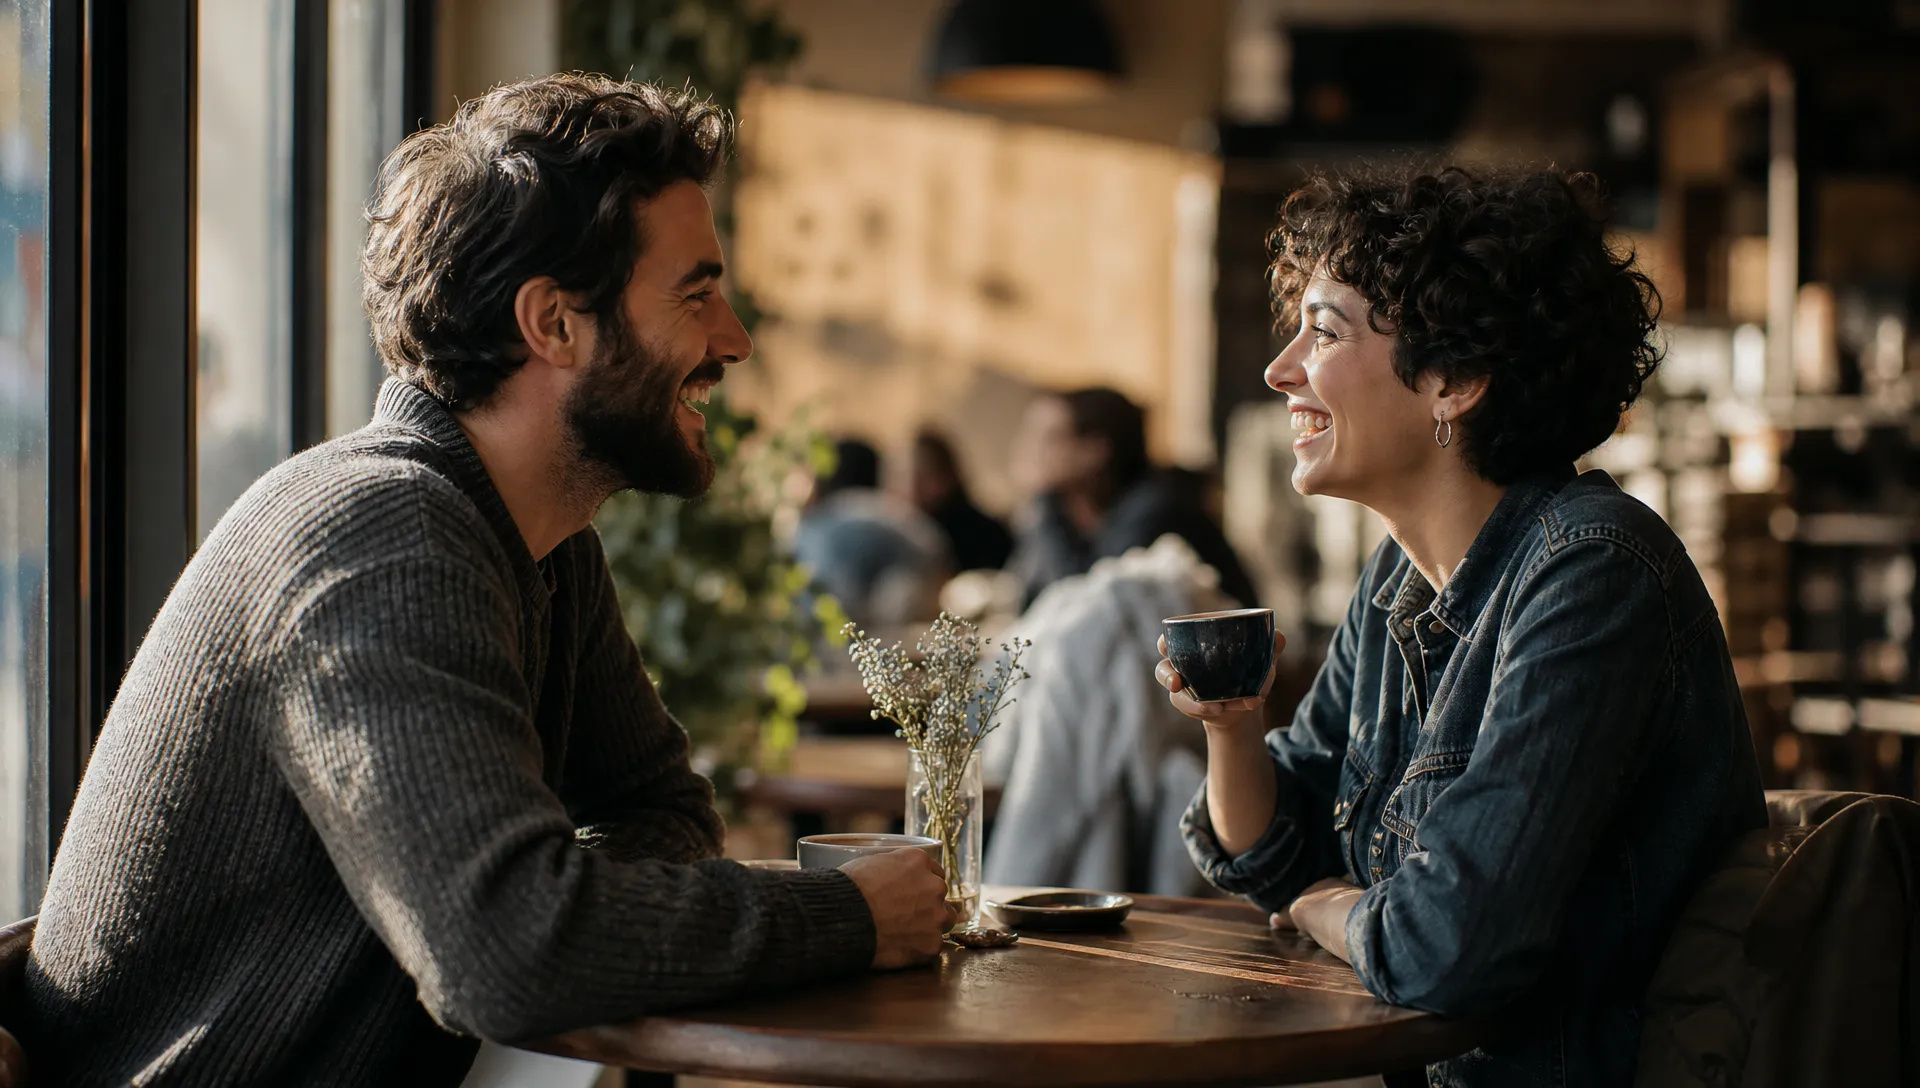
一個鏡頭裡放進好幾個角色參考,比如兩個朋友在咖啡廳見面。
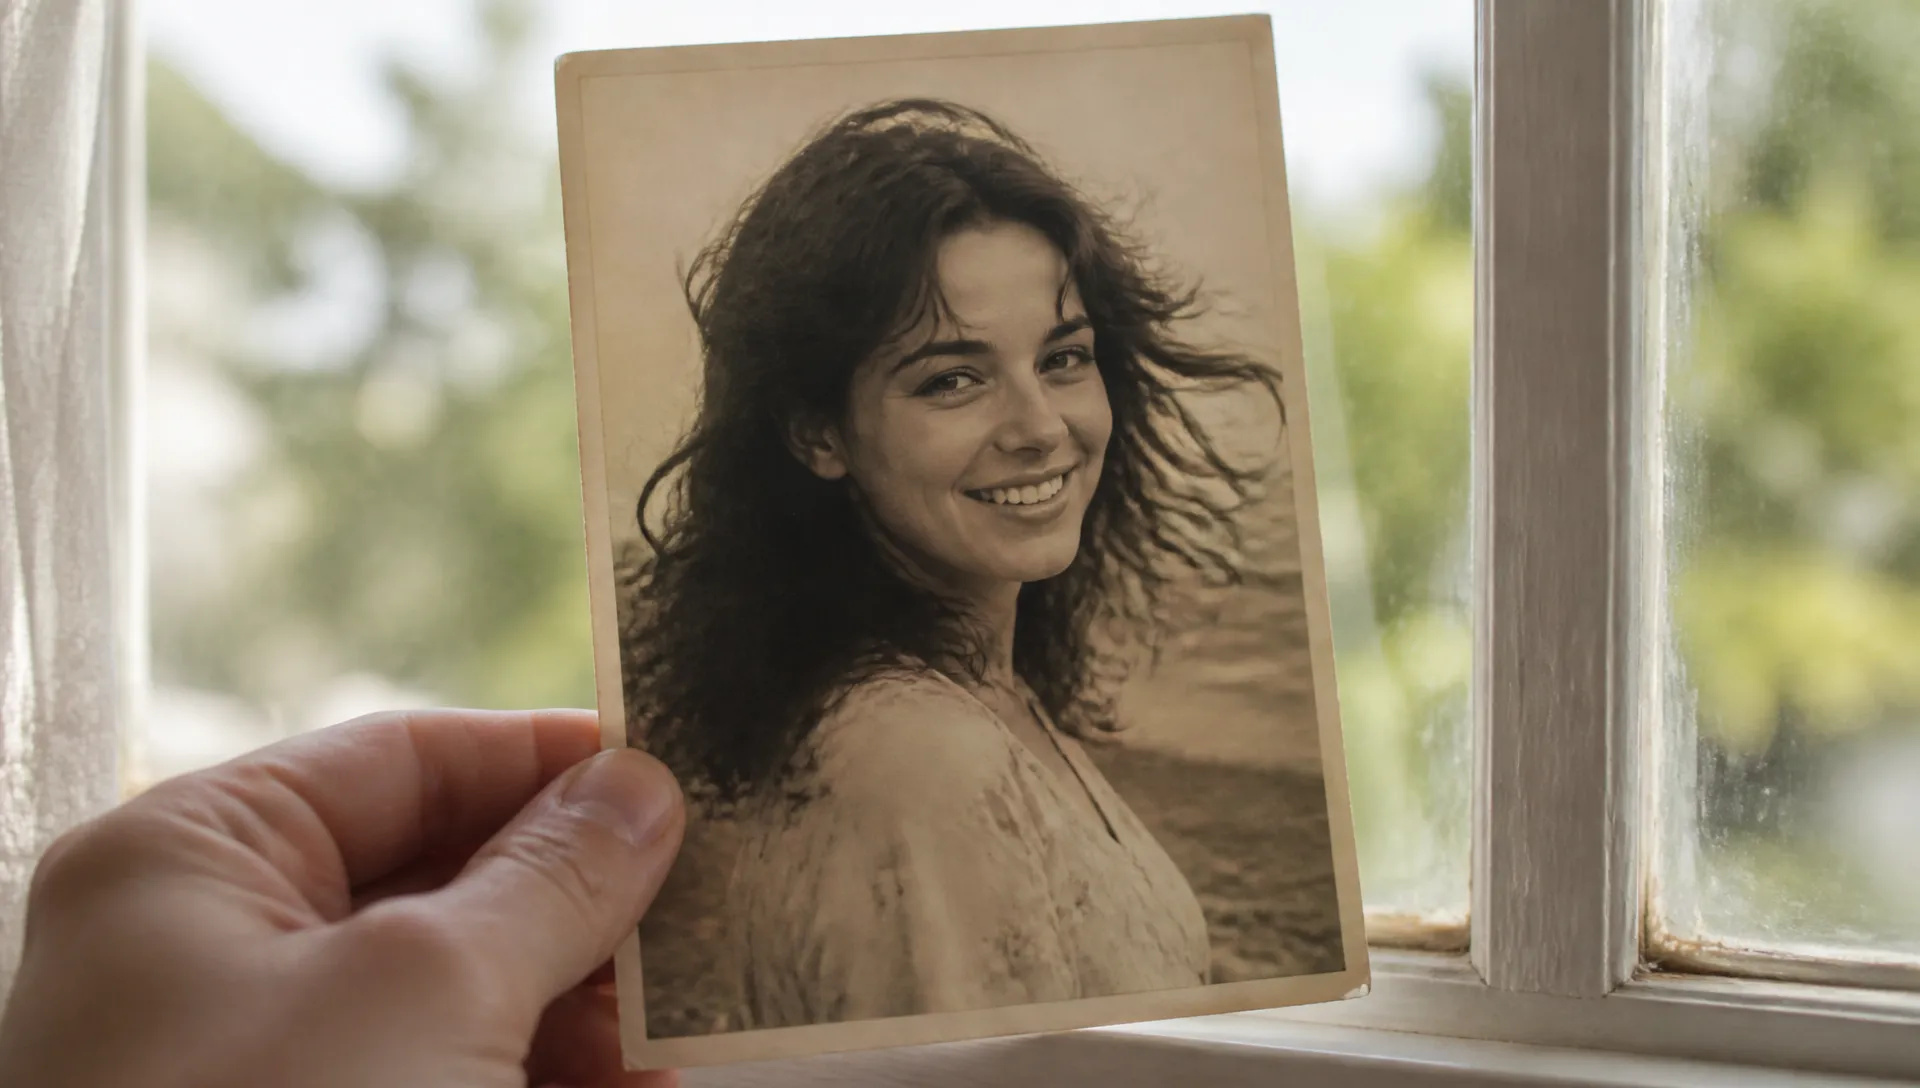
從一張照片開始,讓畫面動起來:頭髮被風吹起、一個微笑、鏡頭輕輕漂移。
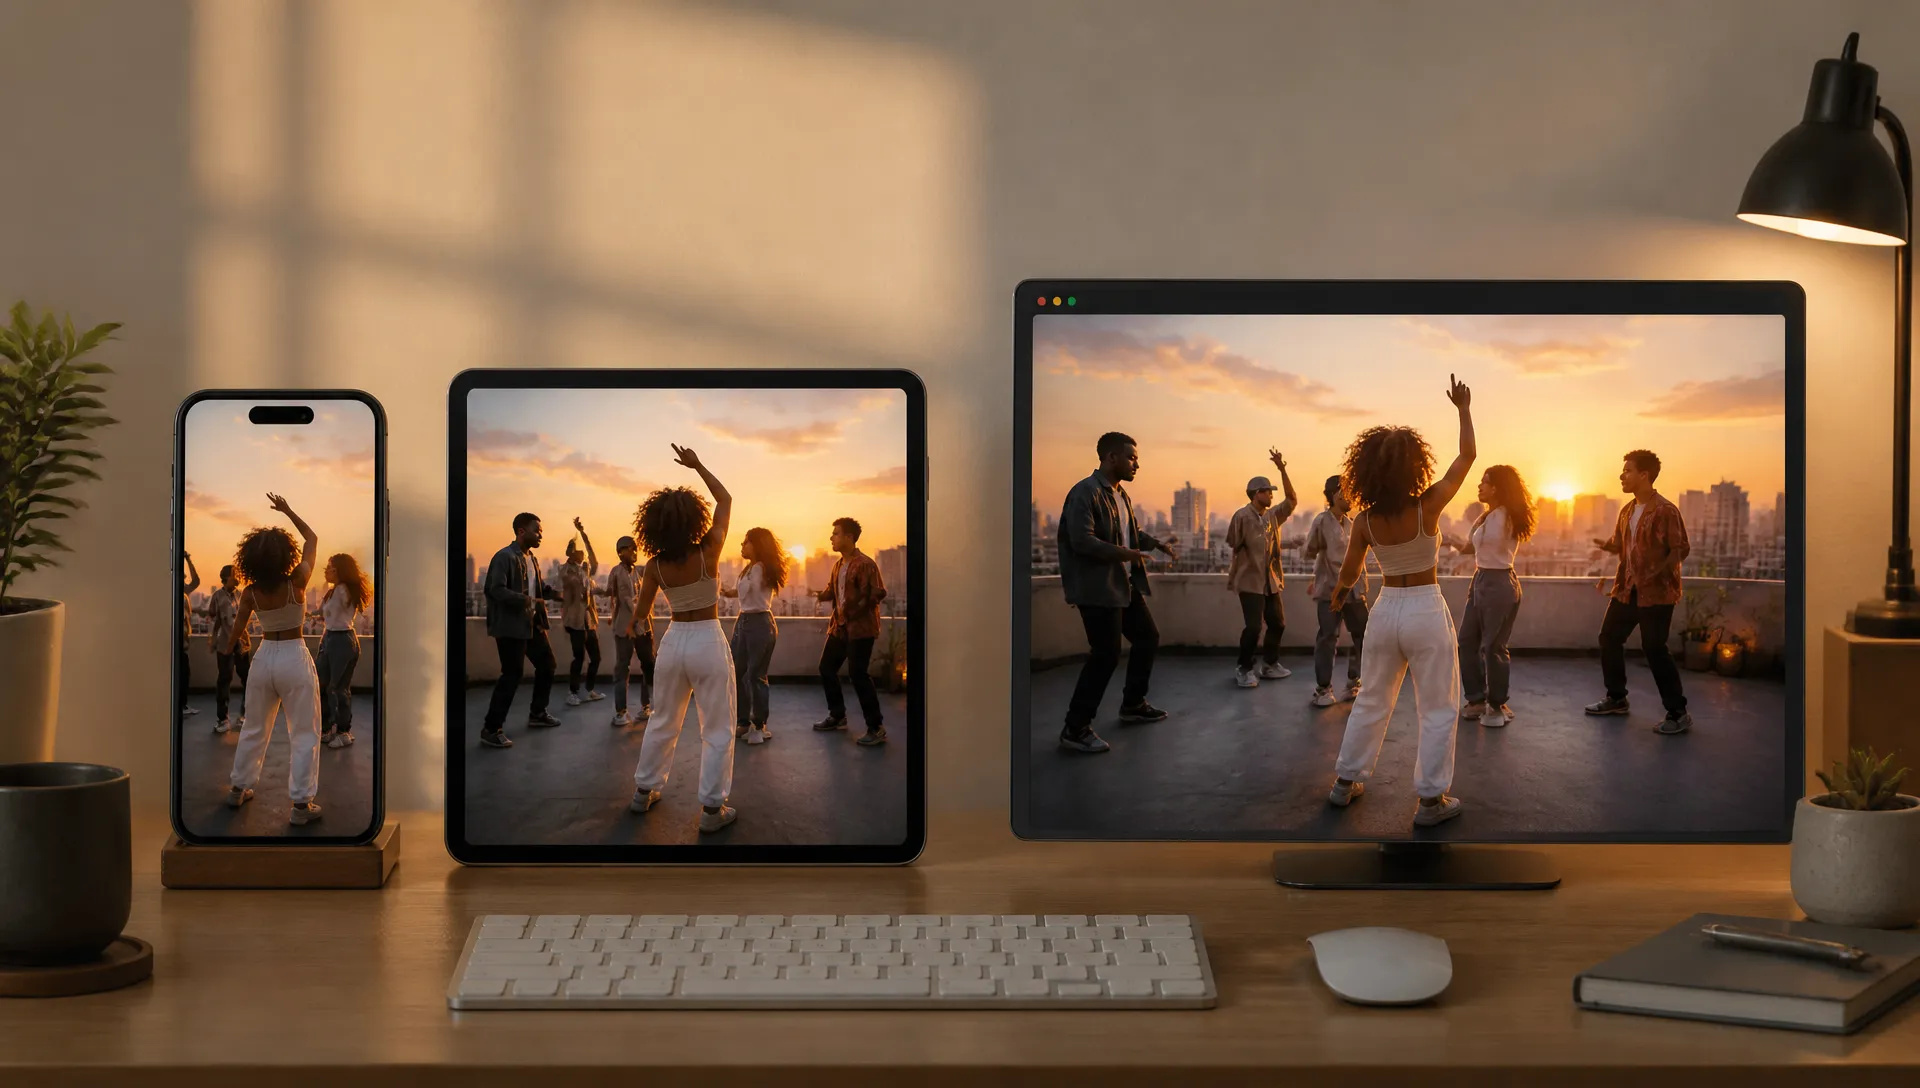
參考圖生成的影片可以出 9:16 做短影音,也可以出 1:1、4:3 發在動態消息。
Vidu Q4 的專長是參考:主體多、聲音穩、最高 4K。鏡頭需要別的能力時,再換下面的模型。
在本頁打開 Vidu Q4,選模式:首幀,或參考圖(可加參考聲音)。
上傳首幀或參考圖,寫清楚要發生什麼。
選時長(3 到 16 秒)、解析度(540p 到 4K),參考模式下再選畫面比例。
先用低檔位出一版看效果,滿意了再用高解析度重新輸出。
Vidu Q4 的強項是同時讓很多東西保持一致。大多數影片模型只適合一兩張參考圖,Q4 一個鏡頭最多能吃下 12 張參考圖,再加最多 3 段參考聲音。一群角色、一個產品、一個場景都能維持原樣,生成的對白也是對的聲音。
第一項核心能力是帶主體和聲音的參考圖生成影片。附上圖片,在提示詞裡寫清楚誰做什麼,還可以再加 3 到 12 秒的 MP3 聲音片段。在我們的測試裡,兩個機器人參考在 9:16 直式畫面裡並排站在夕陽下的屋頂上輕輕搖擺,造型沒有互換;單一角色朝鏡頭揮手打招呼時,聲音和畫面一起生成。
第二項是解析度跨度大。從 540p 到 4K 共五檔,可以先便宜地試一版,滿意的再用 2K 或 4K 輸出給大螢幕,不用換模型。
第三項是夠長,還帶聲音。時長 3 到 16 秒任選,對白、音效、環境音同步生成;只要畫面時也可以關掉聲音。
不擅長的地方:沒有純文字生成模式,也不支援尾幀。純文字生成影片用 Gemini Omni 1.1 Flash 或 MiniMax H3 Max,首尾幀轉場用 MiniMax H3 Max。它目前還是預覽版,表現可能會隨版本變化。單一鏡頭超過 16 秒,可以用 Wan V3.0,最長 30 秒。
一個合理的用法:幾個主體或某個聲音必須保持一致,或者成片必須是 4K 時,選 Vidu Q4。要快速出首幀影片用 MiniMax H3 Max,要編輯或延長用 Gemini Omni 1.1 Flash。
它是 Vidu 最新的影片模型,2026 年 10 月以預覽版發布。在 ZOOOP 上可以讓首幀動起來,或用最多 12 張參考圖、最多 3 段參考聲音生成場景,自帶原生音訊。
不能。Vidu Q4 需要一張首幀或至少一張參考圖。純文字生成影片請用 Gemini Omni 1.1 Flash 或 MiniMax H3 Max。
上傳最多 3 段 MP3,每段 3 到 12 秒。生成的語音會跟著這些聲音走,同一個角色在不同影片裡聽起來都一樣。
每次生成 3 到 16 秒任選。
540p、720p、1080p、2K、4K。參考模式有 16:9、9:16、1:1、4:3、3:4;首幀模式跟隨你的圖片比例。
不支援,只有首幀。要做首尾幀轉場,請用 MiniMax H3 Max 或 Gemini Omni 1.1 Flash。
Vidu Q4
Prompt*
Reference Images*
Reference Voices
選擇比例*
影片解析度*
時長*
登入後,你的生成結果會出現在這裡。
建立帳號免費。