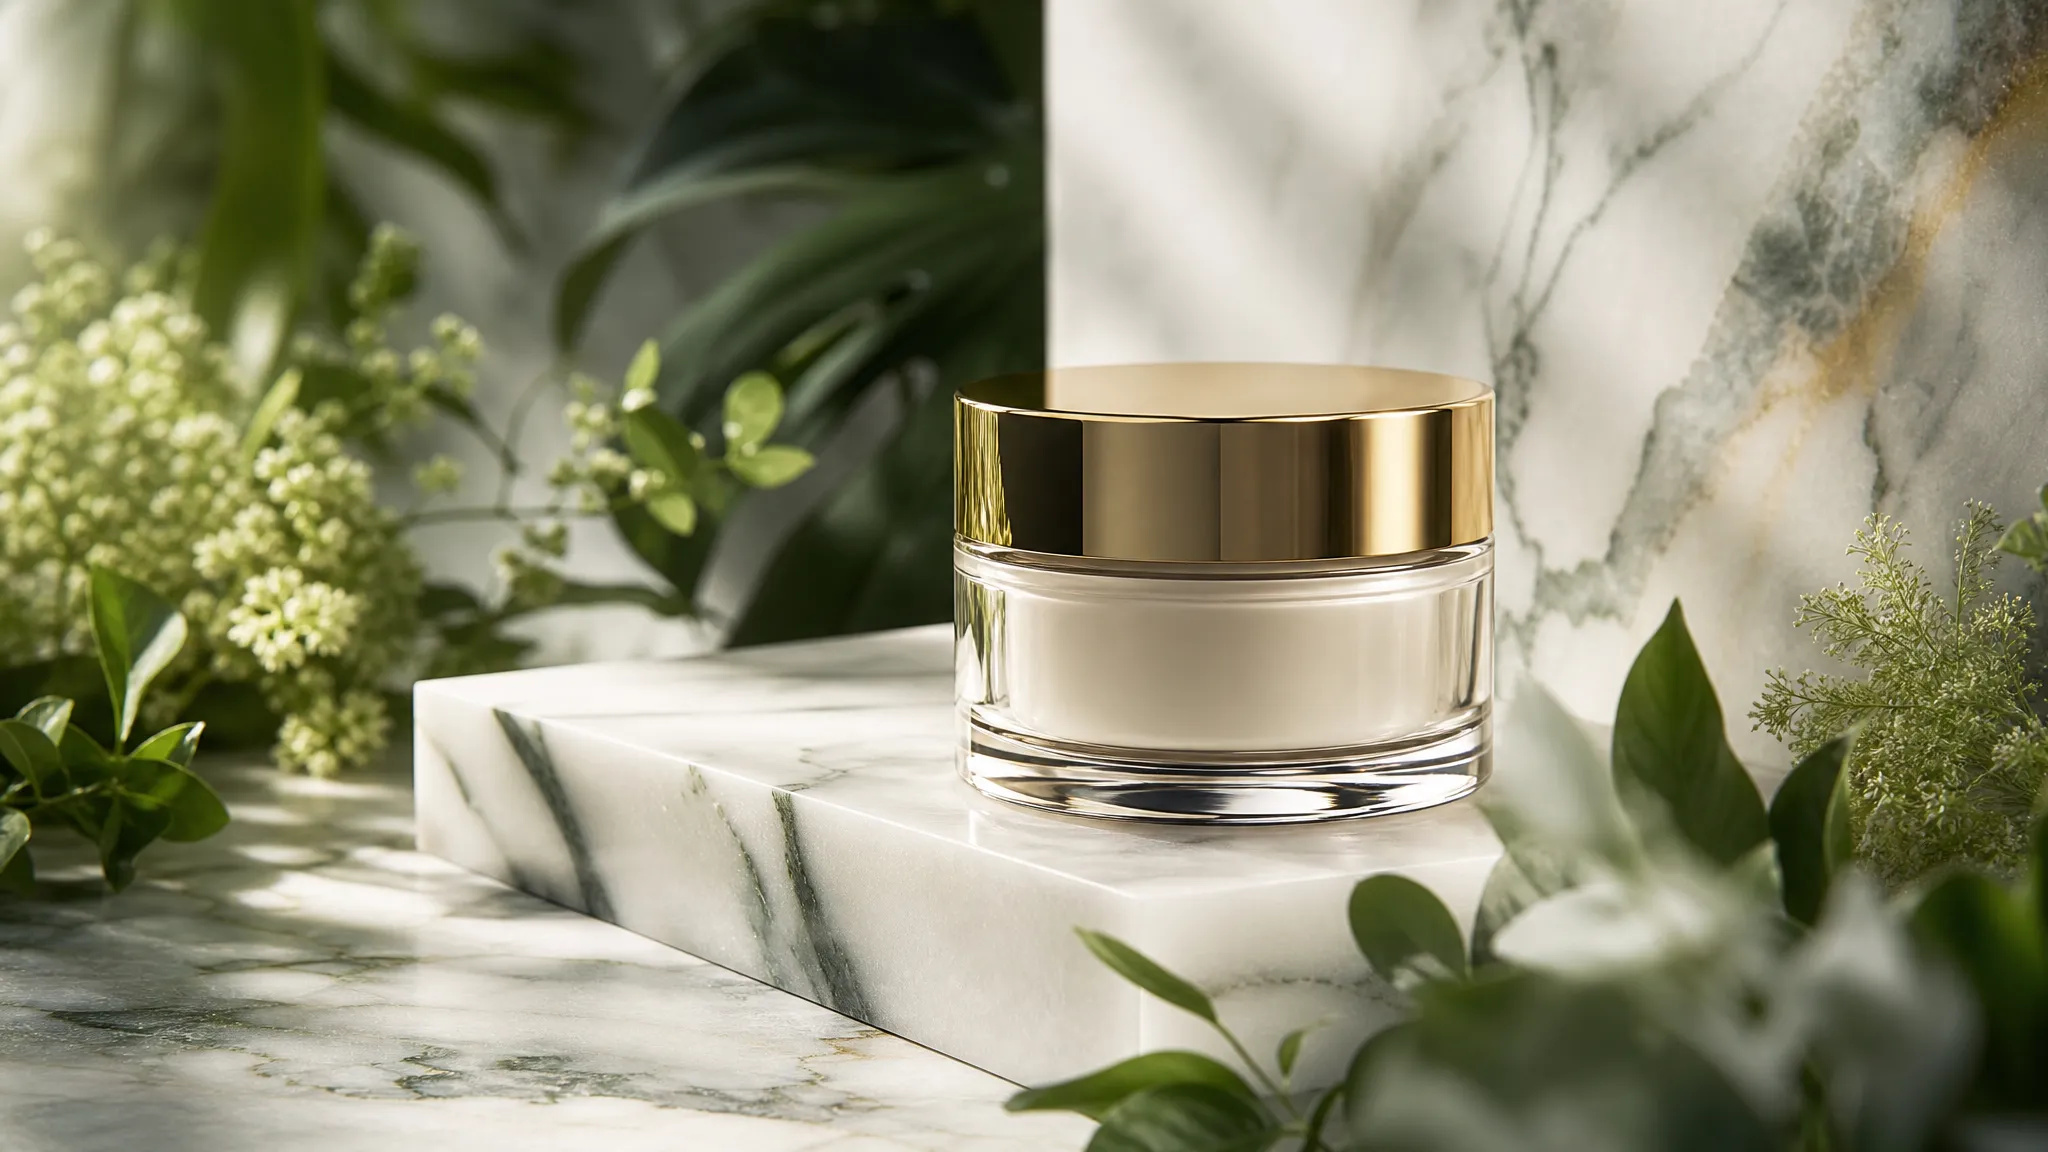
電商產品圖換背景
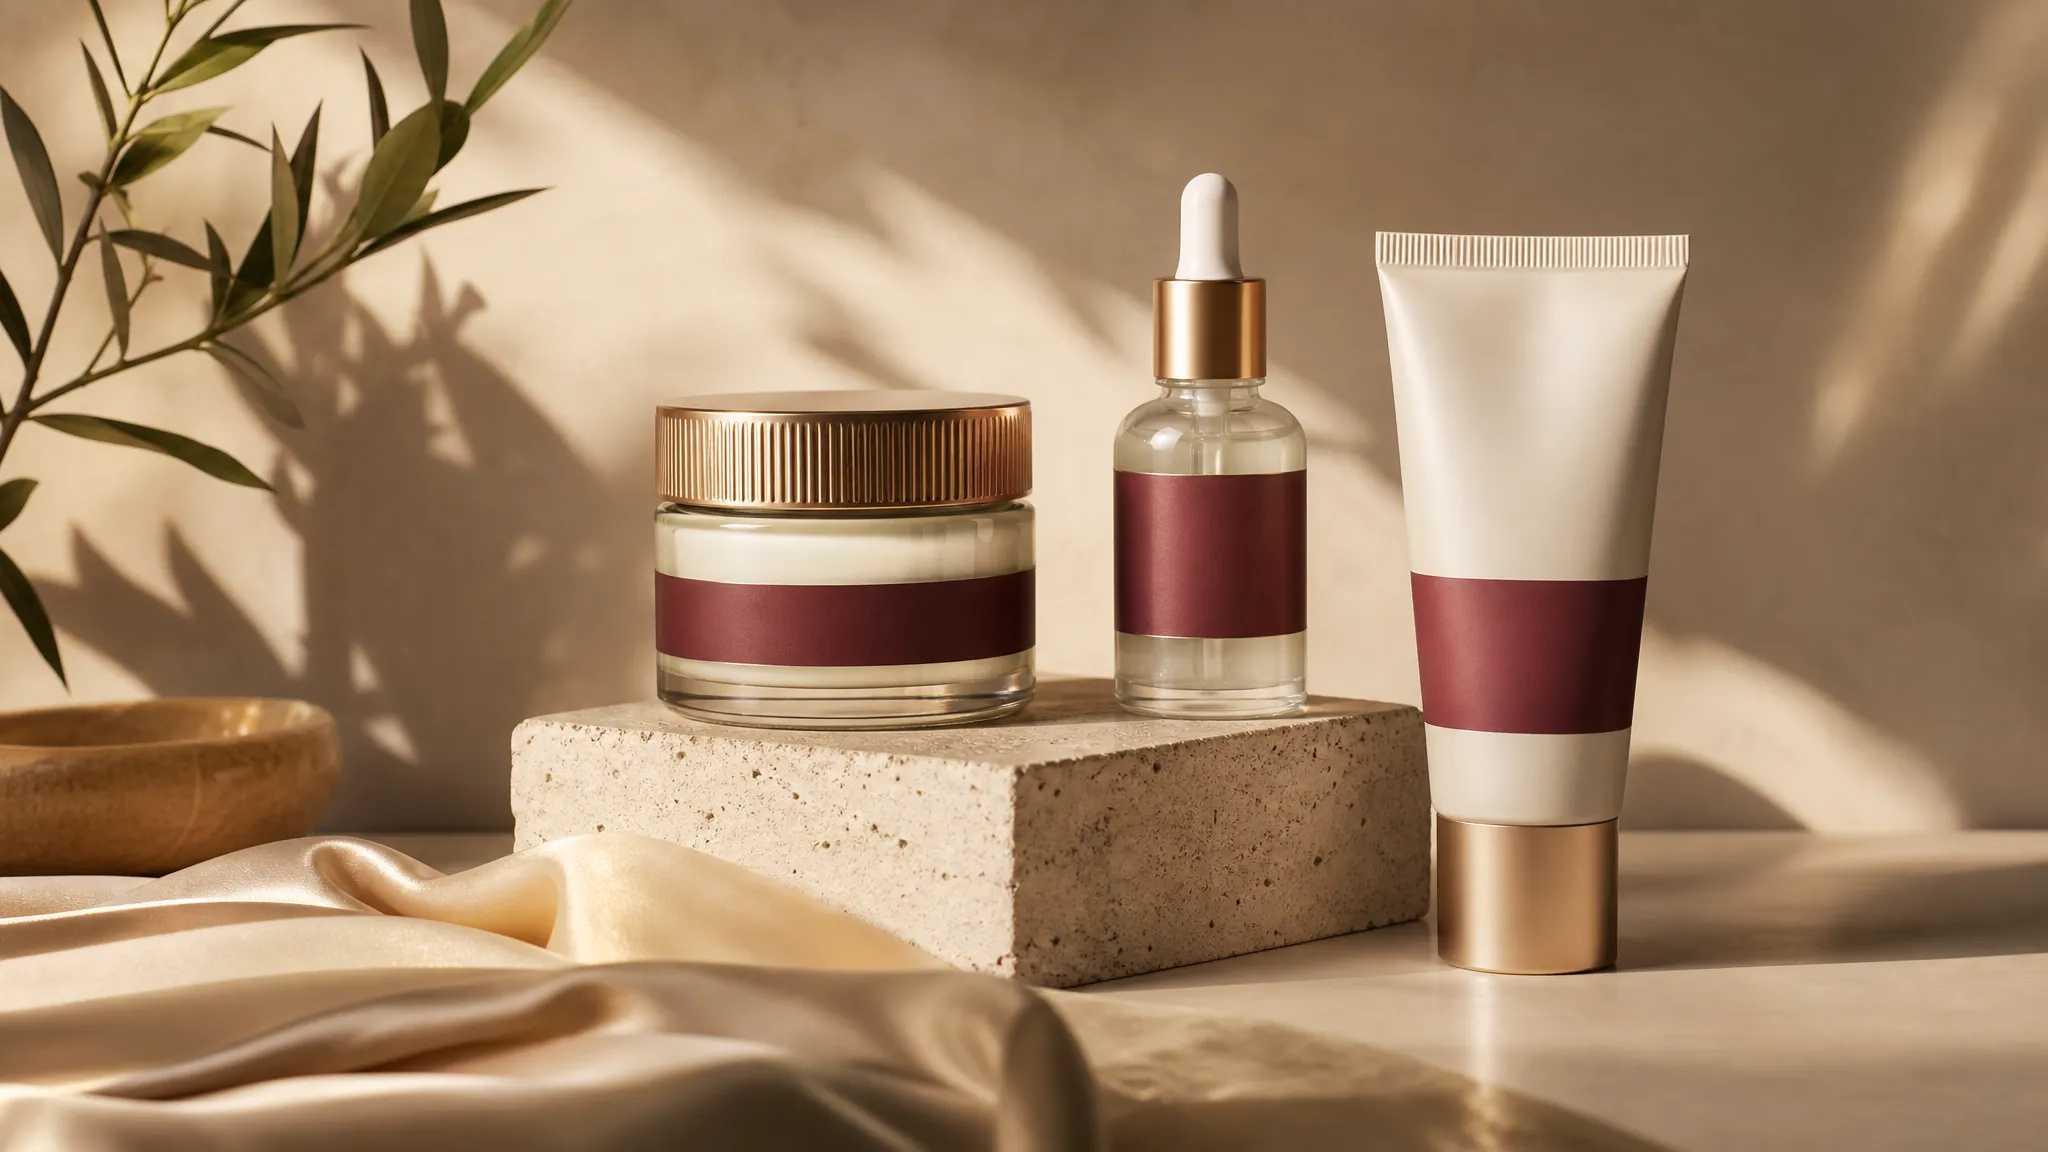
產品本身不動,只換場景和光線,一套產品圖拍一次就能出多種版本。
上傳一張圖,用一句話說出要改什麼 —— 換背景、去掉東西、改顏色、加元素,不用重新描述整張畫面,也不用圖層和遮罩工具。
說「把背景換成傍晚的街道」就夠了,不用重新描述整張畫面,原圖裡你沒提到的部分會保持原樣。
用畫筆塗出區域,只讓 AI 動這一塊。適合精確修掉某個物體,或者只替換畫面裡的一小部分。
除了要改的原圖,還可以附上參考圖告訴模型你想要的樣子,比用文字描述外觀更準。
GPT Image、Nano Banana 系列各有擅長 —— 有的更聽得懂複雜指令,有的更穩地保住人臉和產品細節,同一張圖可以換模型再試一次。
產品本身不動,只換場景和光線,一套產品圖拍一次就能出多種版本。
路人、雜物、多餘的文字,圈出來讓它消失,背景會自然補上。
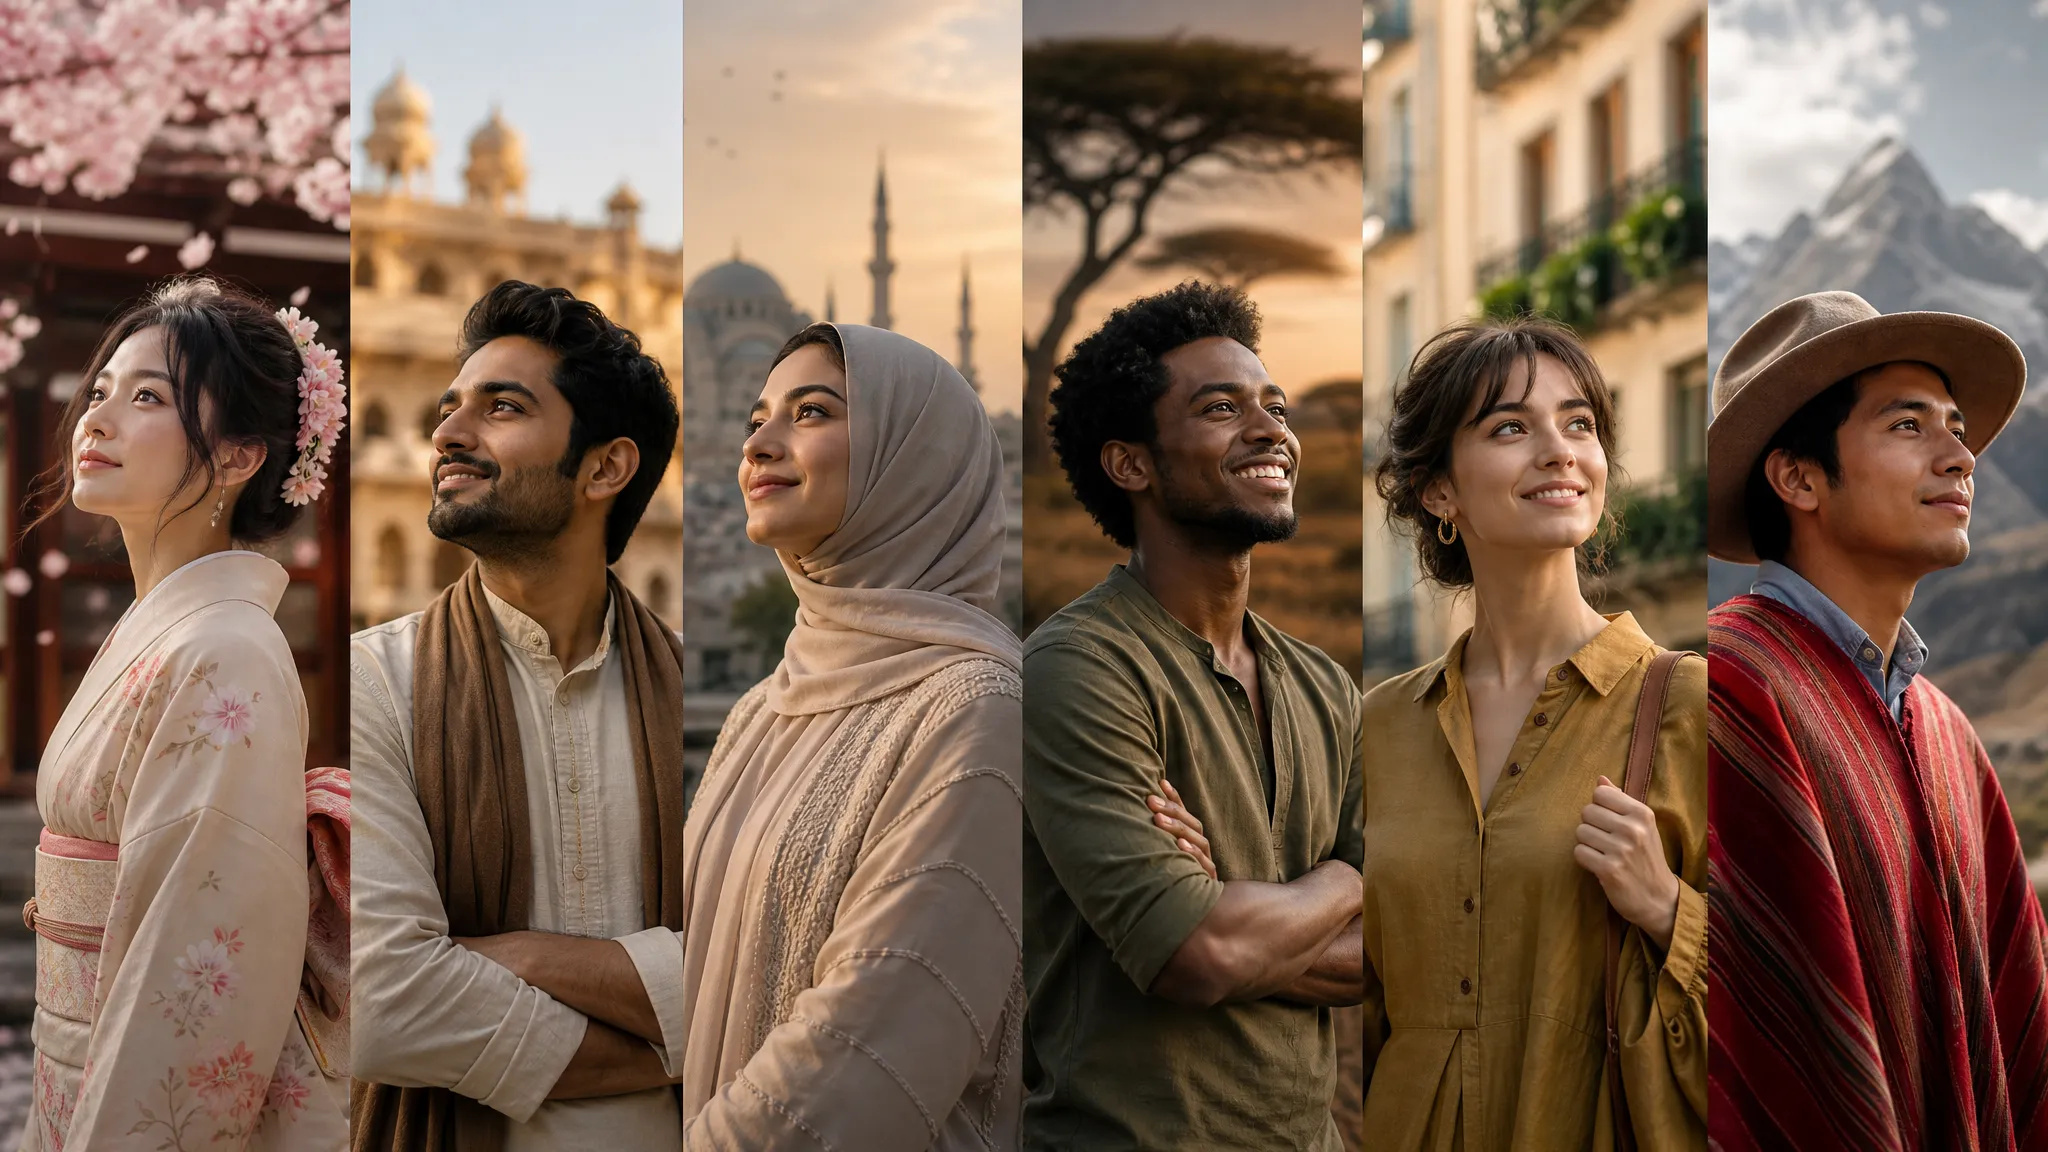
版面和主體保留,只改標題文字或整體色調,做多語言版本或 A/B 方案。
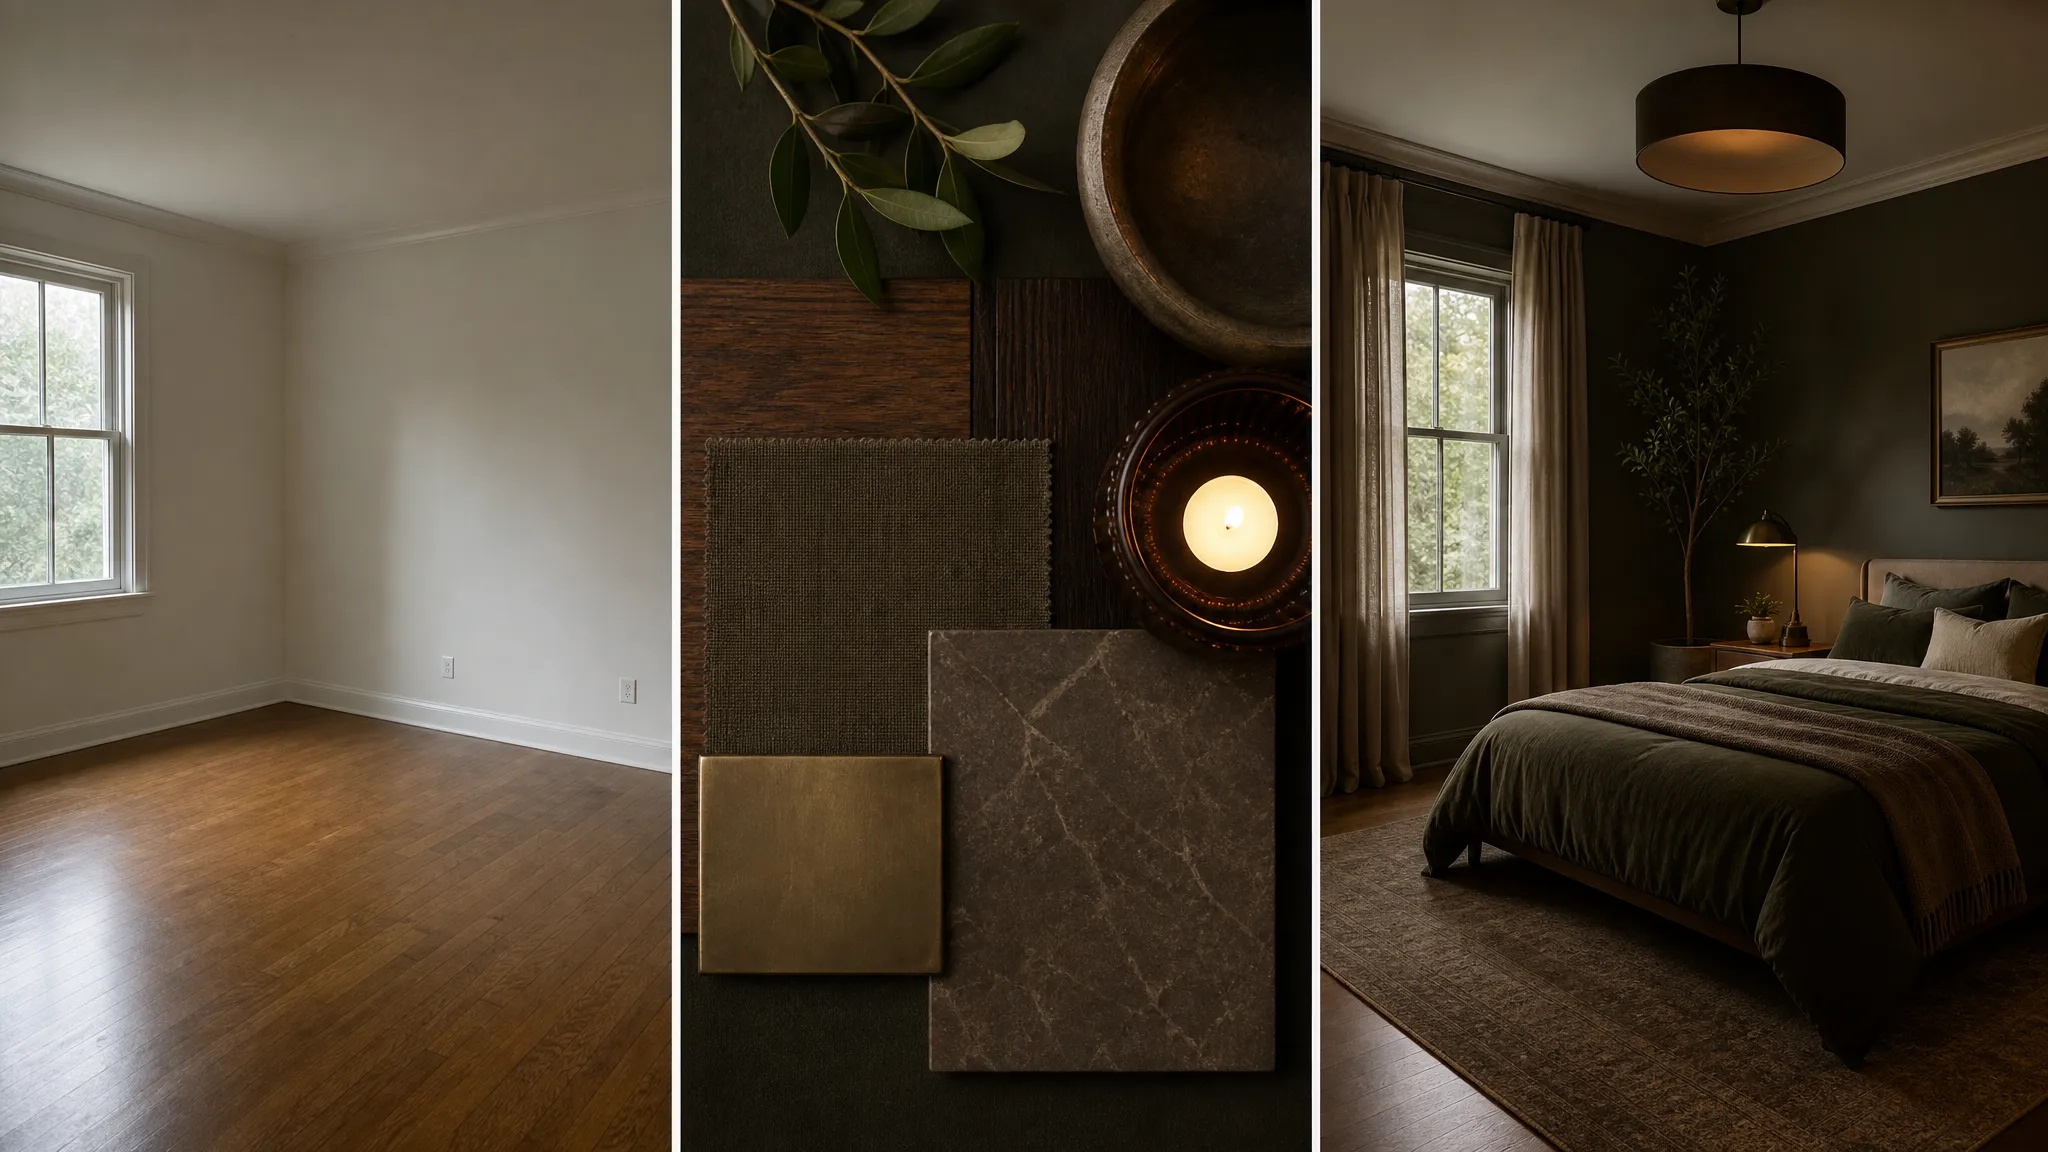
光線、材質、顏色這些說不清但看得出的地方,用一句話讓它往對的方向走。
打開 AI 圖片編輯,上傳要改的圖片。
用一句話說出要改什麼;需要精確控制就用畫筆塗出那塊區域。
生成後下載,或者送進畫布接著改。
從零生成一張圖和改一張已有的圖,是兩件不同的事。生成的時候你在描述「我要什麼」;改的時候你其實在說「除了這一處,其他都別動」。
後面這件事用文生圖工具做很彆扭:重新寫一遍提示詞,出來的人物、構圖、光線全都變了,你想保住的東西反而沒了。傳統修圖軟體能精確控制,但換一個背景要去背、羽化、調色,會用的人才能用好。
ZOOOP 的 AI 圖片編輯走中間那條路:上傳原圖,用一句話說要改什麼。「把背景換成傍晚的街道」「去掉左邊那個人」「讓這件外套變成米色」—— 你沒提到的部分會盡量保持原樣。
大部分改動直接說就行。但有兩種情況文字會不夠用:改動的位置很具體(畫面裡有三個人,你只想去掉其中一個),或者試了幾次模型總改錯地方。
這時候用畫筆把區域塗出來,只讓 AI 動這一塊。除了塗選,你還可以附上參考圖 —— 想要什麼樣的背景、什麼質感的材質,給一張圖比寫一段形容詞準得多。
模型也值得換著試。有的更聽得懂複雜指令,有的在編輯時保住人臉和產品細節更穩。同一張圖、同一句話,換個模型再跑一次,常常就是從「不太對」到「就是這個」的差別。
這一頁負責改你已有的那張圖。有幾件事有更合適的入口:
一句話概括:想保住原圖的時候用編輯,想要全新畫面的時候用生成。
實際用起來,這兩件事經常來回切 —— 先在圖像生成器裡試出一張滿意的底圖,再到這裡精修細節,改完再送進畫布和別的素材擺在一起。所以這一頁很少是起點,但常常是讓一張「差不多了」的圖變成能交付的那一步。
圖像生成器是從零畫一張新的,圖片編輯是改你已有的那張。區別在於「保住什麼」:編輯會盡量維持原圖裡你沒提到的部分,所以想換背景、去掉某個東西、改一處細節,用編輯比重新生成更可控,也不會連人物和構圖一起變掉。
不一定。多數改動直接用文字說就行,模型會自己找到要動的地方。塗選適合兩種情況:改動位置很具體(比如去掉畫面右下角那個人),或者試過幾次模型總是改錯地方 —— 塗出來就不會有歧義。
這正是不同模型差別最大的地方。有些模型在編輯時保持人臉和產品外觀更穩,有些更擅長大幅度的風格改動。如果一次結果裡主體變形了,換個模型用同一句指令再試一次,通常就能解決。
可以。每次生成的結果都能作為下一次編輯的輸入,一步一步改下去。需要同時看很多個版本、或者要把好幾張圖擺在一起比較,用畫布會比在單頁裡反覆覆蓋更清楚。
Prompt*
Image*
分辨率*
Thinking Level