讓靜態畫面動起來
一張滿意的圖作起點,指定它要變成什麼樣,中間的運動自動補上。
給定第一格和最後一格,讓 AI 補出中間的運動 —— 起點和終點都由你定,畫面不會跑偏。
上傳兩張圖,中間的運動由模型補。比純文字描述可控得多 —— 畫面最終會落在哪裡,你已經先定好了。
上一個鏡頭的最後一格作首格、下一個鏡頭的第一格作尾格,中間那段過渡自然生成。
大部分影片模型都支援首尾影格,運動的風格和幅度各有不同,同一組圖可以換模型再試。
只給首格不給尾格,就變成從這張圖往後延續;兩張都給才是精確的補間。
一張滿意的圖作起點,指定它要變成什麼樣,中間的運動自動補上。
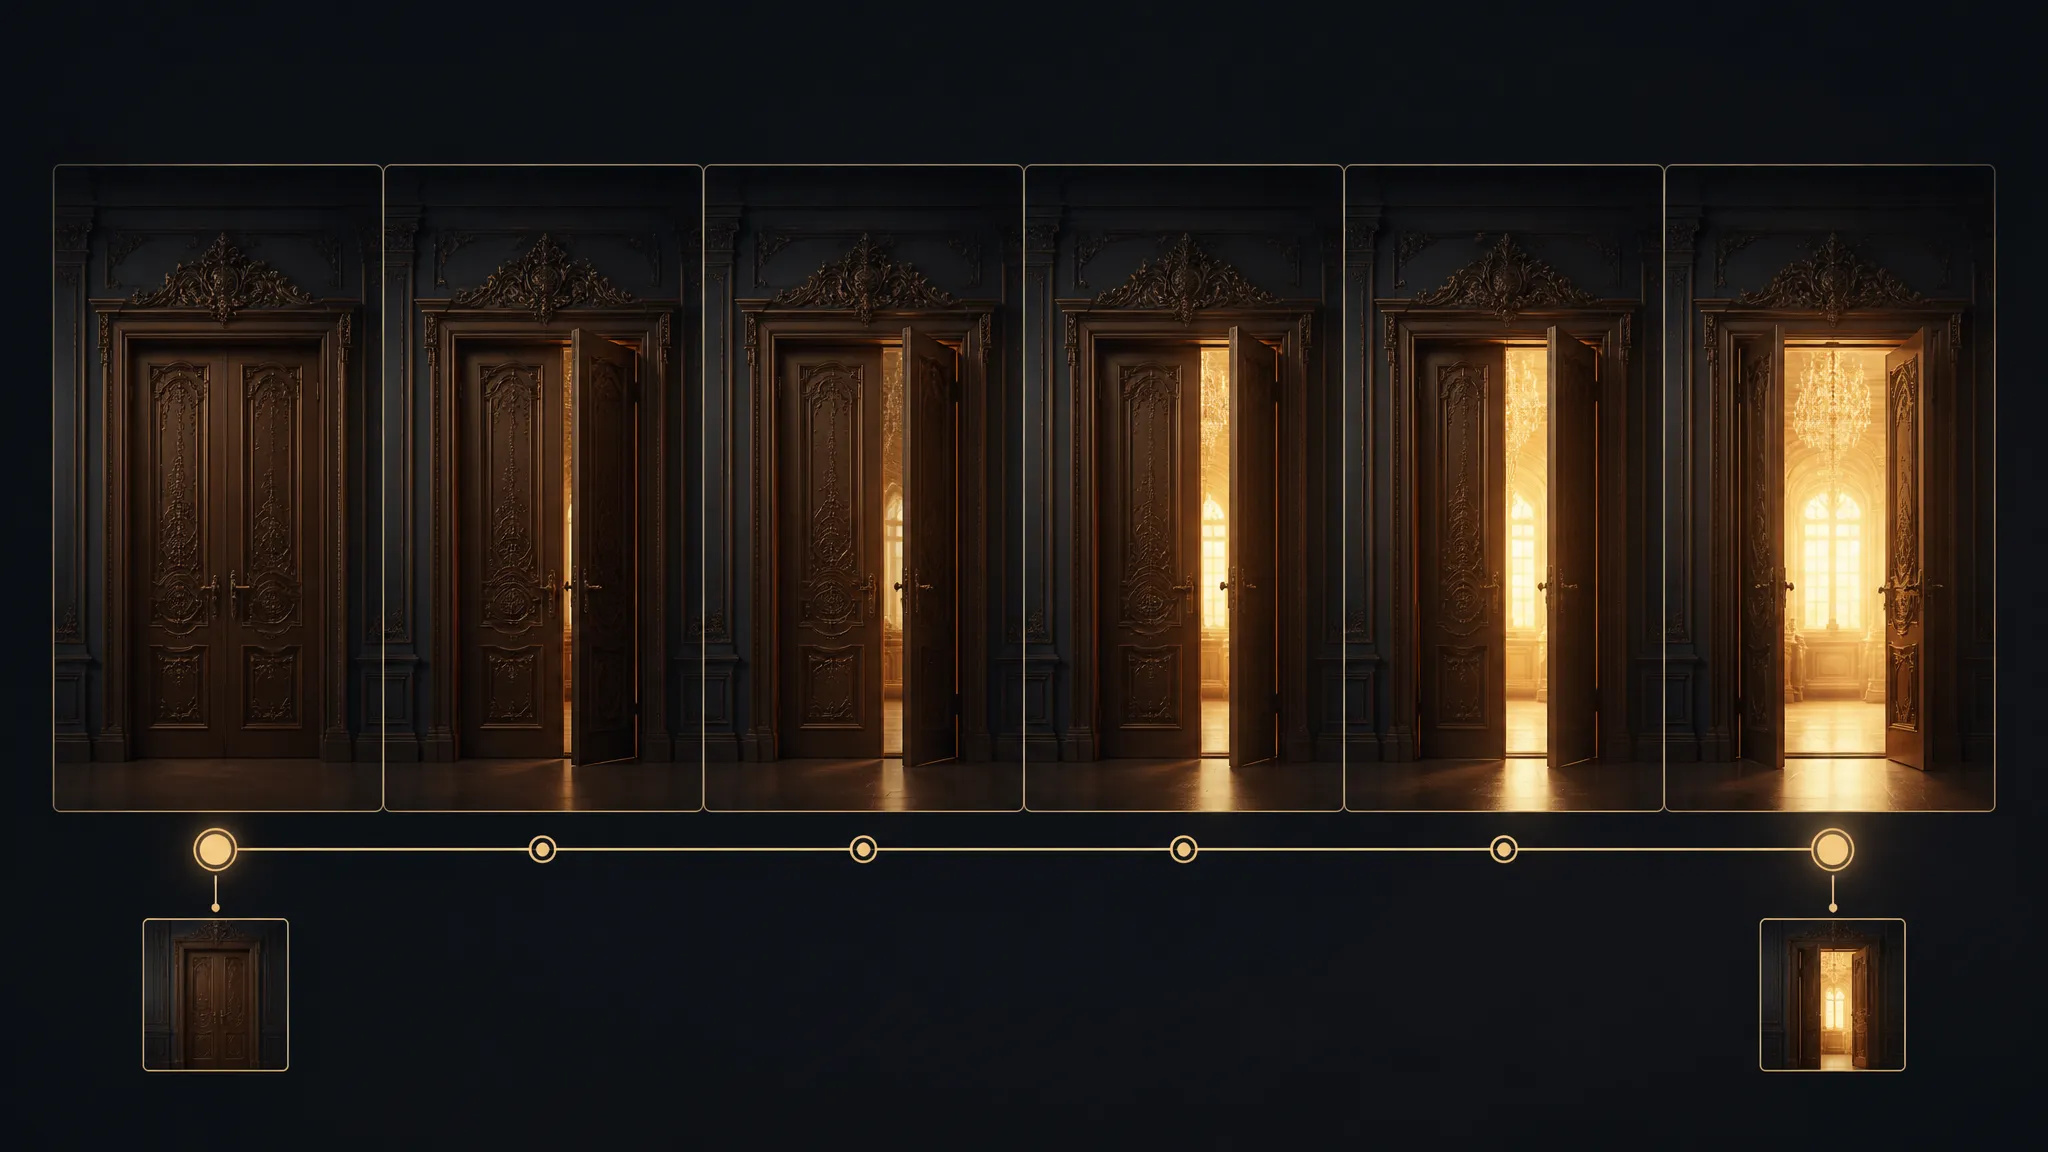
用兩端鎖住畫面走向,避免模型自由發揮跑到你不想要的方向。
從闔起到打開、從遠到近,起止狀態都是確定的產品圖。
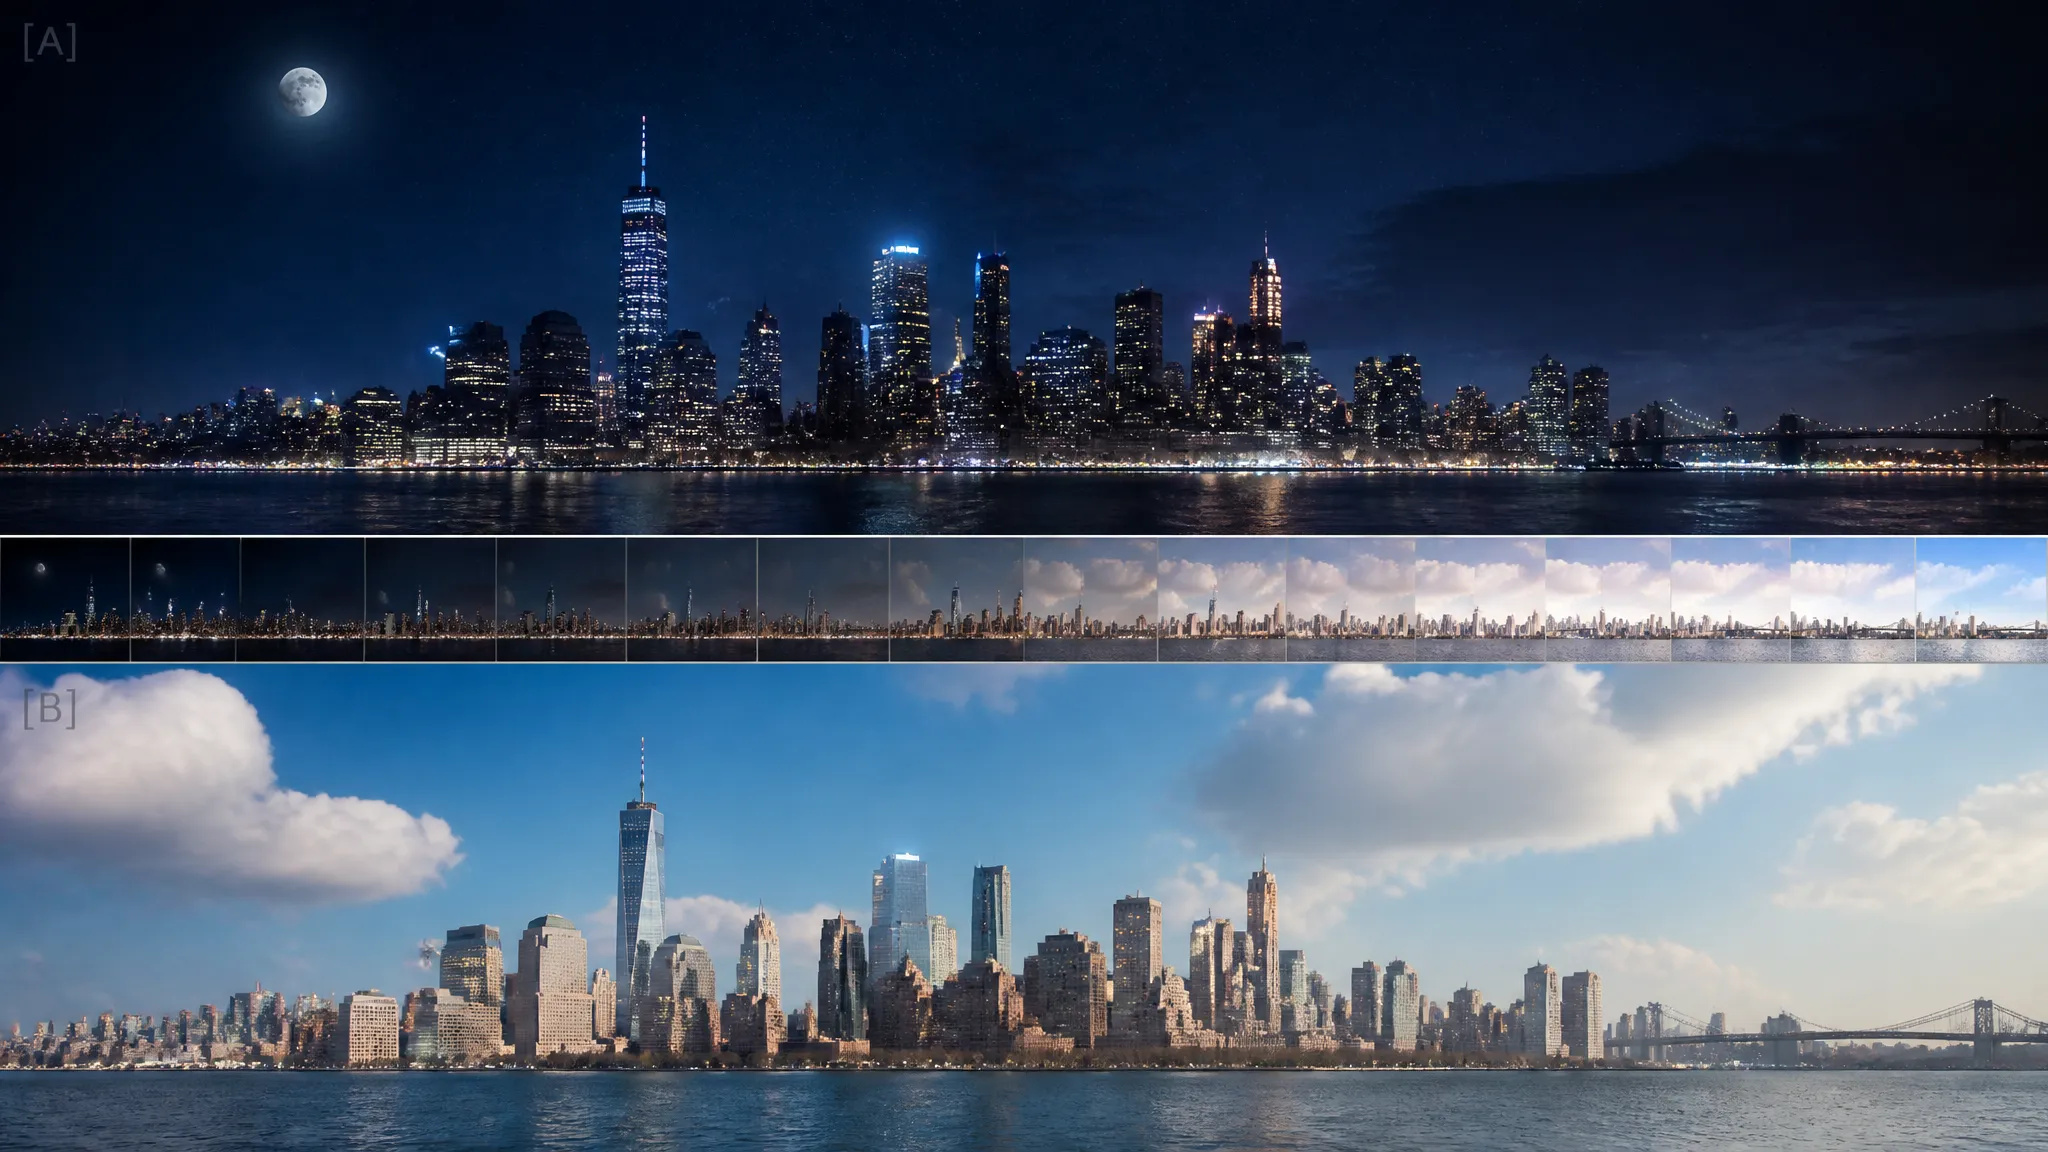
用前後兩個鏡頭的邊界影格生成過渡,接縫比硬切自然。
打開 AI 首尾影格生成影片,上傳第一格。
上傳最後一格,再用一句話補充中間該發生什麼。
選好長度和模型生成,然後下載或送進畫布。
從一張圖生成影片有個常見的挫敗感:模型動得很漂亮,但動到了你不想要的方向。你只給了起點,剩下的它自己決定。
首尾影格換了個思路:起點和終點都由你給,模型只負責補中間。畫面最終落在哪裡,在生成之前就已經確定了。
這個約束比任何提示詞都強。想讓產品從闔起變成打開、鏡頭從遠推到近、場景從白天轉到夜晚 —— 與其描述這個過程,不如直接給出兩端的樣子。
效果好不好,主要看你選的兩端:
同一場景的兩個狀態最理想 —— 闔起與打開、遠與近、白天與夜晚。模型能理解這是同一個東西的變化,中間的過渡就順。
完全無關的兩張圖會出問題 —— 模型只能硬湊一個過渡,中間往往出現變形或者突變。如果確實要從 A 跳到 B,那本來就該是一次硬切,不是補間。
只填首格也行 —— 這時它退化成從這張圖往後延續,效果接近圖生影片。要精確控制落點才需要填尾格。
首尾影格最適合「結果已經想清楚了」的時候。你腦子裡已經有起止畫面,需要的只是中間那段過渡 —— 這時給兩端比寫一段描述準得多。
反過來,方向還沒定的時候用它反而費勁,因為你得先做出兩張圖。那種階段用影片生成先試幾條更快。
一個實用的組合:先在圖像生成器裡出兩張關鍵畫面,再拿到這裡補間。這樣整條鏡頭的起止都是你挑過的畫面,而不是模型隨機給的。
圖生影片只給起點,模型自由決定往哪兒動 —— 結果可能很好,也可能不是你想的。首尾影格多給了一個終點,等於把畫面的走向框住了。想要確定的結果時用首尾影格,想看模型的想法時用圖生影片。
需要有合理的關聯。同一個場景的兩個狀態(闔起/打開、遠/近、白天/夜晚)效果最好。如果兩張圖完全無關,模型只能硬湊一個過渡,中間往往會出現變形或者突變。
可以用文字補充,比如說明是推近、旋轉還是形變。但首尾影格本身已經提供了最強的約束 —— 大部分情況下把兩端選對,比反覆調提示詞有效。
可以,只填首格就變成從這張圖往後延續,效果接近圖生影片。要精確控制落點才需要填尾格。
Prompt*
首幀*
尾幀
視頻分辨率*
時長*