Google

Gemini Omni 1.1 Flash

Google 最新影片模型:文生、圖生、參考、編輯、延長整合在一個模型裡,原生音訊,從 360p 草稿到 4K 成片。

無需訂閱
積分永不過期
瞭解更多

一次儲值積分,通用所有模型,想用再用。 · 按需儲值,不存在月度清零。

Powered by Google's API on ZOOOP

核心能力

生成、編輯、延長一個模型搞定

用文字或首幀生成,用參考圖掌控畫面,用一句話修改現有影片,或者把鏡頭往後延長。原本要換五個模型做的事,現在共用同一種寫法、同一種畫面風格。

每段影片都帶原生音訊

對白、音效、環境音和畫面在同一次生成裡產出,嘴型、腳步聲、室內底噪自然對齊。只想要環境音時,在提示詞裡寫「不要對白」「不要音樂」即可。

參考圖鎖住身分

最多加入 10 張角色、產品或場景參考圖,再加上最多 3 段、每段 3 秒的參考影片來帶動作和構圖。臉孔、服裝、包裝在整個鏡頭裡保持一致。

360p 草稿,4K 成片

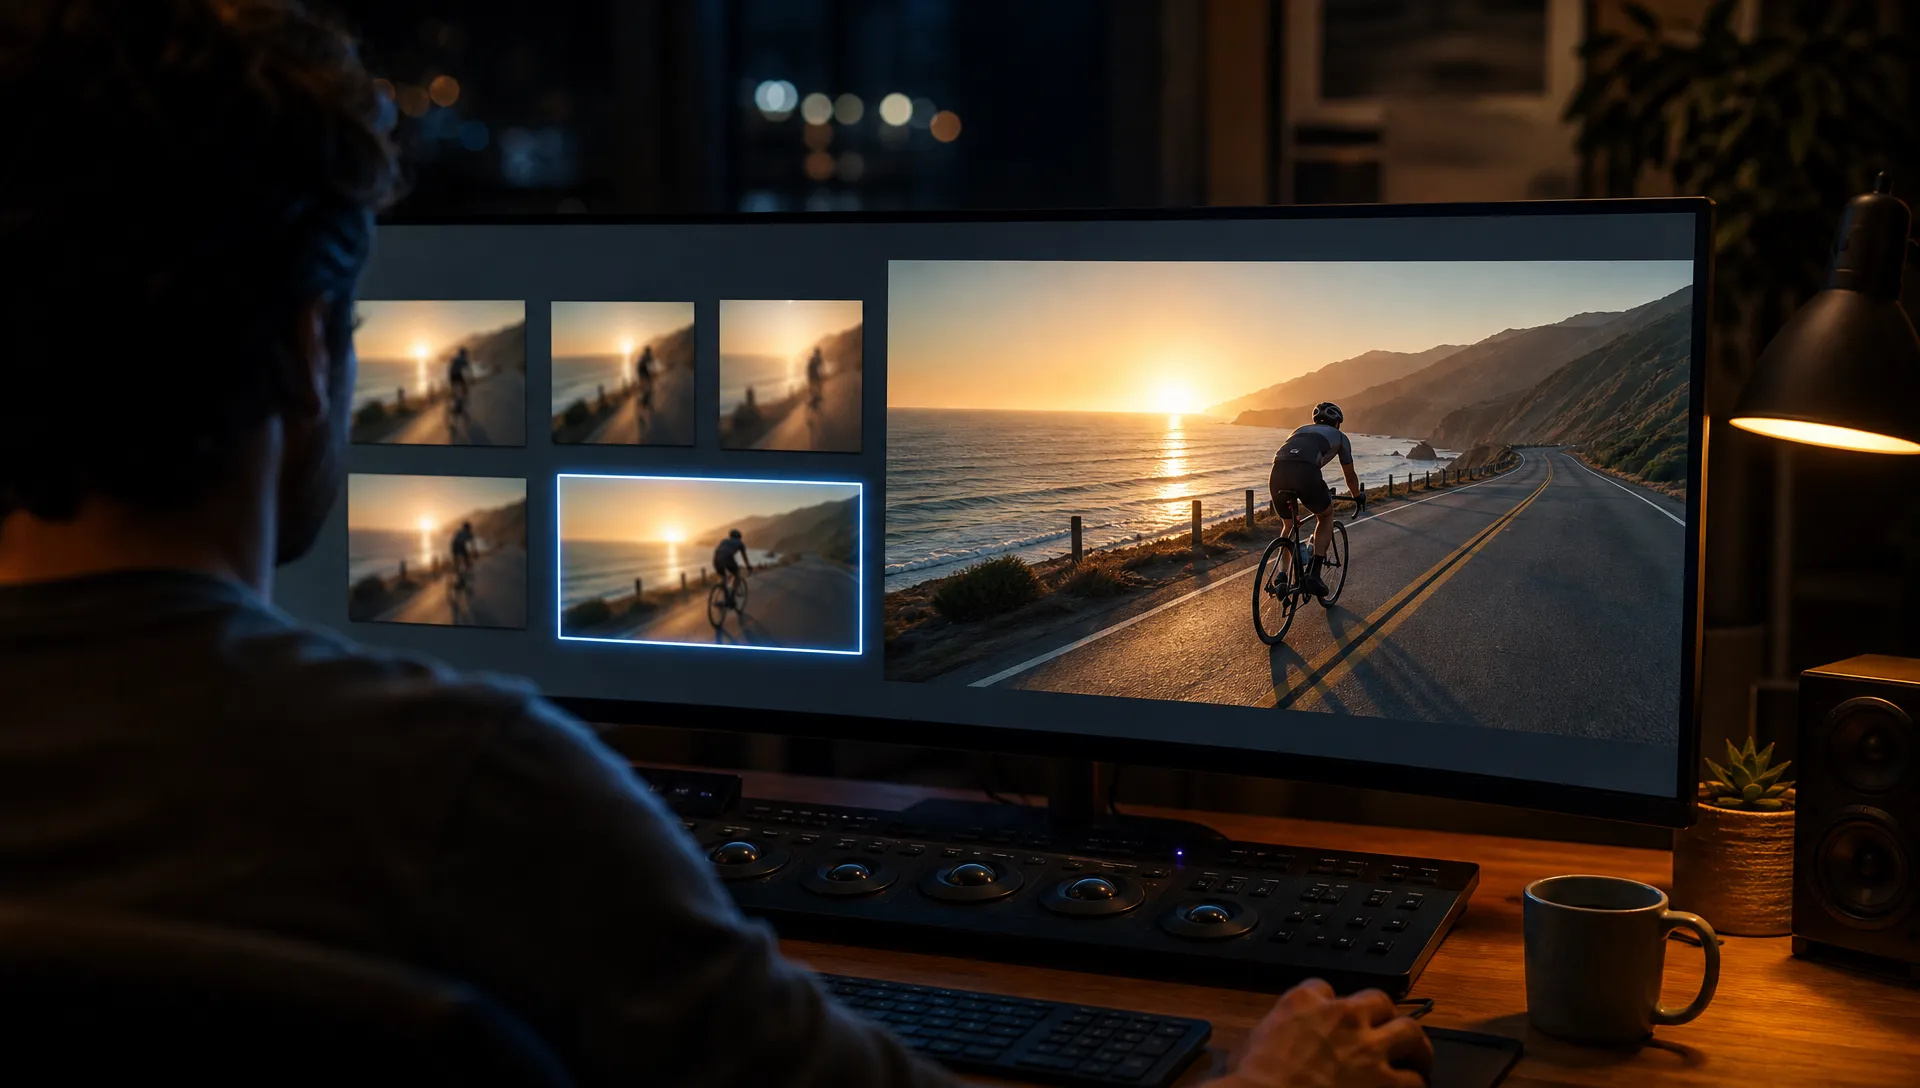
先用 360p 快速草稿等級找構圖,滿意的那一版再用 720p 輸出,交付時選 1080p 或 4K(由原生畫面放大而來)。

使用場景

草稿快速試,成片出 4K

草稿快速試,成片出 4K

同一個鏡頭先用 360p 試五個版本,挑出最好的一版,再用 1080p 或 4K 重新輸出給客戶。
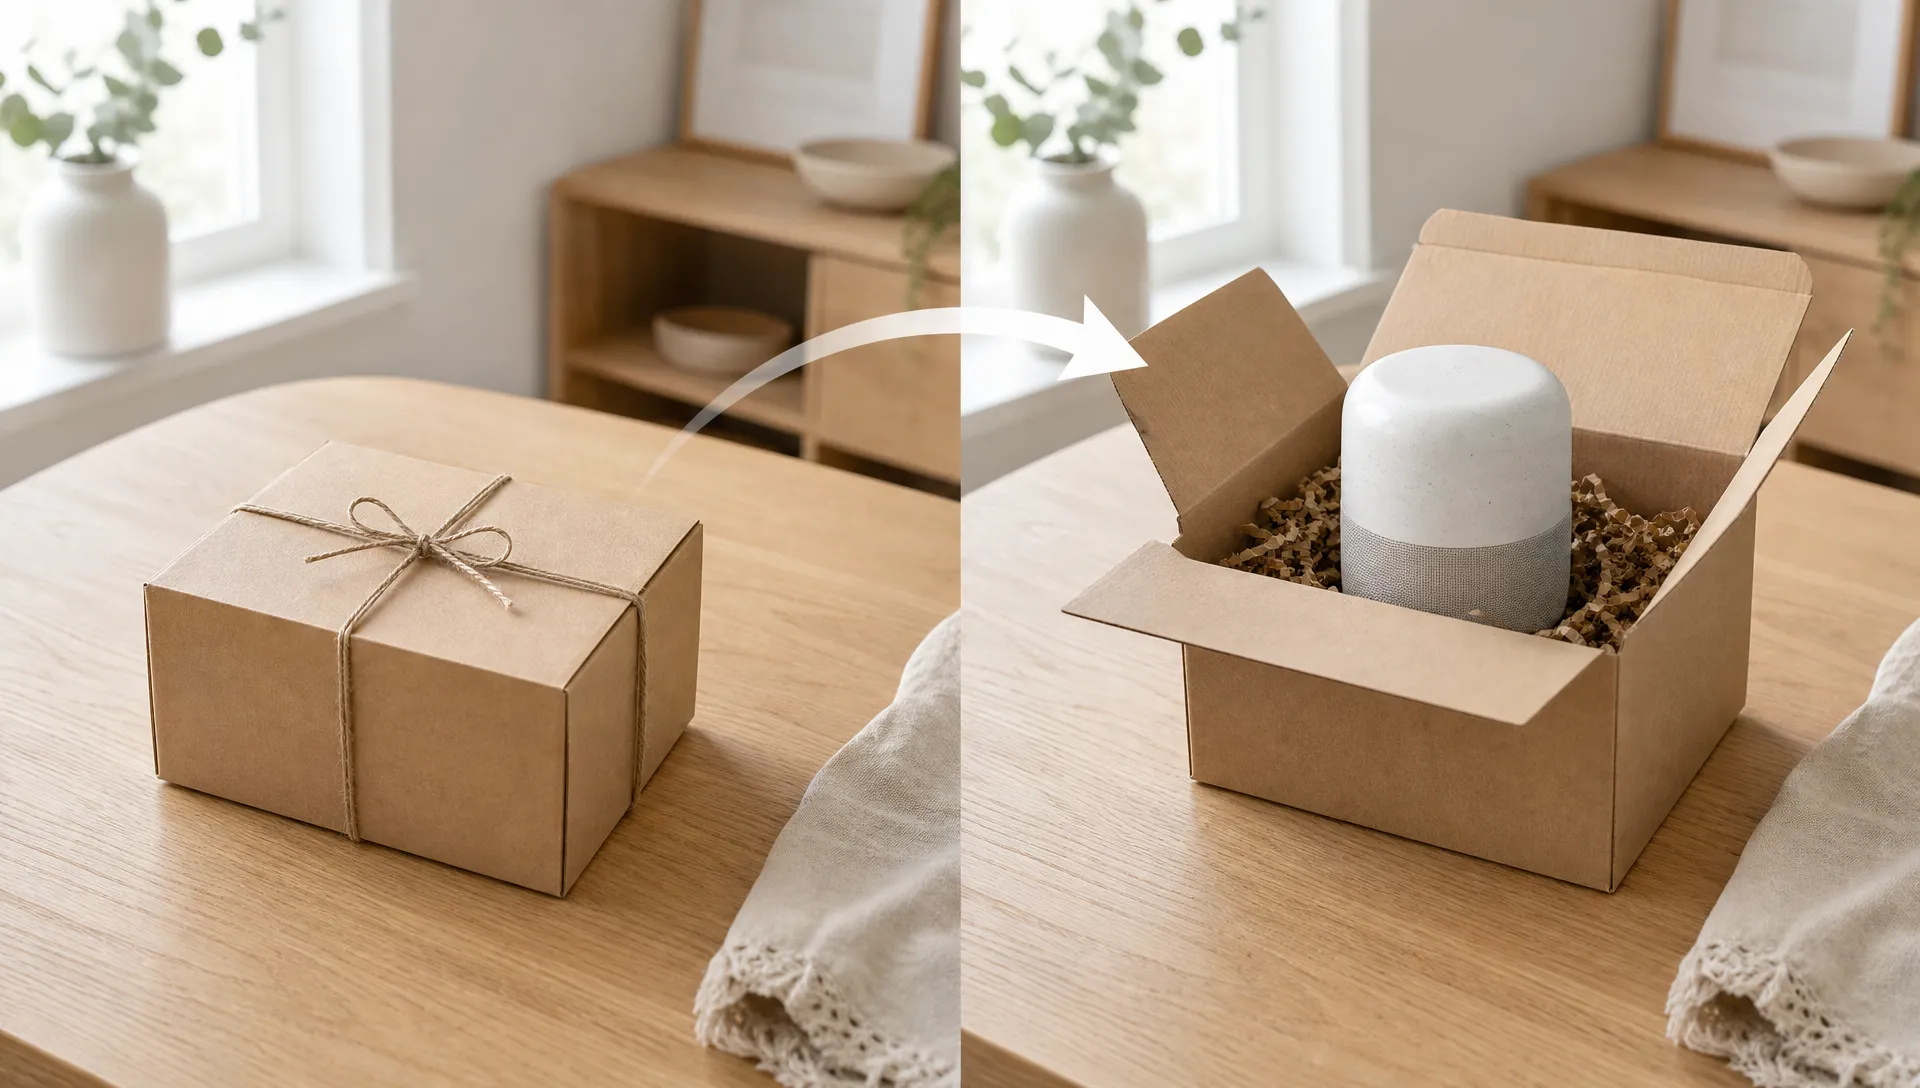
首尾幀轉場

首尾幀轉場

給一張首幀和一張尾幀(還沒拆的盒子和打開後的產品、草圖和裝潢好的房間),中間的過程交給模型補上。
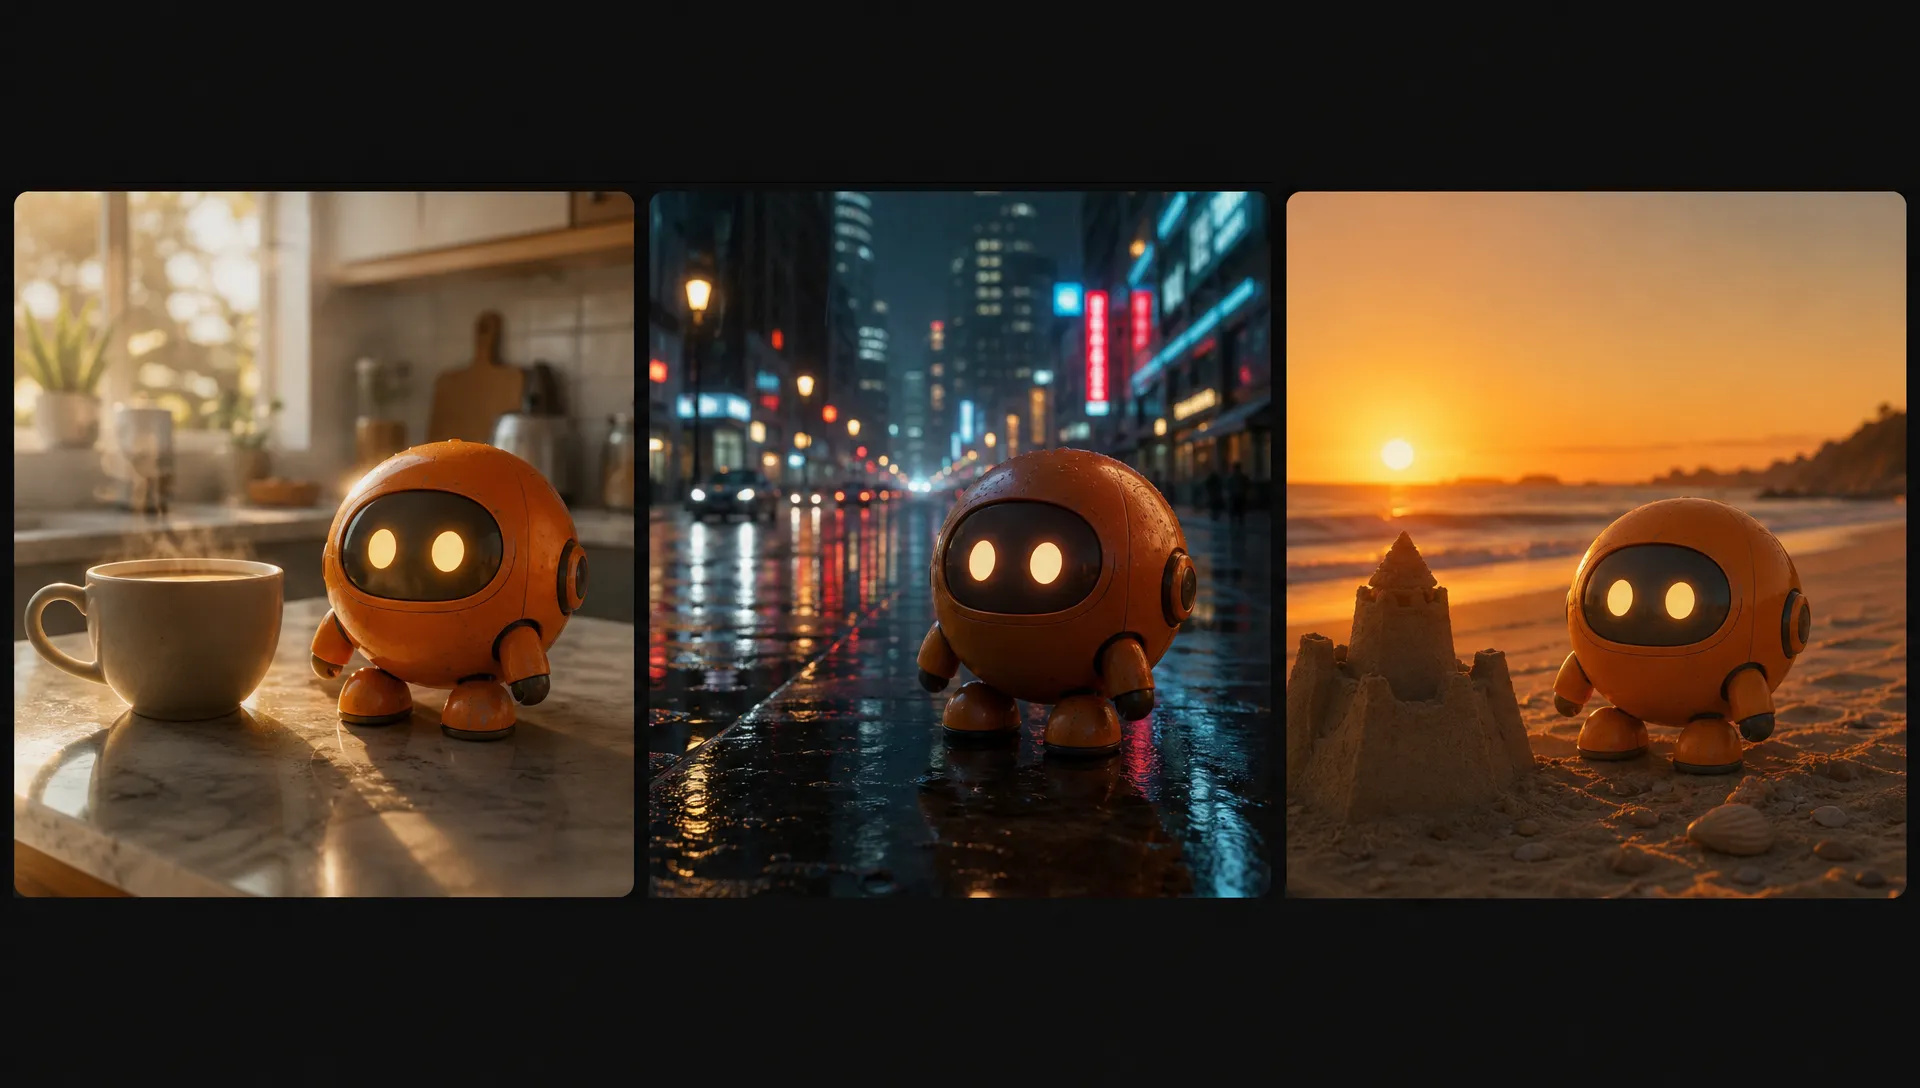
角色和產品前後一致

角色和產品前後一致

上傳吉祥物、模特兒或瓶子的多角度照片,放進新場景裡,鏡頭之間臉孔和標籤都不會走樣。
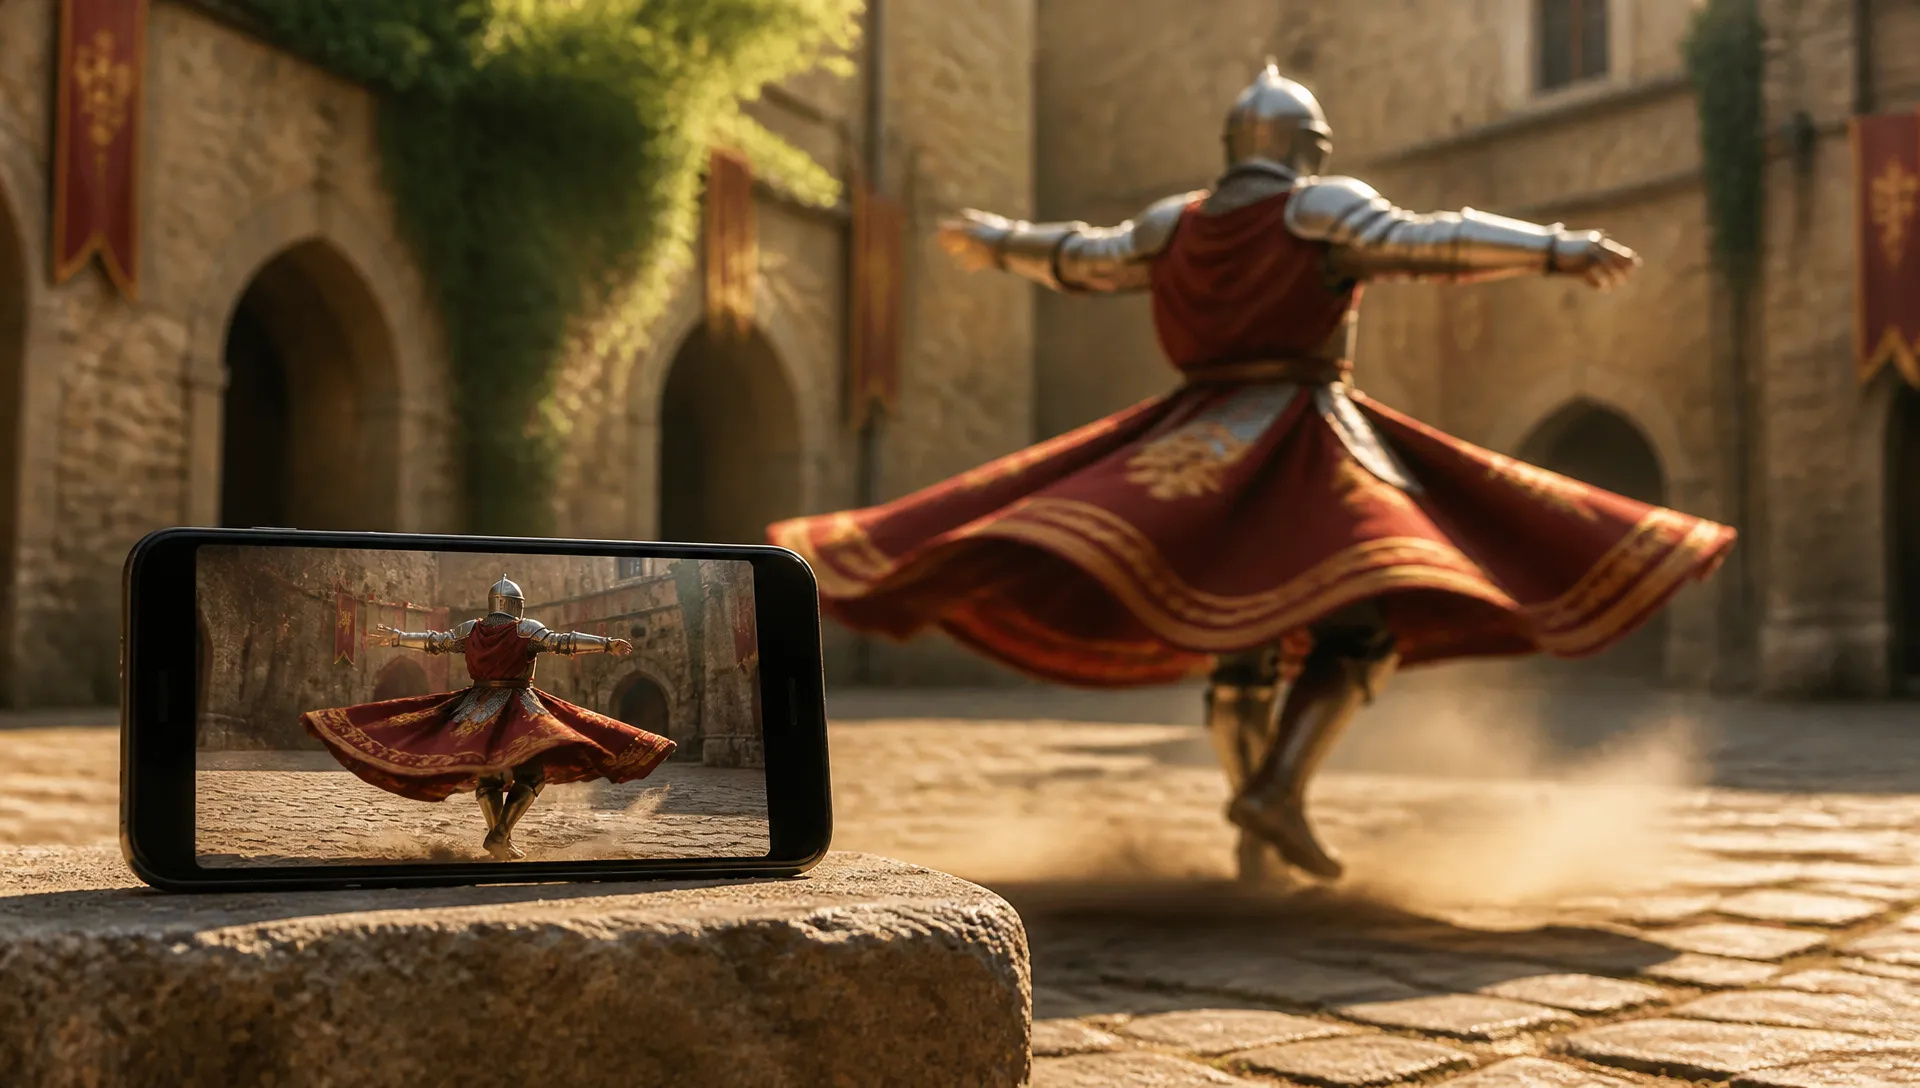
從短片裡借一個動作

從短片裡借一個動作

加入一段 3 秒的參考影片,內容是某個運鏡或手勢,讓你的角色在另一個場景裡照著做。
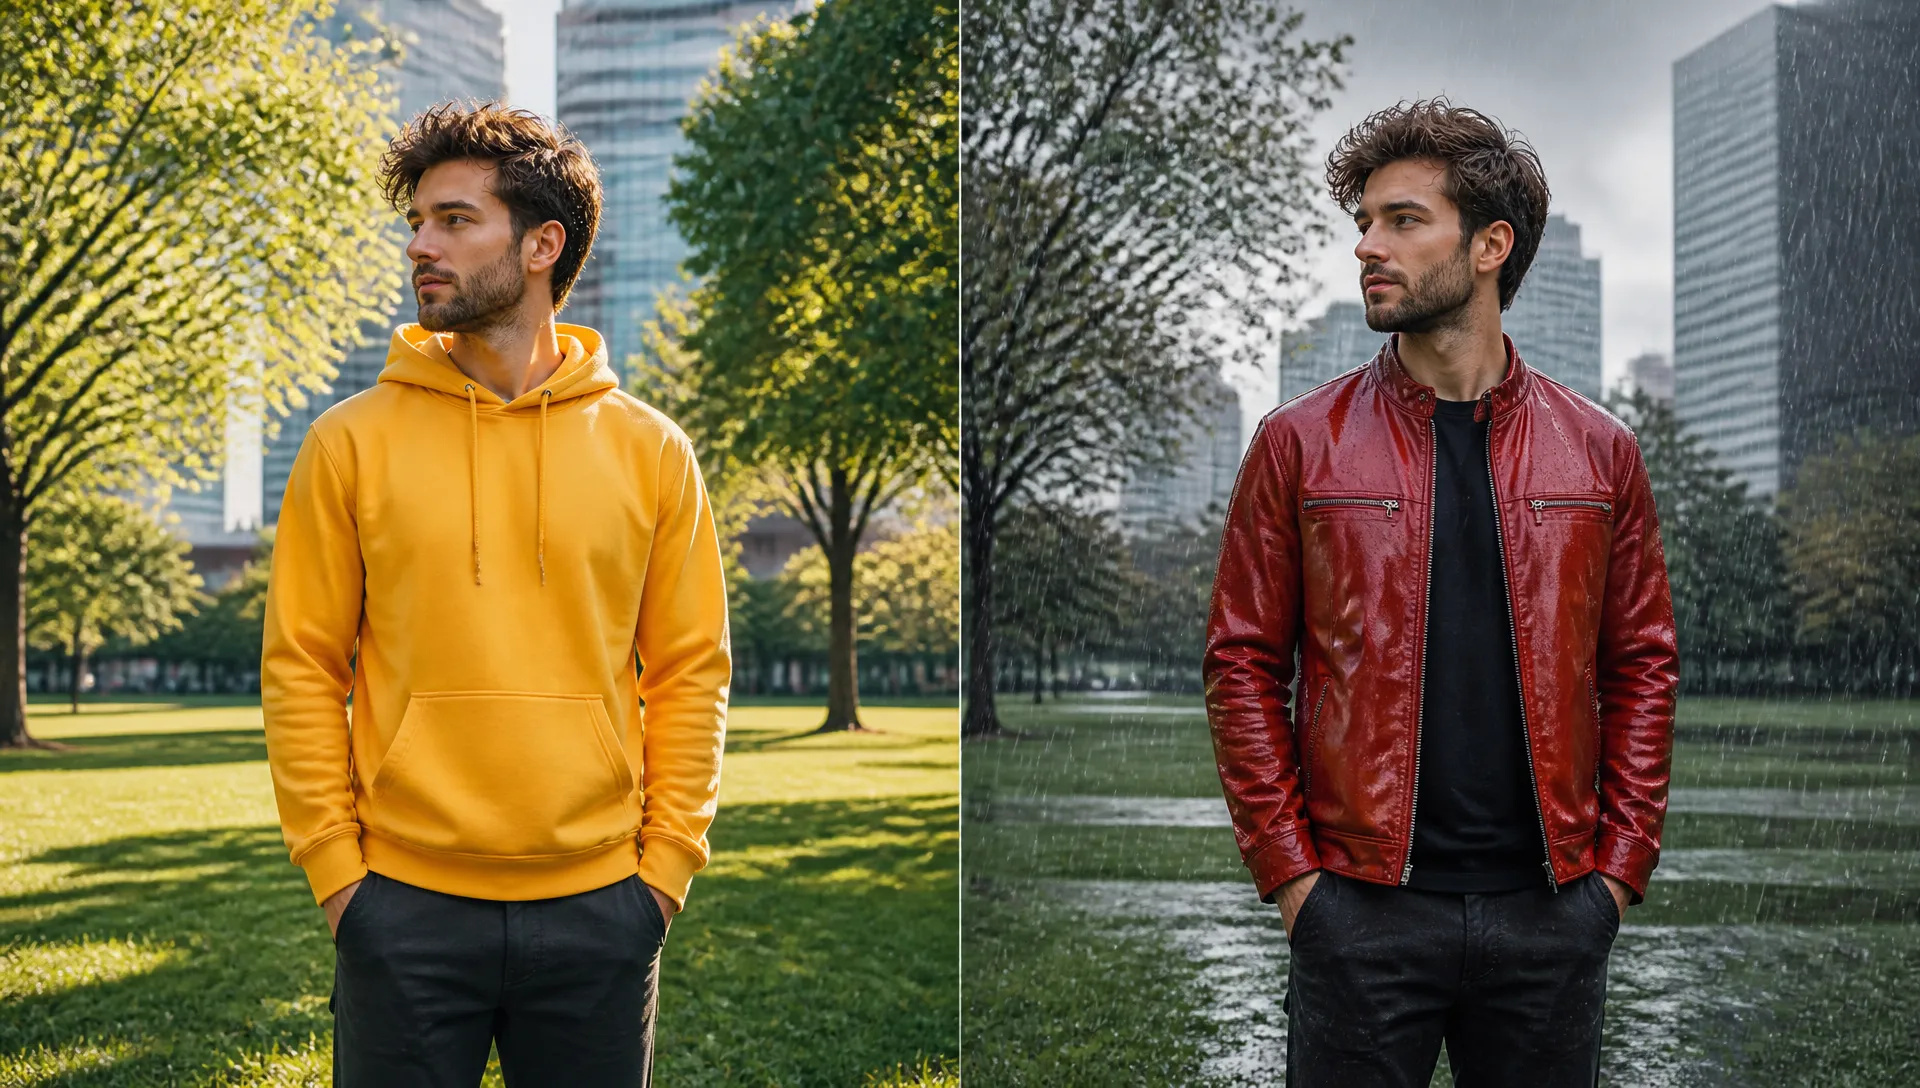
一句話修改素材

一句話修改素材

在最長 10 秒的影片裡換衣服、換天氣、換時段,人物、構圖和節奏保持不變。
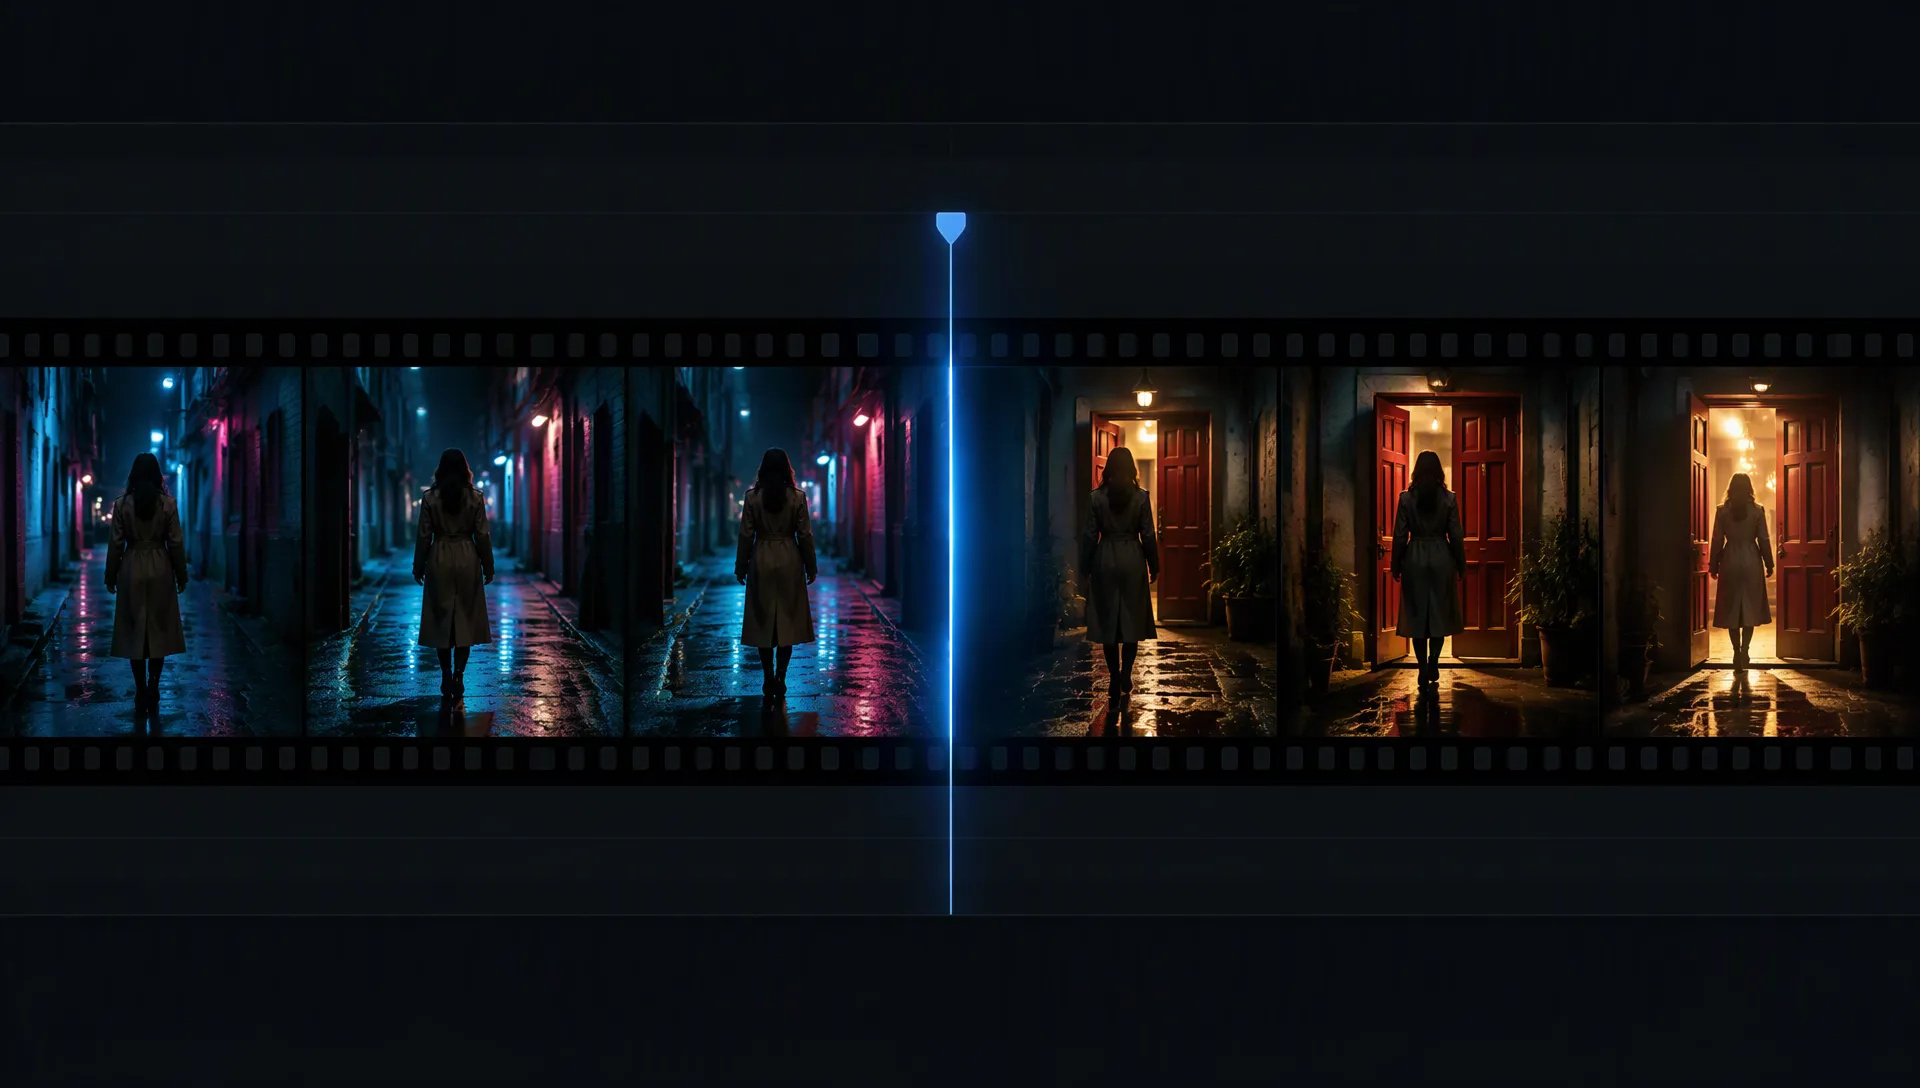
把鏡頭延續下去

把鏡頭延續下去

在片尾再加 3 到 10 秒:人繼續往前走、門終於打開、鏡頭持續漂移,聲音也接得上。

如何選對模型

Gemini Omni 1.1 Flash 是全能型選手:生成、編輯、延長帶聲音的影片都在一個模型裡。鏡頭需要它做不到的事時,再換下面的模型。

生成、編輯、延長帶原生音訊的影片,360p 草稿到 4KGemini Omni 1.1 Flash ←
把一個人換進現有的影片裡MiniMax H3
單段最長 30 秒、方形或 4:3 畫面比例Wan V3.0
多鏡頭敘事、編輯最長 30 秒的影片Seedance V2.5
把舞者的動作原樣套到角色身上Kling V3 Pro
一張照片加一段配音,做會說話的數位人Kling Avatar V2

如何使用

01

在本頁開啟 Gemini Omni 1.1 Flash,選擇模式:文生或參考、首幀、編輯、延長。

02

用自然語言描述鏡頭,包括運鏡,以及想要或不想要的聲音(英文提示詞效果最好)。

03

選擇時長(3 到 10 秒)、畫面比例(16:9 或 9:16)和解析度(360p 到 4K)。

04

生成後再調整提示詞,或把滿意的 360p 草稿換到更高解析度重新輸出。

深入瞭解

Gemini Omni 1.1 Flash 擅長什麼,不擅長什麼

Gemini Omni 1.1 Flash 解決的是每個影片工作流程都會遇到的問題:負責生成鏡頭的模型,往往沒辦法在事後修改它。影片出來了,外套顏色不對,或者鏡頭早結束了一秒,你只能換個模型、換種畫風從頭再來。Omni 把生成、編輯和延長放進了同一個模型、同一種畫面語言,而且聲音和畫面在同一次生成裡產出。Google 在 2026 年 8 月 27 日推出了它,並將它列為 Veo 3.1 系列的替代。

第一項核心能力是多模態參考。除了提示詞,你還可以加入最多 10 張圖片(角色的多個角度、產品、場景),以及最多 3 段、每段 3 秒的影片。圖片負責鎖住身分:臉孔、服裝、標籤在整個鏡頭裡保持穩定。短影片負責帶動作和構圖:一個推軌運鏡、一個手勢、走路的節奏。在我們的測試裡,兩張產品圖加一段 2.5 秒的公園影片,生成的就是這兩件產品在同一片草地、同樣的光線下滾過畫面。

第二項是一句話編輯。上傳最長 10 秒的影片,描述你要的修改:黃色帽T換成紅色皮夾克、晴天的街道下起雨、白天變成黃昏。人物、構圖和節奏保持不變,輸出的時長和橫直方向都跟隨原片。延長則是從另一頭下手:在片尾加 3 到 10 秒,讓人繼續往前走、讓門終於打開,聲音也一起接上。

第三項是從草稿到成片的階梯。360p 是快速草稿等級,用來找構圖。某個版本滿意了,就用原生最高等級 720p 再輸出一次,交付時選 1080p 或 4K(由原生畫面放大而來)。

不擅長的地方:單段只有 3 到 10 秒,畫面比例只有 16:9 和 9:16。需要更長的單一鏡頭或方形畫面時,Wan V3.0 最長可到 30 秒,並支援 1:1 和 4:3。聲音一直開著,只能引導、不能關閉。Google 的安全過濾比較嚴格,部分知名人物的照片會被拒絕,所以要把特定的人換進現有影片,MiniMax H3 更合適。要編輯超過 10 秒的影片,用 Seedance V2.5。

一個合理的用法:帶聲音、之後可能還要修改的影片,預設用 Gemini Omni 1.1 Flash,因為生成它的模型也能編輯和延長它。要把人換進現成素材找 MiniMax H3,長鏡頭或方形畫面找 Wan V3.0,多鏡頭敘事找 Seedance V2.5。

常見問題

Gemini Omni 1.1 Flash 是什麼?+

它是 Google 的多模態影片模型,2026 年 8 月 27 日推出。一個模型同時涵蓋文生影片、圖生影片(可加尾幀)、參考生影片、編輯現有影片和延長影片,全部自帶原生音訊。

它是 Veo 3.1 的替代嗎?+

是的。Google 官方將 Gemini Omni 1.1 Flash 列為 Veo 3.1、Veo 3.1 Fast、Veo 3.1 Lite 預覽版的替代模型,這幾款預計在 2026 年 10 月停用。在 ZOOOP 上,它涵蓋了這些模型能做的事,還多了編輯和延長。

一段影片最長多久?+

每次生成 3 到 10 秒。延長模式可以在最長 10 秒的影片後面再加 3 到 10 秒,也可以在畫布裡把多段串接成更長的作品。

能關掉聲音嗎?+

聲音一定會生成。可以在提示詞裡引導,例如寫「不要對白」「不要背景音樂」,或者生成後靜音。

4K 是原生的嗎?+

不是。Gemini Omni 1.1 Flash 原生生成 360p 和 720p,1080p 和 4K 是從這些畫面放大而來。探索階段用 360p,定稿再用高解析度。

上傳素材有什麼限制?+

編輯和延長的來源影片最長 10 秒,參考影片每段最長 3 秒(其中的聲音會被忽略)。Google 的安全過濾機制同時適用於提示詞和輸出,部分知名人物的照片會被拒絕。每段輸出都帶有 Google 肉眼看不見的 SynthID 浮水印。
更多模型

MiniMax
MiniMax H3
MiniMax
Wan AI
Wan V3.0
Wan AI
ByteDance
Seedance V2.5
ByteDance
Kling AI
Kling V3
Kling AI
OpenAI
GPT Image 2.5
OpenAI
OpenAI
GPT Image 2.0
OpenAI
ByteDance
Seedance V2.0
ByteDance
ByteDance
Seedance V2.0 Fast
ByteDance
ByteDance
Seedance V1.5 Pro
ByteDance
ByteDance
Seedance V1.0 Pro
ByteDance
ByteDance
Seedance V1.0 Pro Fast
ByteDance
ByteDance
Seedream 5.0 Pro
ByteDance
ByteDance
Seedream 5.0 Lite
ByteDance
ByteDance
Seedream 4.5
ByteDance
ByteDance
Seedream 4
ByteDance
ByteDance
Dreamactor V2
ByteDance
MiniMax
MiniMax H3 Max
MiniMax
MiniMax
Minimax Music V2.6
MiniMax
MiniMax
Minimax Music V2
MiniMax
MiniMax
Speech-2.8-HD
MiniMax
MiniMax
Speech-2.8-Turbo
MiniMax
Kling AI
Kling O3
Kling AI
Kling AI
Kling V3 Pro
Kling AI
Kling AI
Kling V2.6 Pro
Kling AI
Kling AI
Kling V2.6
Kling AI
Kling AI
Kling Lipsync
Kling AI
Kling AI
Kling Avatar V2
Kling AI
Kling AI
Kling O1
Kling AI
Midjourney
Midjourney V8.2
Midjourney
Midjourney
Midjourney V8.1
Midjourney
Midjourney
Midjourney
Midjourney
Alibaba
Happy Horse V1.1
Alibaba
Alibaba
Happy Horse
Alibaba
xAI
Grok Imagine V1.5
xAI
xAI
Grok Imagine
xAI
xAI
xAI TTS
xAI
Google
Nano Banana 2.1
Google
Google
Nano Banana Pro
Google
Google
Nano Banana 2
Google
Google
Nano Banana
Google
Google
Lyria 3 Pro
Google
Google
Lyria 3
Google
Google
Lyria2
Google
Google
Gemini 3.1 Flash TTS
Google
Wan AI
Wan V2.2
Wan AI
Wan AI
Wan V2.2 Turbo
Wan AI
Wan AI
Wan V2.5
Wan AI
Wan AI
Wan V2.6
Wan AI
Wan AI
Wan V2.6 Flash
Wan AI
Wan AI
Wan V2.7
Wan AI
Pixverse AI
Pixverse V6
Pixverse AI
Pixverse AI
Pixverse V5.5
Pixverse AI
Pixverse AI
Pixverse V5
Pixverse AI
Pixverse AI
Pixverse Lipsync
Pixverse AI
Vidu AI
Vidu Q4
Vidu AI
Vidu AI
Vidu Q3 Pro
Vidu AI
Vidu AI
Vidu Q3
Vidu AI
Vidu AI
Vidu Q3 Turbo
Vidu AI
Vidu AI
Vidu Q2 Pro
Vidu AI
Vidu AI
Vidu Q2 Turbo
Vidu AI
Flux AI
Flux 2 Pro
Flux AI
Flux AI
Flux 2
Flux AI
Flux AI
Flux 2 Flash
Flux AI
ElevenLabs
Multilingual V3
ElevenLabs
ElevenLabs
Multilingual V2
ElevenLabs
ElevenLabs
Sound Effects V2
ElevenLabs
Hailuo AI
Hailuo 2.3
Hailuo AI
Hailuo AI
Hailuo 2.3 Fast
Hailuo AI
Hailuo AI
Hailuo 02
Hailuo AI
Lightricks
LTX-2.3 Pro
Lightricks
Lightricks
LTX-2.3 Fast
Lightricks
Lightricks
LTX-2.3
Lightricks
Pika AI
Pika V2.2
Pika AI
Qwen
Qwen3-TTS
Qwen
Inworld
Inworld TTS
Inworld
Bilibili Index
Index TTS 2
Bilibili Index
Resemble AI
Chatterbox TTS Multilingual
Resemble AI
Open Source
ACE-Step
Open Source
Open Source
LUX TTS
Open Source
CassetteAI
Music Generator
CassetteAI
Recraft
Text to Vector V4.1
Recraft
Recraft
Text to Vector V4.1 Pro
Recraft
Recraft
Image to Vector
Recraft
Meta
Muse Image
Meta