xAI

Grok Imagine V1.5

xAI 的 Grok Imagine 1.5 影片模型——讓靜圖動起來、用文字寫場景,或用最多 7 張參考圖引導,全都帶原生同步音訊。

無需訂閱
積分永不過期
瞭解更多

一次儲值積分,通用所有模型,想用再用。 · 按需儲值,不存在月度清零。

Powered by xAI's API on ZOOOP

核心能力

頂尖圖生影片

Grok Imagine V1.5 在 Image-to-Video Arena 公開榜預覽階段拿下第一——相比 1.0,在運動品質和「單張靜圖如何忠實地變成動態鏡頭」上明顯進步。

原生同步音訊

每段影片都在同一次推論裡附帶同步音訊——對白、環境音、音效,說話角色還帶對嘴。無需單獨的運動模型、TTS 或 Foley 步驟。

更強時間一致性

1.5 的核心升級是穩定性——主體、面部、場景元素在整段影片裡保持一致,不再逐格飄移或扭曲。

三種開始方式,最長 15 秒

可以從一張圖開始、只用文字開始,或用最多 7 張參考圖開始,720p 或 480p、1 到 15 秒成片。文生和參考模式支援從 16:9 到 9:16 共七種畫面比例。

使用場景

讓靜態圖動起來

讓靜態圖動起來

傳一張靜圖——比如一張安靜的湖畔風景——Grok Imagine V1.5 一次推論就給它加上粼粼水波、搖曳枝葉和流動雲層並配環境音,無需手 K 關鍵影格。
產品圖動效

產品圖動效

把一張產品靜圖變成短展示或旋轉循環並配環境音——無需實拍,直接用於電商商品頁和社群。
社群原生直式短片

社群原生直式短片

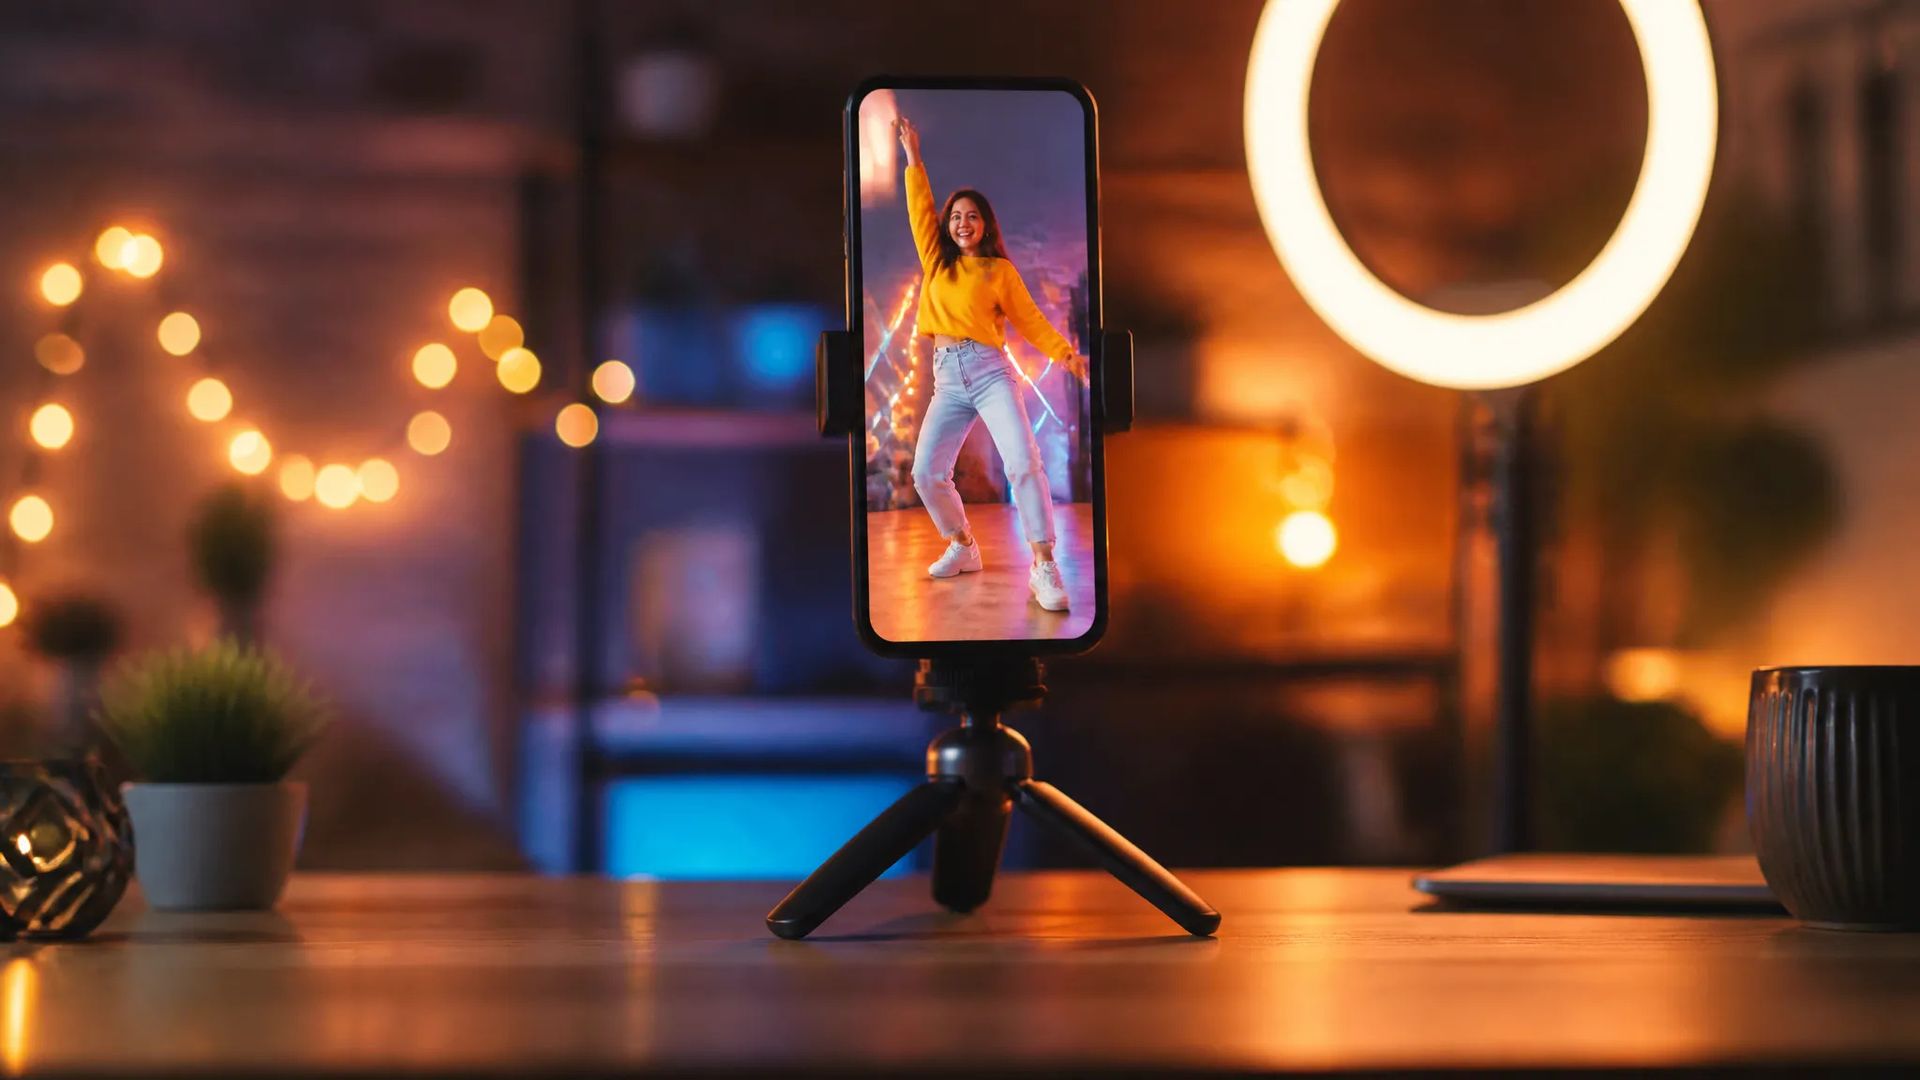
快速圖生影片 + 原生音訊,讓 V1.5 成為 TikTok / Reels 類短片的理想選擇——一張圖一步變成帶聲直式短片。
概念圖轉動態預演

概念圖轉動態預演

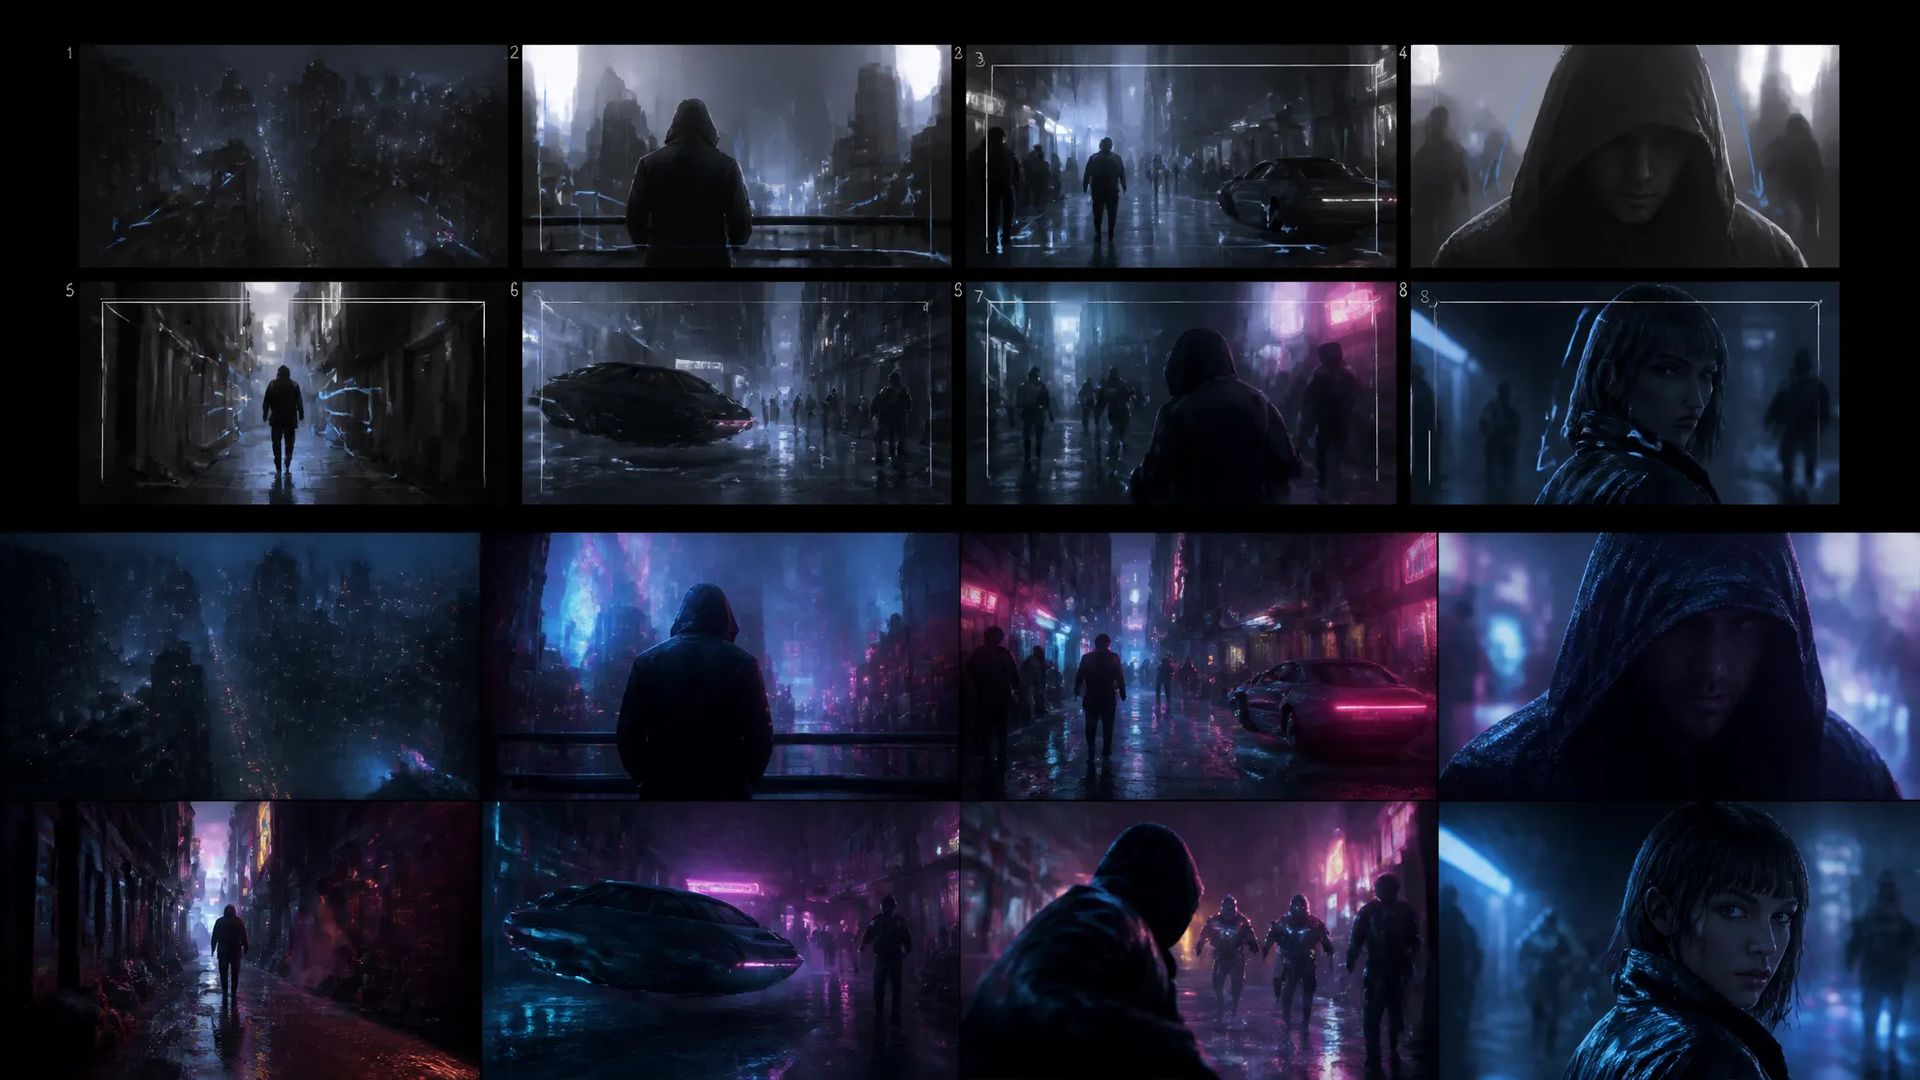
把一張場景概念圖——比如霓虹閃爍的賽博龐克街道——動起來,在交給更重的模型出定稿前先看看這個節拍動起來讀感如何。

如何選對模型

按場景挑影片模型。點數在 ZOOOP 上所有模型通用。

讓靜圖動起來 + 原生同步音訊Grok Imagine V1.5 ←
快速風格化圖像 + 影片,一個模型搞定Grok Imagine
1080p 電影感運動 + 多鏡頭Kling V3
最高畫質電影級影片Seedance V2.5
編輯或延長既有的影片Gemini Omni 1.1 Flash
最快 / 高 CP 值圖生影片Wan V2.6 Flash

如何使用

01

從本頁開啟 Grok Imagine V1.5,選擇模式:起始圖,或者文字(可加參考圖)。

02

上傳起始圖;或者寫好場景,附上最多 7 張參考圖。

03

寫描述運動的 prompt,然後設定解析度(720p 或 480p)和時長(1–15 秒)。

04

生成——原生同步音訊隨片一起出。

深入瞭解

Grok Imagine V1.5 擅長什麼——又不擅長什麼

Grok Imagine V1.5 是 xAI 做帶聲短影片的模型。你可以給它一張起始格和一段描述運動的 prompt,也可以從零寫一段場景,或附上最多 7 張人物、產品或風格參考圖,它在一次推論裡生成運動——外加原生同步音訊。預覽階段它在 Image-to-Video Arena 公開榜拿下第一,相比 1.0,在運動品質和「起始圖如何忠實地延續進動態鏡頭」上都明顯更強。

最突出的能力是原生同步音訊。每段影片回來時都帶著與畫面一起生成的對白、環境音和音效,說話角色還有對嘴。對一段帶聲社群短片或說話頭像影片,這把通常要三個工具的流程——運動模型、再 TTS、再 Foley——壓成一條 prompt。1.5 的第二個大提升是時間一致性:面部、主體、場景元素在整段影片裡保持一致,不再逐格飄移或扭曲——而這正是上一版最明顯的短板。

成片 1 到 15 秒、720p 或 480p,出片快,所以試一個運動想法、帶聲看一眼、再重出都很快。這種短的、帶聲的鏡頭正是它的甜蜜點。

它弱在哪:V1.5 不生成靜態圖片,所以如果想讓某張特定的畫面動起來,先用原版 Grok Imagine 或別的圖像模型出圖再餵進來。解析度上限 720p,不是 1080p 或 4K 的收尾模型——要高解析度交付,Kling V3 或 Seedance V2.5 是更對的目標。而且它動的是單一鏡頭,不是多鏡頭切換序列;要帶硬切的分鏡影片,換 Kling V3。

一個合理的心智模型:只要任務是「讓這張圖動起來,帶聲」或「把這個場景拍出來,帶聲」,就選 Grok Imagine V1.5——說話角色、產品動效、社群原生短片、快速預演。等需要更高解析度或多鏡頭剪輯時,把這個鏡頭交給更重的影片模型走定稿。

常見問題

Grok Imagine V1.5 是做什麼的?+

它是 xAI 帶原生同步音訊的影片模型。給一張起始圖和一段 prompt 就能讓靜圖動起來;寫一段場景就能文生影片;再加最多 7 張參考圖,能讓人物、產品或風格保持一致。它不生成靜態圖片。

Grok Imagine V1.5 的影片帶音訊嗎?+

帶——每段影片都在同一次推論裡附帶原生同步音訊(對白、環境音、音效),說話角色還帶對嘴。無需單獨的 TTS 或 Foley 步驟。

支援什麼解析度和時長?+

輸出 720p 或 480p,時長 1 到 15 秒(預設 5 秒)。文生和參考模式支援 16:9、4:3、3:2、1:1、3:4、2:3、9:16;起始圖模式跟隨起始圖的比例。它是為帶聲短鏡頭打造的,不面向長影片或 4K 交付。

V1.5 和原版 Grok Imagine 有什麼區別?+

V1.5 是更新的影片模型——預覽階段在 Image-to-Video Arena 拿第一,時間一致性和音訊都比 1.0 更好,並且圖生影片、文生影片、參考圖都支援。原版 Grok Imagine 還能生成和編輯靜態圖,也能編輯或延長影片。要畫面最好的帶聲短片用 V1.5;要出圖,或想一個模型走圖像加影片流程,用原版。

Grok Imagine V1.5 划算嗎?+

對帶聲短片很划算——原生音訊在同一次推論裡生成,省掉了普通流程裡單獨的配音、配樂、音效步驟。但要 1080p 收尾或多鏡頭序列,更重的影片模型才是更值的花法。
更多模型

xAI
Grok Imagine
xAI
Kling AI
Kling V3
Kling AI
ByteDance
Seedance V2.5
ByteDance
Google
Gemini Omni 1.1 Flash
Google
OpenAI
GPT Image 2.5
OpenAI
OpenAI
GPT Image 2.0
OpenAI
ByteDance
Seedance V2.0
ByteDance
ByteDance
Seedance V2.0 Fast
ByteDance
ByteDance
Seedance V1.5 Pro
ByteDance
ByteDance
Seedance V1.0 Pro
ByteDance
ByteDance
Seedance V1.0 Pro Fast
ByteDance
ByteDance
Seedream 5.0 Pro
ByteDance
ByteDance
Seedream 5.0 Flash
ByteDance
ByteDance
Seedream 5.0 Lite
ByteDance
ByteDance
Seedream 4.5
ByteDance
ByteDance
Seedream 4
ByteDance
ByteDance
Dreamactor V2
ByteDance
MiniMax
MiniMax H3
MiniMax
MiniMax
MiniMax H3 Max
MiniMax
MiniMax
Minimax Music V2.6
MiniMax
MiniMax
MiniMax H3 Max Turbo
MiniMax
MiniMax
Minimax Music V2
MiniMax
MiniMax
Speech-2.8-HD
MiniMax
MiniMax
Speech-2.8-Turbo
MiniMax
Kling AI
Kling V4
Kling AI
Kling AI
Kling O3
Kling AI
Kling AI
Kling V3 Pro
Kling AI
Kling AI
Kling V2.6 Pro
Kling AI
Kling AI
Kling V2.6
Kling AI
Kling AI
Kling Lipsync
Kling AI
Kling AI
Kling Avatar V2
Kling AI
Kling AI
Kling O1
Kling AI
Midjourney
Midjourney V8.2
Midjourney
Midjourney
Midjourney V8.1
Midjourney
Midjourney
Midjourney
Midjourney
Alibaba
Happy Horse V1.1
Alibaba
Alibaba
Happy Horse
Alibaba
xAI
xAI TTS
xAI
Google
Nano Banana 2.1
Google
Google
Nano Banana 2 Lite
Google
Google
Nano Banana Pro
Google
Google
Nano Banana 2
Google
Google
Nano Banana
Google
Google
Lyria 3 Pro
Google
Google
Lyria 3
Google
Google
Lyria2
Google
Google
Gemini 3.1 Flash TTS
Google
Wan AI
Wan V3.0
Wan AI
Wan AI
Wan V2.2
Wan AI
Wan AI
Wan V2.2 Turbo
Wan AI
Wan AI
Wan V2.5
Wan AI
Wan AI
Wan V2.6
Wan AI
Wan AI
Wan V2.6 Flash
Wan AI
Wan AI
Wan V2.7
Wan AI
Pixverse AI
Pixverse V6
Pixverse AI
Pixverse AI
Pixverse V5.5
Pixverse AI
Pixverse AI
Pixverse V5
Pixverse AI
Pixverse AI
Pixverse Lipsync
Pixverse AI
Vidu AI
Vidu Q4
Vidu AI
Vidu AI
Vidu Q3 Pro
Vidu AI
Vidu AI
Vidu Q3
Vidu AI
Vidu AI
Vidu Q3 Turbo
Vidu AI
Vidu AI
Vidu Q2 Pro
Vidu AI
Vidu AI
Vidu Q2 Turbo
Vidu AI
Flux AI
Flux 2 Pro
Flux AI
Flux AI
Flux 2
Flux AI
Flux AI
Flux 2 Flash
Flux AI
ElevenLabs
Multilingual V3
ElevenLabs
ElevenLabs
Multilingual V2
ElevenLabs
ElevenLabs
Sound Effects V2
ElevenLabs
Hailuo AI
Hailuo 2.3
Hailuo AI
Hailuo AI
Hailuo 2.3 Fast
Hailuo AI
Hailuo AI
Hailuo 02
Hailuo AI
Lightricks
LTX-2.3 Pro
Lightricks
Lightricks
LTX-2.3 Fast
Lightricks
Lightricks
LTX-2.3
Lightricks
Pika AI
Pika V2.2
Pika AI
Qwen
Qwen3-TTS
Qwen
Inworld
Inworld TTS
Inworld
Bilibili Index
Index TTS 2
Bilibili Index
Resemble AI
Chatterbox TTS Multilingual
Resemble AI
Open Source
ACE-Step
Open Source
Open Source
LUX TTS
Open Source
CassetteAI
Music Generator
CassetteAI
Recraft
Text to Vector V4.1
Recraft
Recraft
Text to Vector V4.1 Pro
Recraft
Recraft
Image to Vector
Recraft
Meta
Muse Image
Meta