토킹 아바타
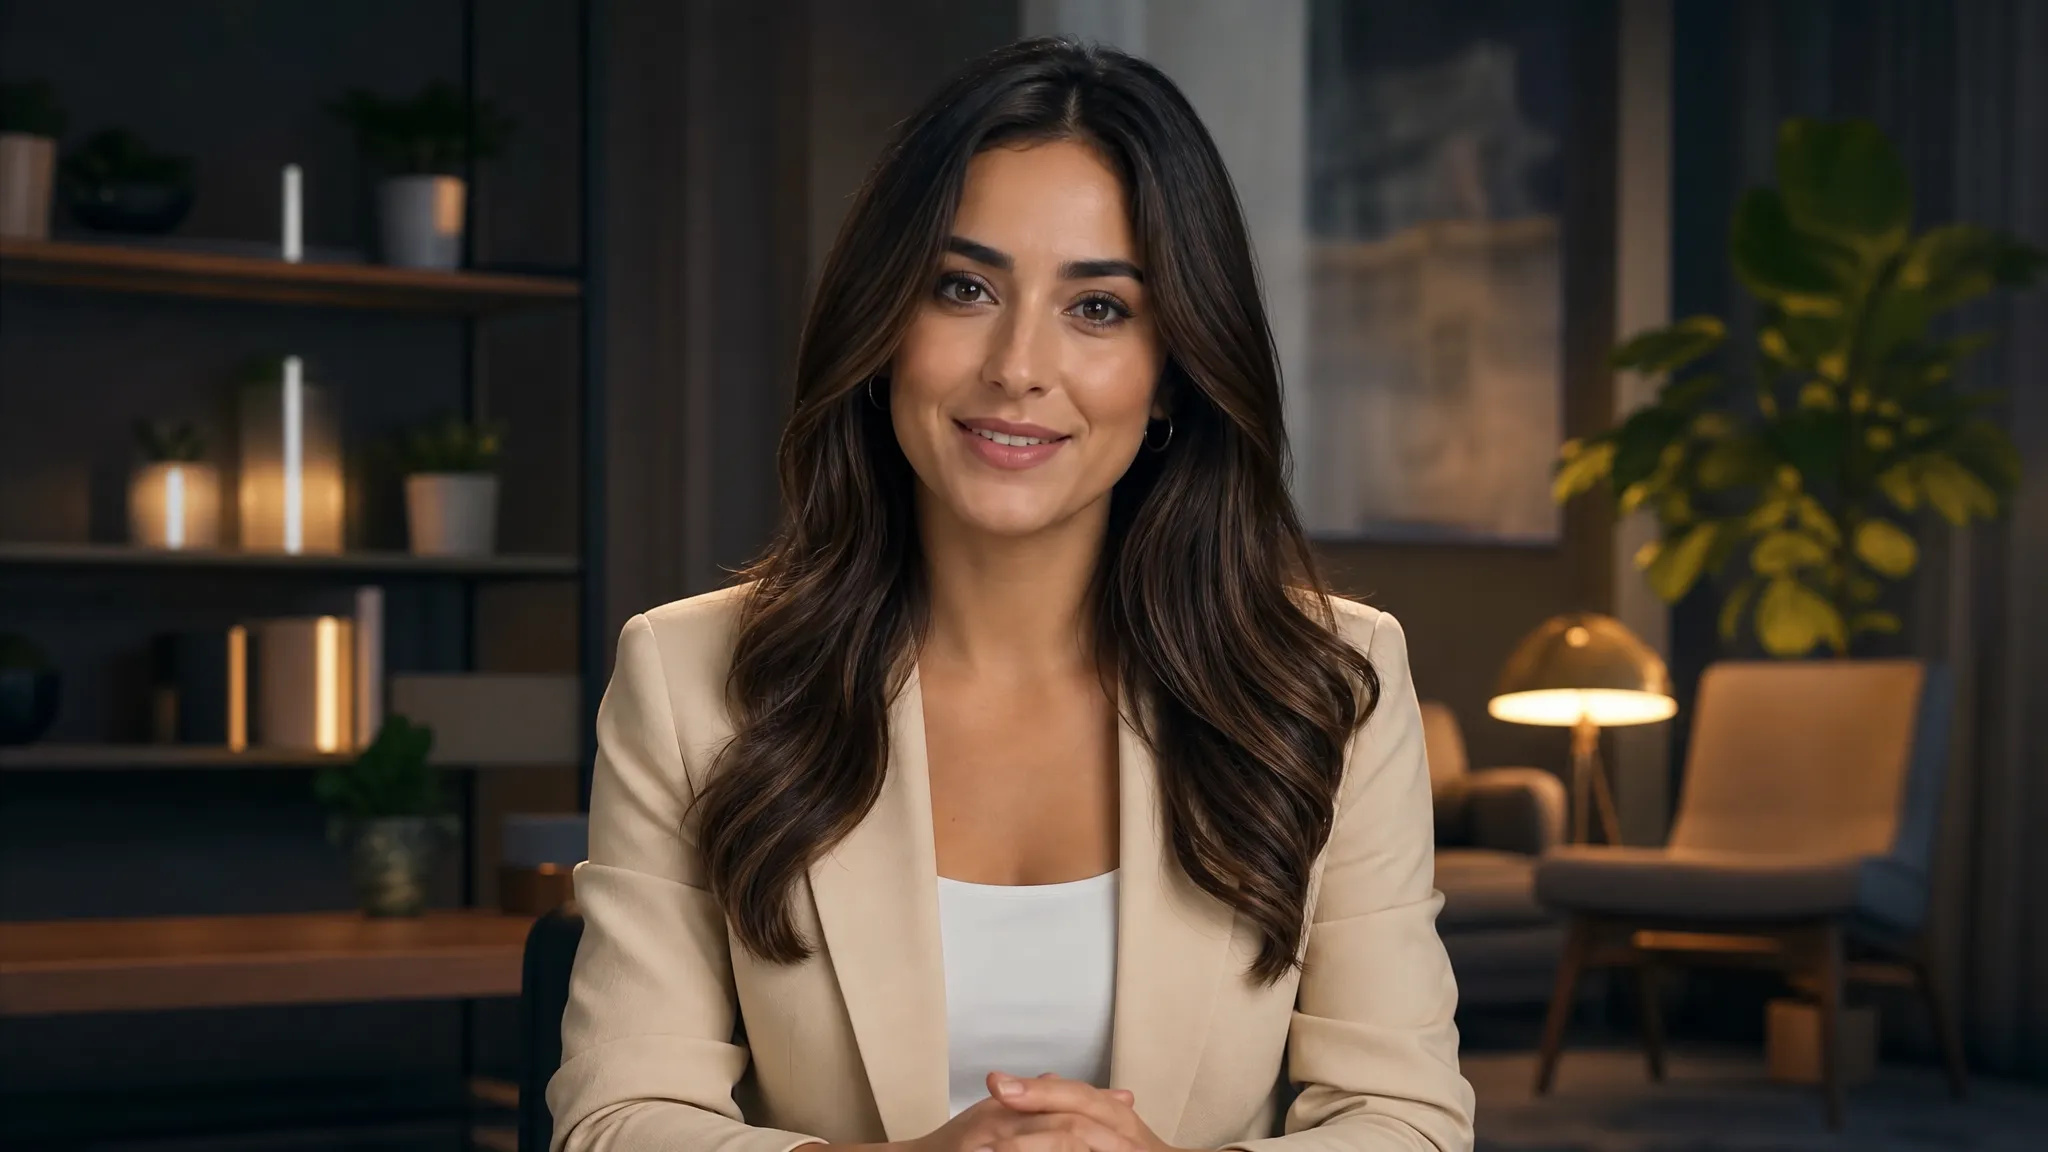
인물 사진 한 장과 보이스 트랙이면 발표자 영상이 됩니다 — 카메라 앞에 설 일도, 촬영도 없습니다.
오디오와 얼굴만 주면 화면 속 인물이 정확히 그 말을 합니다 — 입 모양까지 맞춰서. 토킹 아바타, 더빙, 언어별 버전을 만드는 도구입니다.
촬영이 필요 없습니다. 사진 한 장이나 클립 하나에 오디오를 더하면 그 사람이 그 말을 하는 영상이 나옵니다.
모델이 오디오의 음절에 맞춰 정렬합니다. 영상 모델에 "말하고 있다"고 프롬프트를 쓰는 방식보다 훨씬 안정적입니다 — 그쪽은 대개 입만 움직이는 영상이 나옵니다.
같은 푸티지 아래에 다른 언어 트랙을 깔면 입이 새 언어를 따라갑니다. 해외 버전을 위해 다시 찍을 필요가 없습니다.
정지 사진을 말하는 클립으로 만드는 데 강한 모델이 있고, 기존 영상을 다시 더빙하는 데 강한 모델이 있습니다. 같은 소재를 다른 모델로 다시 돌려보세요.
인물 사진 한 장과 보이스 트랙이면 발표자 영상이 됩니다 — 카메라 앞에 설 일도, 촬영도 없습니다.
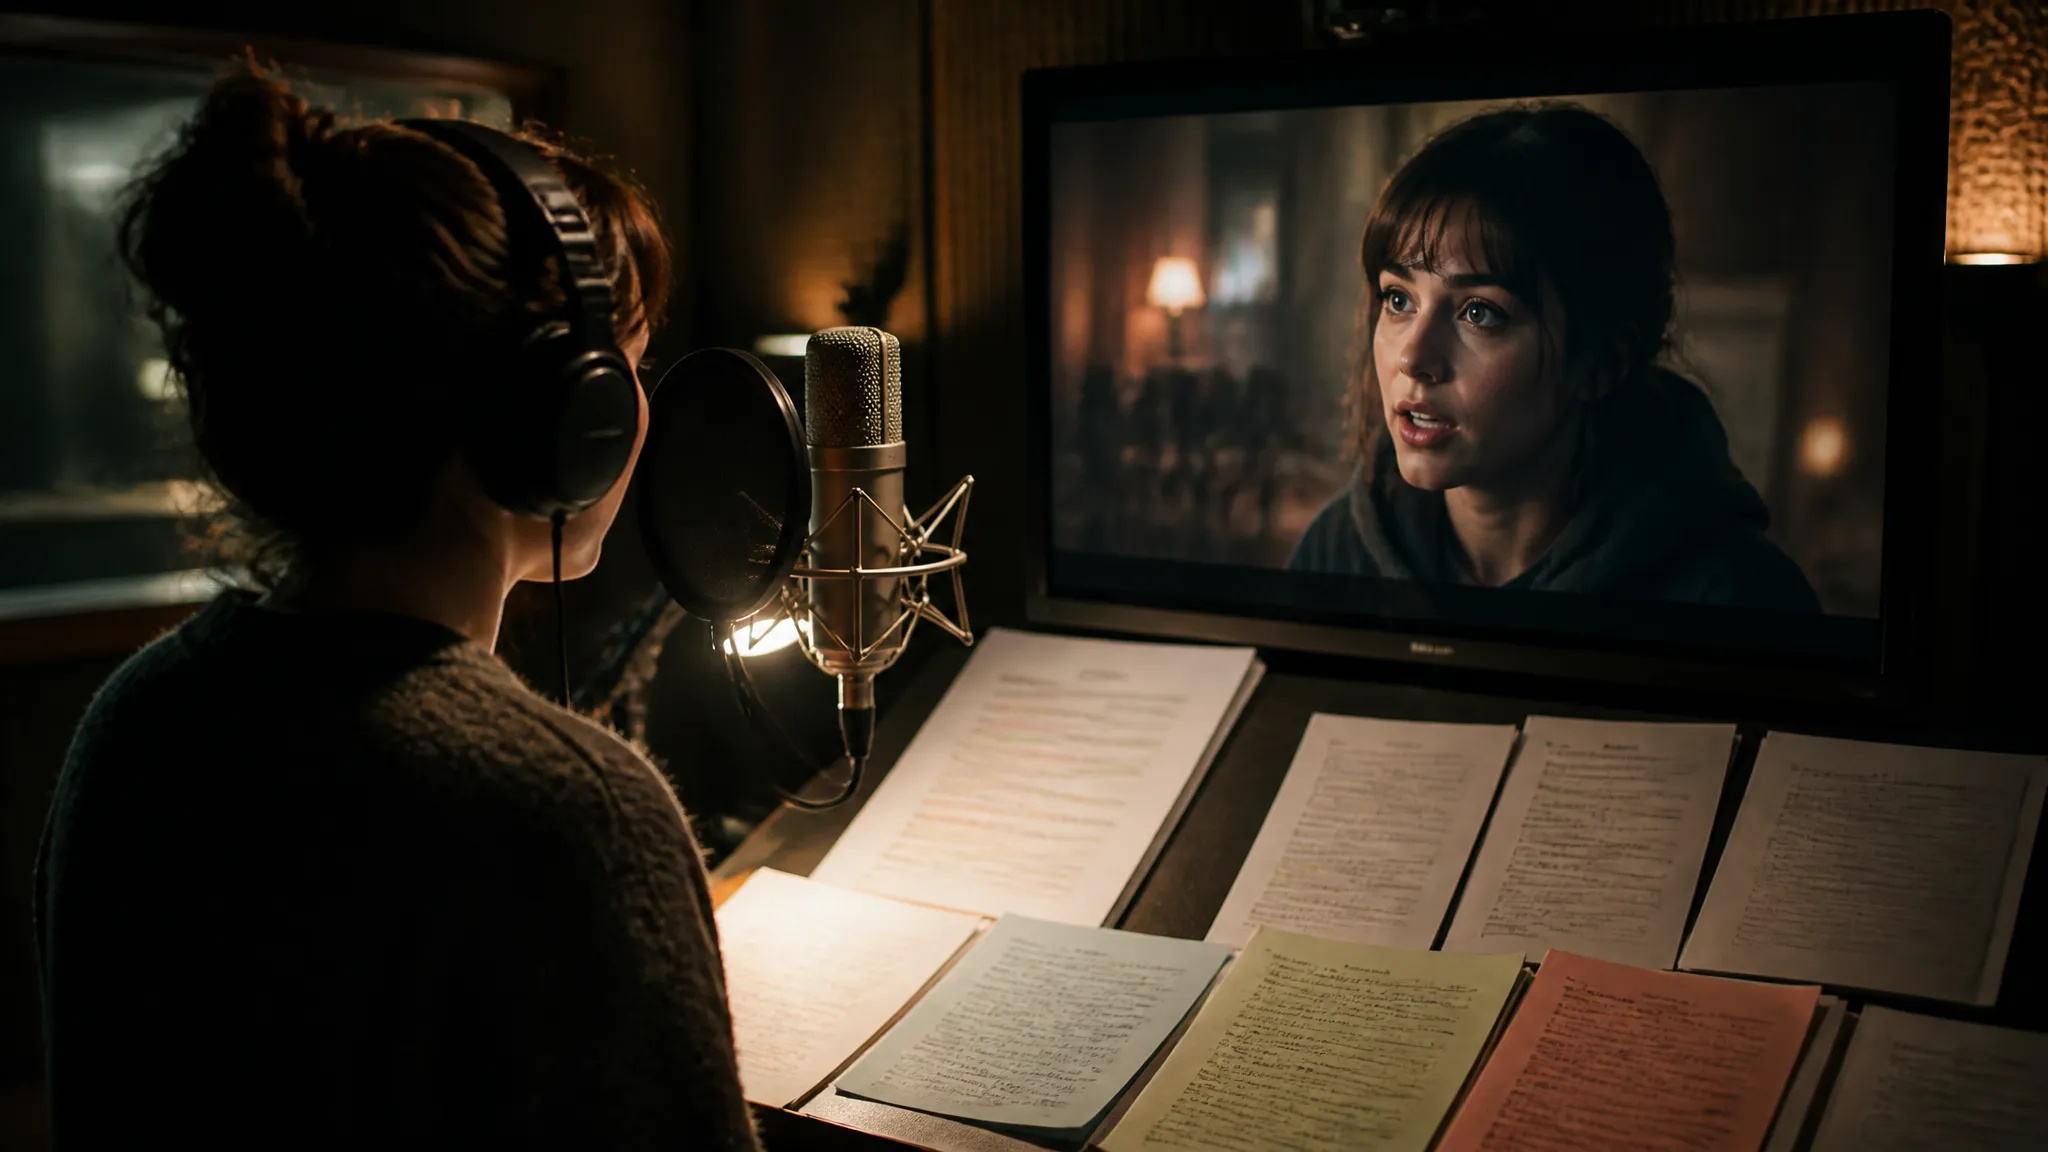
기존 영상 아래에 새 보이스 트랙을 깔면 입만 다시 맞춰지고 화면은 그대로 유지됩니다.
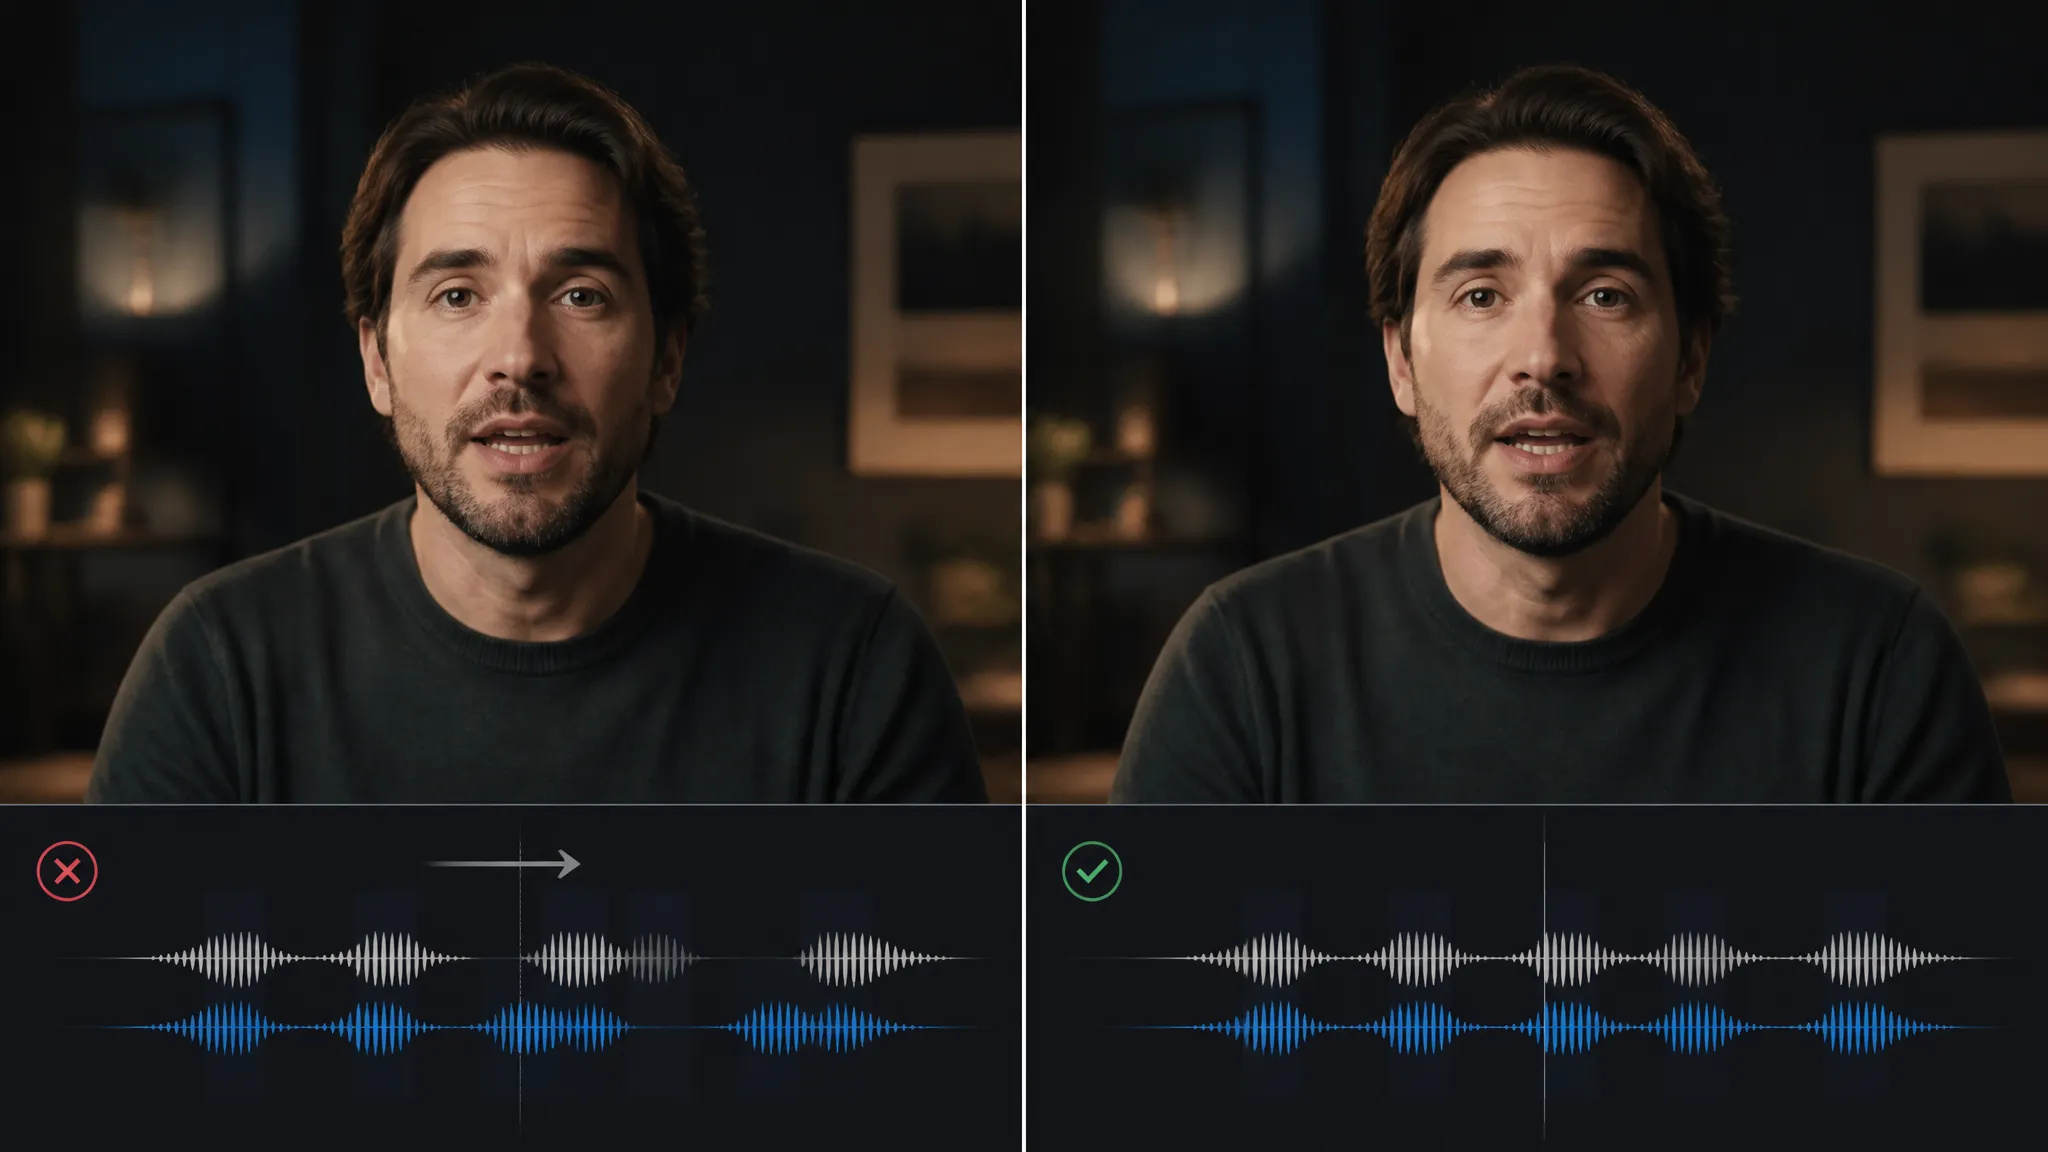
AI로 생성한 클립의 입이 대사와 맞지 않을 때, 여기서 다시 맞추세요.
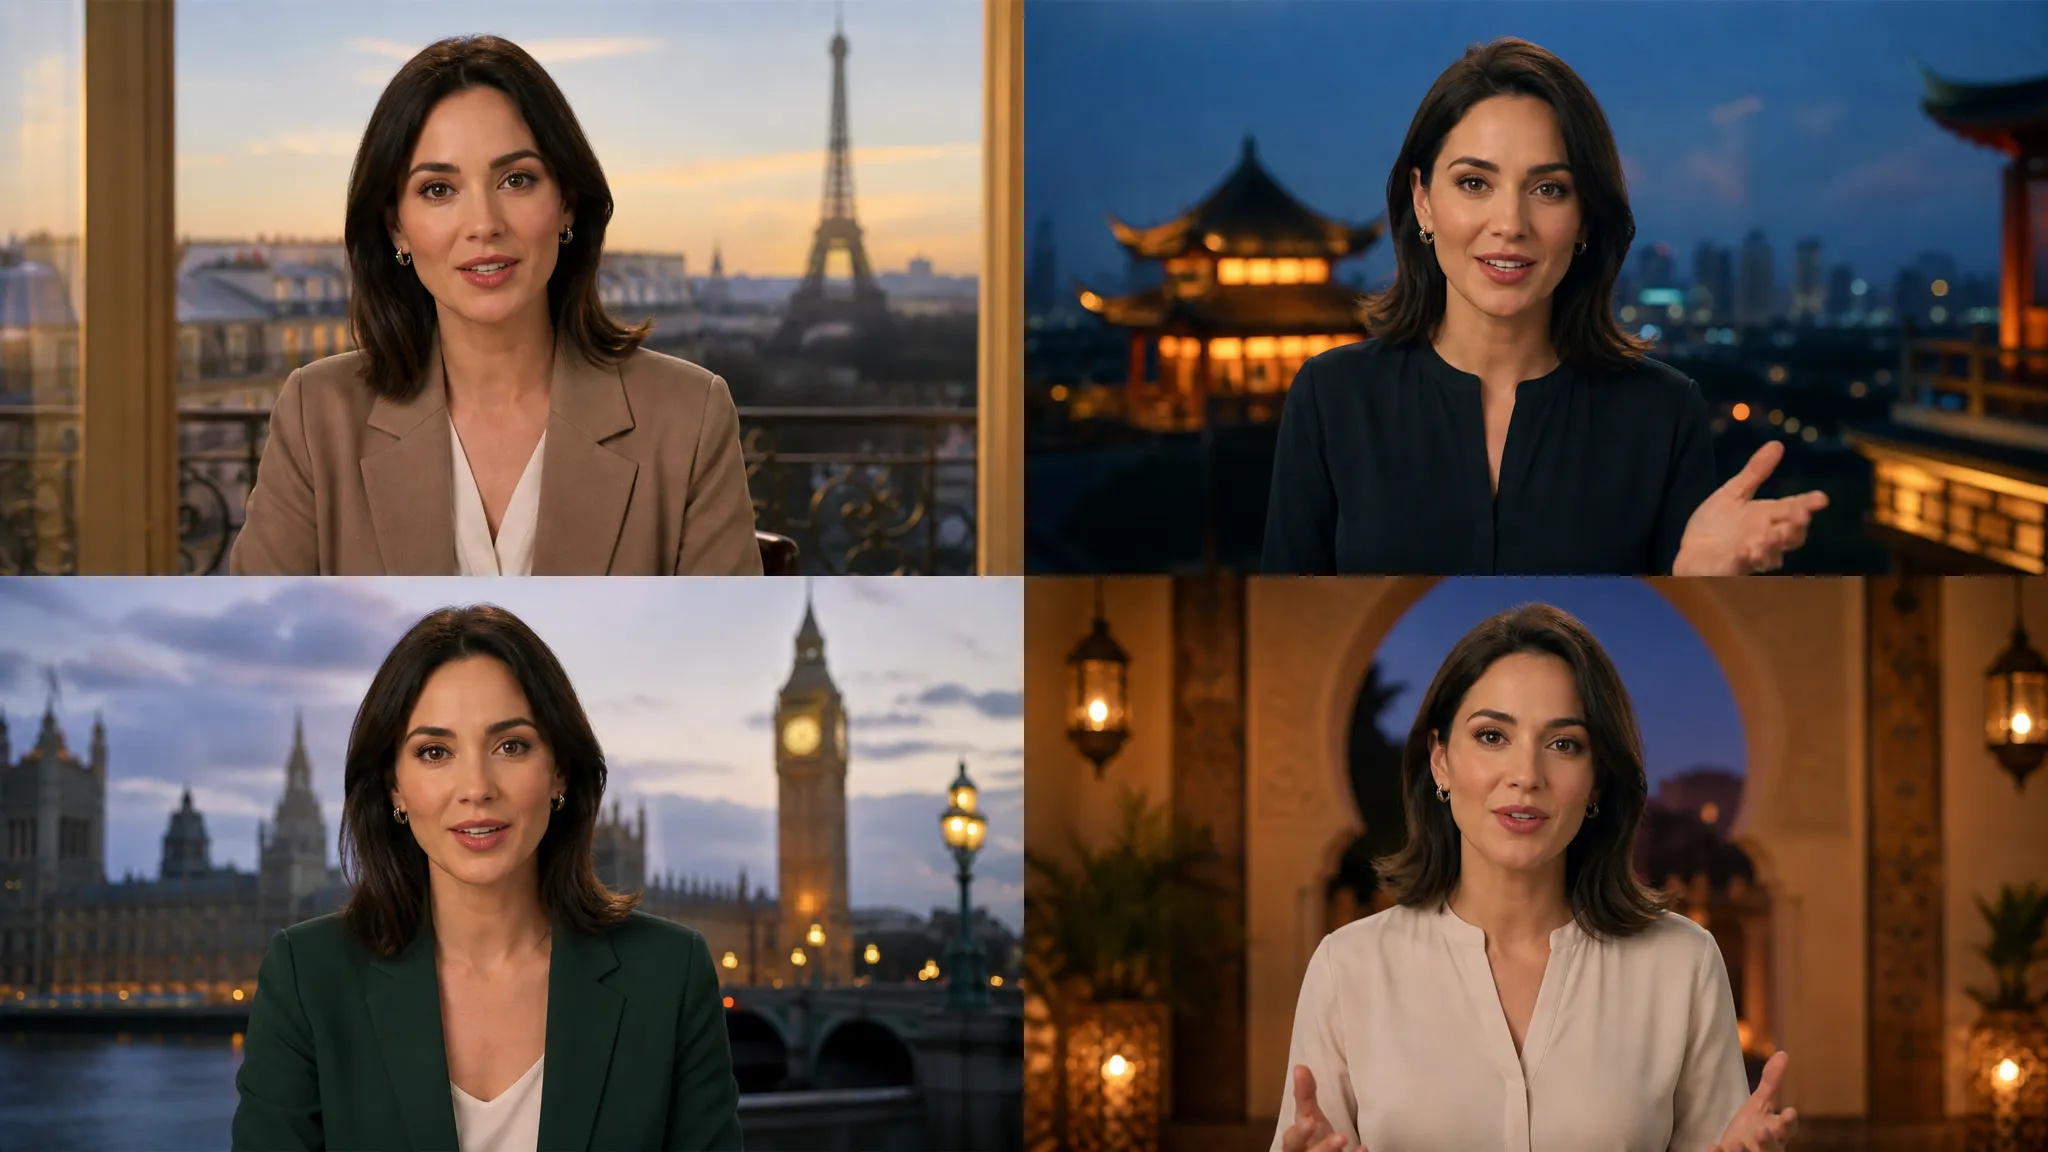
한 사람이 여러 언어를 말합니다. 어느 시장의 버전이든 본인이 실제로 말하는 것처럼 보입니다.
AI 립싱크를 열고 얼굴을 업로드하세요 — 사진도, 영상 클립도 됩니다.
말하게 할 오디오를 올리세요. 텍스트 음성 변환이나 보이스 클론으로 만든 것도 됩니다.
결과를 다운로드하거나 캔버스로 보내 편집을 이어가세요.
영상 생성기에 "이 사람이 말하고 있다"고 쓰면 대개 입만 움직이는 영상이 나오고, 그 움직임은 당신의 대사와 아무 관계가 없습니다. 모델은 말하는 행위가 일어나야 한다는 것만 알 뿐, 무슨 말인지는 모르기 때문입니다.
립싱크는 다른 길을 갑니다. 실제 오디오를 붙들고 음절 단위로 입 모양을 정렬하죠. 그래서 인물은 일반적인 입 움직임을 연기하는 대신, 당신이 준 대사를 말합니다.
이 단계는 보통 사슬의 마지막 고리입니다 — 대본을 쓰고, 목소리를 만들고, 그 말을 인물이 하게 하는 순서죠.
필요한 것은 아주 적습니다. 얼굴과 오디오 트랙뿐이죠. 하지만 얼굴의 품질이 결과를 곧바로 좌우합니다.
오디오 쪽은 세 가지 경로가 모두 통합니다. 텍스트 음성 변환(가장 빠름 — 쓰고 목소리 고르기), 보이스 클론(특정한 목소리가 필요할 때), 직접 녹음한 파일.
조립 단계라고 생각하세요. 먼저 오디오를 제대로 만들고(체감 품질을 결정하는 건 이쪽입니다 — 어색한 낭독은 완벽한 입 정렬로도 구제되지 않습니다), 얼굴을 준비한 다음, 합칩니다.
순서에 관해 한 가지는 몸에 새겨 둘 만합니다. 립싱크를 돌리기 전에 오디오를 확정하세요. 반대로 하면 대본이 바뀔 때마다 영상을 다시 합성해야 하고, 이는 보이스 트랙을 다시 만드는 것보다 훨씬 비쌉니다.
두 가지입니다. 정면을 향한 선명한 얼굴(사진 또는 영상)과 오디오 트랙. 얼굴은 정면이고 이목구비가 보이며 입이 가려지지 않아야 합니다. 측면 각도, 마스크, 아주 어두운 조명은 모두 정렬 정확도를 눈에 띄게 떨어뜨립니다.
텍스트 음성 변환으로 만드는 게 가장 빠릅니다. 대본을 쓰고 목소리를 고르면 끝이죠. 특정한 목소리가 필요하면 보이스 클론으로 먼저 만드세요. 직접 녹음한 오디오를 올려도 됩니다. 세 가지 모두 여기서 동작합니다.
그러면 입은 움직이지만 그 움직임이 당신의 대사와 아무 상관이 없습니다. 립싱크는 실제 오디오에 음절 단위로 맞추기 때문에 입이 진짜 단어와 일치합니다. 인물이 특정한 내용을 말해야 한다면 이 페이지입니다.
됩니다. 다만 모델과 언어에 따라 정밀도에 편차가 있습니다. 영어와 중국어는 대체로 잘 맞습니다. 한 결과가 아쉽다면 같은 소재를 다른 모델로 다시 돌려보세요. 그것으로 해결되는 경우가 많습니다.
Prompt*
이미지*
Audio*