Vidu Q4 实测:4 个参考主体同框、声音参考、对比 Q3,Vidu AI 新模型到底稳不稳
Vidu Q4 是 Vidu AI 在 2026 年 10 月放出的新模型,目前还是预览版。官方主打两件事:一个镜头里塞进很多个参考主体,还能用一段音频把角色的声音定下来。
宣传说得好听,实际能不能用?我们把 Vidu Q4 接进 ZOOOP 之后,准备了一组固定素材,按四个问题测了一遍。
先说结论
- 多主体参考是真的能用。 我们给了两个人、一辆摩托、一条街,四样东西最后都出现在同一个镜头里,人没认错,车没变色。
- 声音参考有效。 生成视频里的说话声和参考音频的音高几乎一样。
- 跟 Vidu Q3 Pro 比,简单的首帧镜头几乎看不出差别,但 Vidu Q4 便宜不少。
- 2K 比 540p 清楚得多,但高分辨率重出的是新的一条,不是放大。
- 不能纯文生,也没有尾帧。 至少要给一张图。
Vidu Q4 是什么
Vidu Q4 是 Vidu AI 目前最新的视频模型,有两种用法。一种是首帧模式:给一张图,让画面动起来,输出比例跟着图片走。另一种是参考模式:最多 12 张参考图,加最多 3 段 3 到 12 秒的 MP3 声音片段,模型把这些主体和声音放进同一个场景。
两种模式都是 3 到 16 秒,分辨率从 540p 到 4K 共五档,自带原生音频,也可以关掉声音只要画面。在 ZOOOP 上,首帧模式在 首尾帧生成视频 里,参考模式在 AI 视频生成 里,选 Vidu Q4 就行。
测试一:4 个参考主体放进同一个镜头
我们先用 AI 图像生成 做了四张参考图:穿红大衣的女生、戴眼镜的胡子男、一辆薄荷绿复古小摩托、一条欧洲老城的石板街。
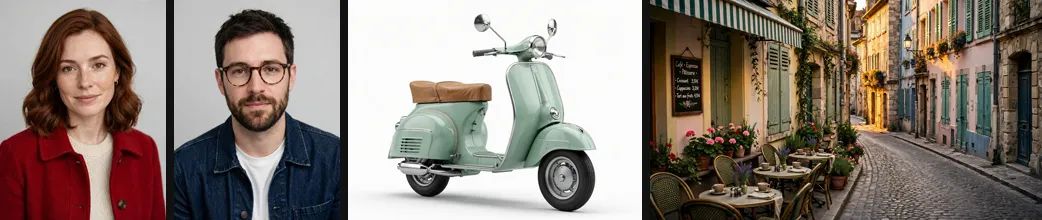
提示词写的是:女生坐在后座,男生骑着这辆摩托,在黄昏的石板街上开过来,女生朝镜头挥手。720p,5 秒。
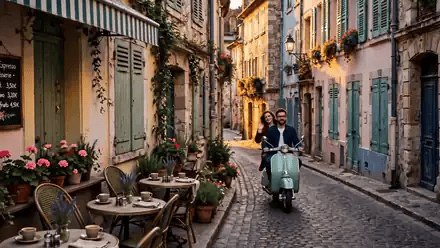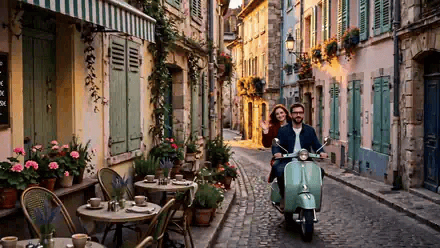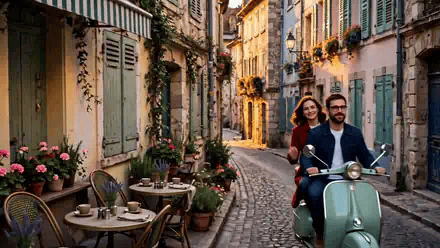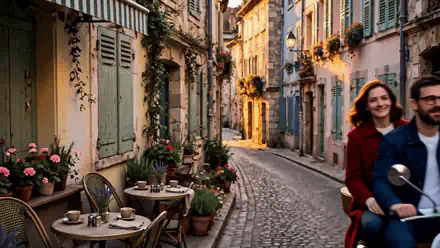
最后一秒停住看,四个参考全对上了:红大衣和红棕色头发是她,眼镜和胡子是他,车是那辆薄荷绿,街就是参考图里那条,连左边的咖啡座都在。
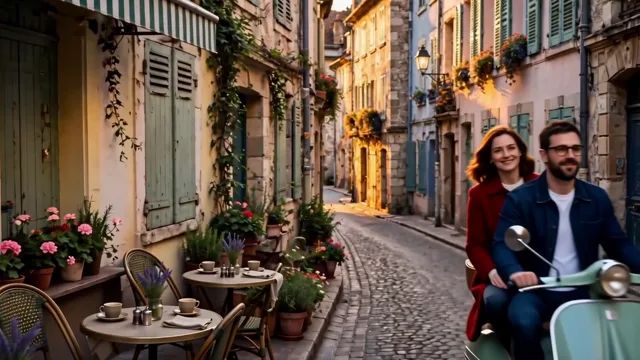
要说缺点,就是镜头前半段人物离得很远,细节看不清。想让脸一直清楚,提示词里可以明确写"中景""人物占画面一半"。
测试二:声音参考,让角色用指定的声音说话
这是 Vidu Q4 最独特的地方,也是 Vidu AI 这一代最主要的新能力。我们先用 AI 配音 生成了一段 5.7 秒的女声自我介绍,再把它和红大衣女生的照片一起交给 Vidu Q4,让她站在街上对着镜头把这句话说出来。540p,竖屏 9:16,6 秒。
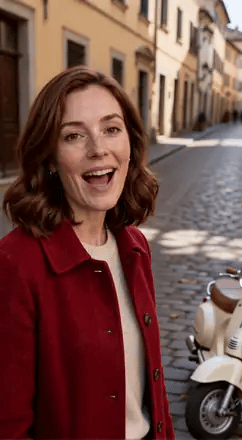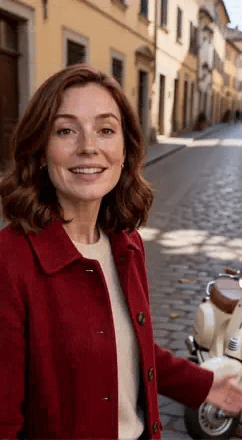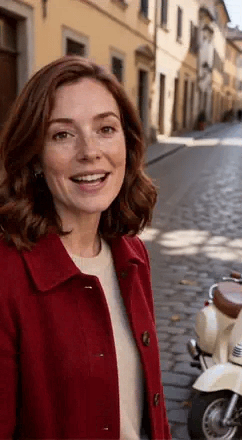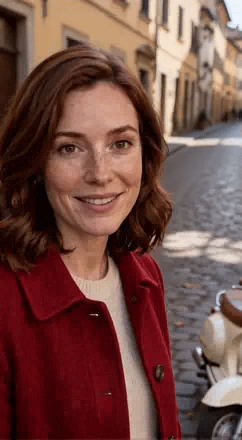
口型和说话节奏是对得上的。声音像不像,我们没有只凭耳朵判断,而是粗测了一下音高:参考音频的中位音高约 219 Hz,生成视频里的说话声约 225 Hz,差不到 3%,分布区间也几乎重合。也就是说,Vidu Q4 确实在跟着参考声音走。
做系列内容的人会喜欢这一点:同一个角色在不同的片子里,声音可以保持一致。
测试三:同一张首帧,Vidu Q4 对比 Vidu Q3 Pro
很多人想知道 Vidu Q4 比 Vidu Q3 强在哪。我们用同一张窗边喝咖啡的照片、同一句提示词(她端起杯子喝一口,笑着转向镜头),720p,5 秒,各跑一条。
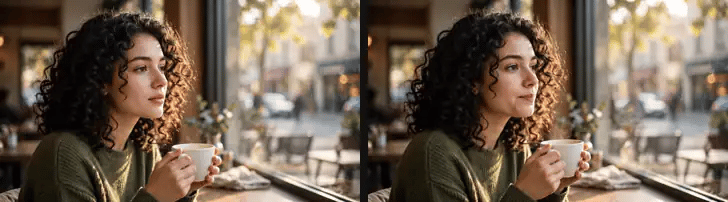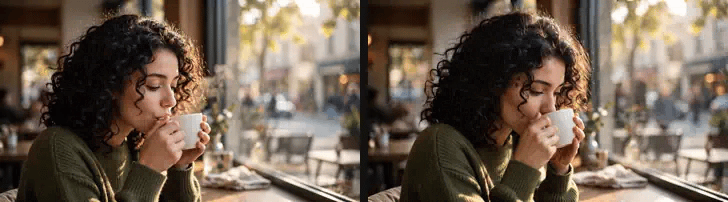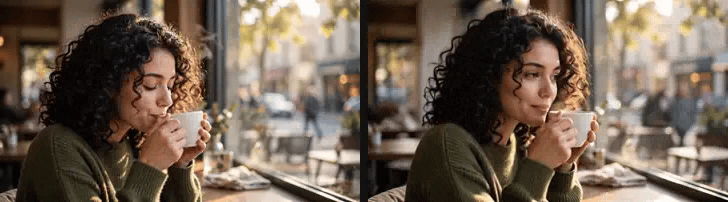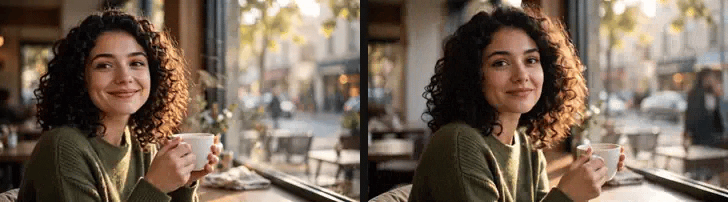
说实话,差别非常小。两条的动作几乎一模一样:喝一口,放下一点,转头微笑。光线、头发、杯子的细节也都在同一个水平。
所以如果你只是让一张图动起来,Vidu Q3 Pro 和 Vidu Q4 都能交差,而 Vidu Q4 在我们这里明显更便宜。Vidu Q4 真正拉开差距的地方,是测试一和测试二那种多主体、带声音的参考生视频,那是 Vidu Q3 系列给不了的。
测试四:540p 和 2K 差多少
同一张摩托图,同一句"慢慢推近,阳光在镜子上闪",分别用 540p 和 2K 跑了 3 秒。截取同一位置放大:
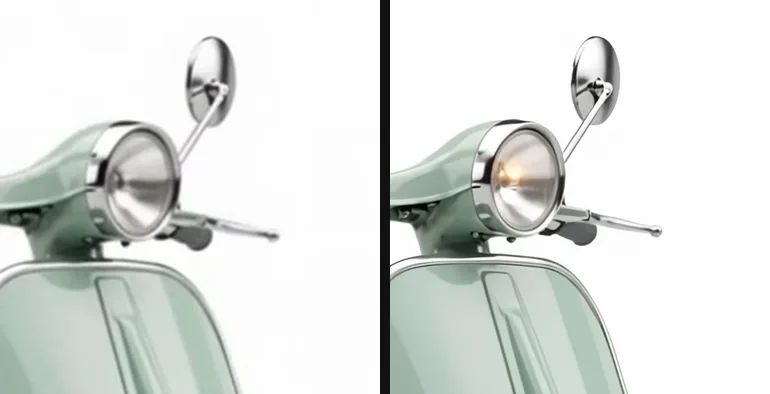
540p 的镜面边缘和刹车把手都是糊的,2K 里镜框的高光、把手的金属质感都很清楚。另外,首帧模式输出的比例跟着图片走,这张 4:3 的产品图,出来的视频也是 4:3。
有一点要注意:右边那条的车灯是亮的,左边没有。换分辨率重出,得到的是另一条新的视频,不是把 540p 那条放大。所以 540p 适合拿来试提示词,不适合挑中一条再"升级"。
翻车和限制
- 不能纯文生。 首帧模式要一张图,参考模式至少要一张参考图。只想用文字生成,得换别的模型。
- 没有尾帧。 要做"从 A 变成 B"的过渡,Vidu Q4 做不了。
- 参考生视频比较慢。 我们这几单首帧模式一两分钟出片,参考模式等了好几分钟。
- 还是预览版。 表现可能随版本变化,重要项目建议先小批量试。
- 声音参考只收 MP3,每段 3 到 12 秒。
怎么用 Vidu Q4 最划算
用 Vidu AI 的新模型出片,我们实测下来的顺序是:
- 先用 540p、3 到 5 秒试提示词和参考组合,看人物、物体有没有认对;
- 确定方向后,用 1080p、2K 或 4K 正式出片;
- 同一个角色要出多条,就固定用同一段声音参考,保持声音一致;
- 最后把几段放到 生成式画布 里排成完整作品。
只是让一张照片动起来、又不需要多主体或声音,Vidu Q3 Pro 和 Vidu Q4 效果接近,用哪个都行。
总结
Vidu Q4 并非处处都比上一代强,简单的首帧镜头和 Vidu Q3 Pro 几乎打平。它的价值在于:一个镜头里放进多个固定的人和物,再用一段音频把声音定下来。这两件事以前要么做不到,要么要靠后期补。对做品牌角色、系列短片、多人同框广告的人来说,Vidu AI 这次的新模型值得一试。
参数和更多示例在 Vidu Q4 模型页。