Vidu Q4 實測:4 個參考主體同框、聲音參考、對比 Q3,Vidu AI 新模型到底穩不穩
Vidu Q4 是 Vidu AI 在 2026 年 10 月推出的新模型,目前還是預覽版。官方主打兩件事:一個鏡頭裡塞進很多個參考主體,還能用一段音訊把角色的聲音定下來。
宣傳說得好聽,實際能不能用?我們把 Vidu Q4 接進 ZOOOP 之後,準備了一組固定素材,按四個問題測了一遍。
先說結論
- 多主體參考是真的能用。 我們給了兩個人、一輛機車、一條街,四樣東西最後都出現在同一個鏡頭裡,人沒認錯,車沒變色。
- 聲音參考有效。 生成影片裡的說話聲和參考音訊的音高幾乎一樣。
- 跟 Vidu Q3 Pro 比,簡單的首幀鏡頭幾乎看不出差別,但 Vidu Q4 便宜不少。
- 2K 比 540p 清楚得多,但高解析度重出的是新的一支,不是放大。
- 不能純文生,也沒有尾幀。 至少要給一張圖。
Vidu Q4 是什麼
Vidu Q4 是 Vidu AI 目前最新的影片模型,有兩種用法。一種是首幀模式:給一張圖,讓畫面動起來,輸出比例跟著圖片走。另一種是參考模式:最多 12 張參考圖,加最多 3 段 3 到 12 秒的 MP3 聲音片段,模型把這些主體和聲音放進同一個場景。
兩種模式都是 3 到 16 秒,解析度從 540p 到 4K 共五檔,自帶原生音訊,也可以關掉聲音只要畫面。在 ZOOOP 上,首幀模式在 首尾幀生成影片 裡,參考模式在 AI 影片生成 裡,選 Vidu Q4 就行。
測試一:4 個參考主體放進同一個鏡頭
我們先用 AI 圖像生成 做了四張參考圖:穿紅大衣的女生、戴眼鏡的鬍子男、一輛薄荷綠復古小機車、一條歐洲老城的石板街。
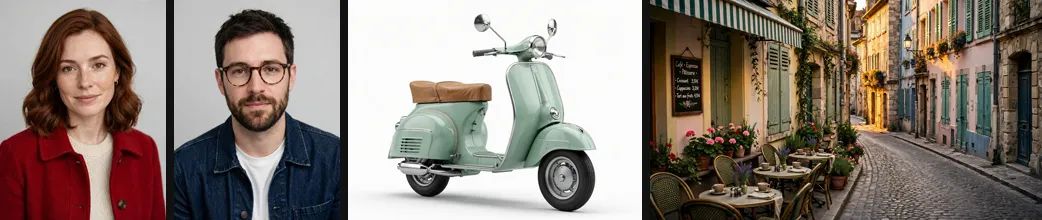
提示詞寫的是:女生坐在後座,男生騎著這輛機車,在黃昏的石板街上騎過來,女生朝鏡頭揮手。720p,5 秒。
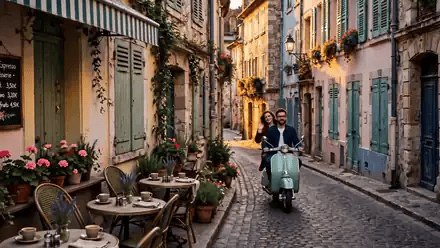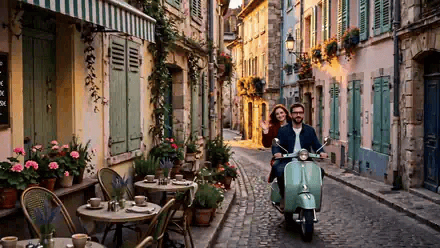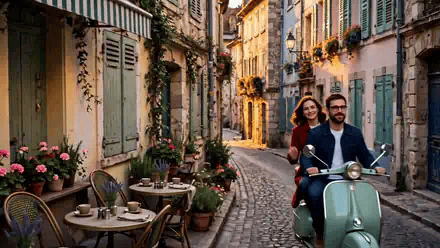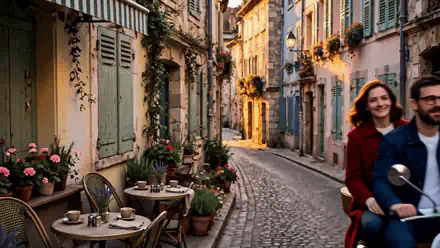
最後一秒停住看,四個參考全對上了:紅大衣和紅棕色頭髮是她,眼鏡和鬍子是他,車是那輛薄荷綠,街就是參考圖裡那條,連左邊的咖啡座都在。
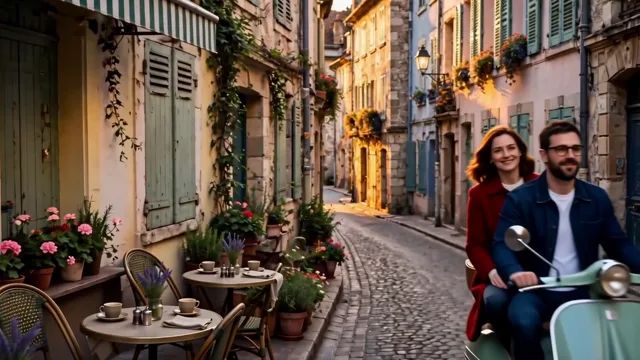
要說缺點,就是鏡頭前半段人物離得很遠,細節看不清。想讓臉一直清楚,提示詞裡可以明確寫「中景」「人物佔畫面一半」。
測試二:聲音參考,讓角色用指定的聲音說話
這是 Vidu Q4 最獨特的地方,也是 Vidu AI 這一代最主要的新能力。我們先用 AI 配音 生成了一段 5.7 秒的女聲自我介紹,再把它和紅大衣女生的照片一起交給 Vidu Q4,讓她站在街上對著鏡頭把這句話說出來。540p,直式 9:16,6 秒。
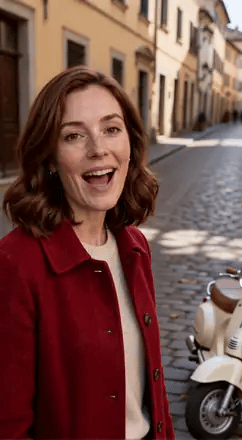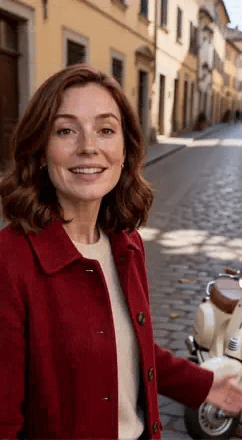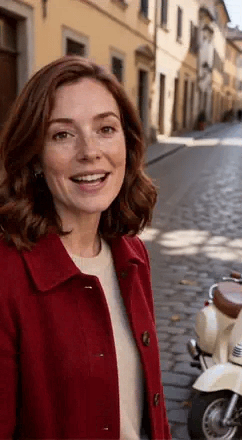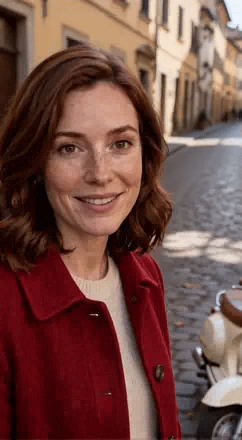
嘴型和說話節奏是對得上的。聲音像不像,我們沒有只憑耳朵判斷,而是粗測了一下音高:參考音訊的中位音高約 219 Hz,生成影片裡的說話聲約 225 Hz,差不到 3%,分布區間也幾乎重合。也就是說,Vidu Q4 確實在跟著參考聲音走。
做系列內容的人會喜歡這一點:同一個角色在不同的片子裡,聲音可以保持一致。
測試三:同一張首幀,Vidu Q4 對比 Vidu Q3 Pro
很多人想知道 Vidu Q4 比 Vidu Q3 強在哪。我們用同一張窗邊喝咖啡的照片、同一句提示詞(她端起杯子喝一口,笑著轉向鏡頭),720p,5 秒,各跑一支。
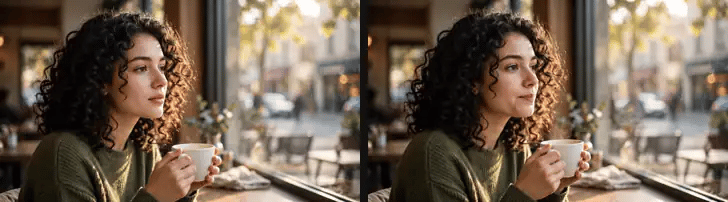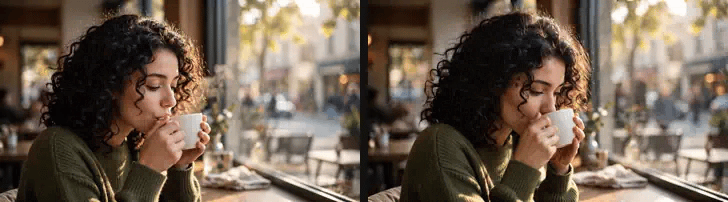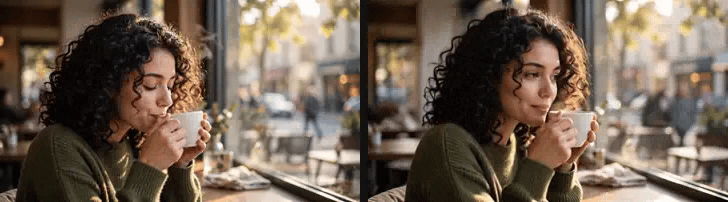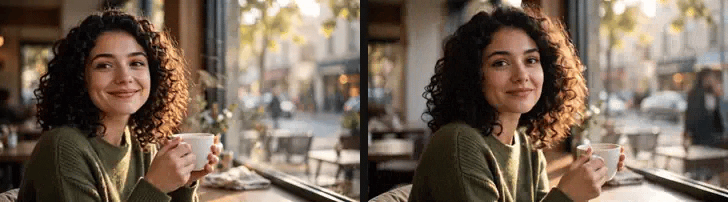
說實話,差別非常小。兩支的動作幾乎一模一樣:喝一口,放下一點,轉頭微笑。光線、頭髮、杯子的細節也都在同一個水準。
所以如果你只是讓一張圖動起來,Vidu Q3 Pro 和 Vidu Q4 都能交差,而 Vidu Q4 在我們這裡明顯更便宜。Vidu Q4 真正拉開差距的地方,是測試一和測試二那種多主體、帶聲音的參考生影片,那是 Vidu Q3 系列給不了的。
測試四:540p 和 2K 差多少
同一張機車圖,同一句「慢慢推近,陽光在鏡子上閃」,分別用 540p 和 2K 跑了 3 秒。擷取同一位置放大:
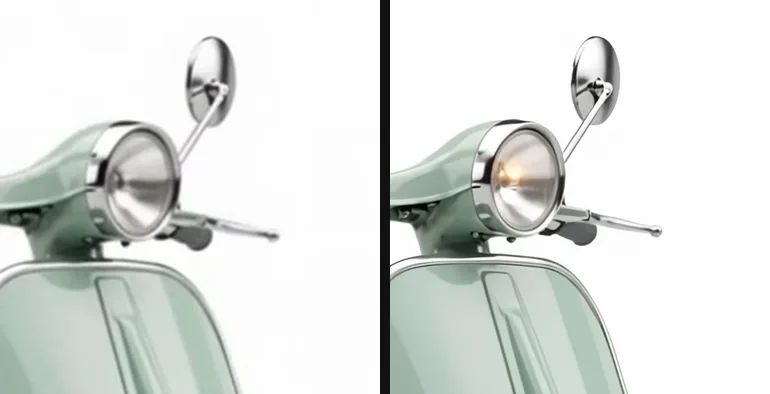
540p 的鏡面邊緣和煞車拉桿都是糊的,2K 裡鏡框的高光、拉桿的金屬質感都很清楚。另外,首幀模式輸出的比例跟著圖片走,這張 4:3 的產品圖,出來的影片也是 4:3。
有一點要注意:右邊那支的車燈是亮的,左邊沒有。換解析度重出,得到的是另一支新的影片,不是把 540p 那支放大。所以 540p 適合拿來試提示詞,不適合挑中一支再「升級」。
出包和限制
- 不能純文生。 首幀模式要一張圖,參考模式至少要一張參考圖。只想用文字生成,得換別的模型。
- 沒有尾幀。 要做「從 A 變成 B」的過渡,Vidu Q4 做不了。
- 參考生影片比較慢。 我們這幾支首幀模式一兩分鐘就出片,參考模式等了好幾分鐘。
- 還是預覽版。 表現可能隨版本變化,重要專案建議先小量試。
- 聲音參考只收 MP3,每段 3 到 12 秒。
怎麼用 Vidu Q4 最划算
用 Vidu AI 的新模型出片,我們實測下來的順序是:
- 先用 540p、3 到 5 秒試提示詞和參考組合,看人物、物體有沒有認對;
- 確定方向後,用 1080p、2K 或 4K 正式出片;
- 同一個角色要出多支,就固定用同一段聲音參考,保持聲音一致;
- 最後把幾段放到 生成式畫布 裡排成完整作品。
只是讓一張照片動起來、又不需要多主體或聲音,Vidu Q3 Pro 和 Vidu Q4 效果接近,用哪個都行。
總結
Vidu Q4 並非處處都比上一代強,簡單的首幀鏡頭和 Vidu Q3 Pro 幾乎打平。它的價值在於:一個鏡頭裡放進多個固定的人和物,再用一段音訊把聲音定下來。這兩件事以前不是做不到,就是要靠後製補。對做品牌角色、系列短片、多人同框廣告的人來說,Vidu AI 這次的新模型值得一試。
參數和更多範例在 Vidu Q4 模型頁。