AI で YouTube サムネイルを 8 枚作った:サイズ、構図、そしてボツにした 4 枚
動画がクリックされるかどうかは、多くの人が思っている以上にサムネイルで決まります。ある日の午後をまるごと使って、AI 画像生成で YouTube サムネイルを 8 枚一式作りました。途中で 4 枚をボツにし、これまで信じていた通説がひっくり返り、さらにもっと根本的な失敗もしました。その失敗は独立した節を割く価値があります。
手を動かす前に仕様を測る
YouTube サムネイルの推奨サイズは 1280×720、つまり 16:9 です。この数字を知っている人は多いのですが、仕上がりを左右するのは別の 2 点です。
ひとつは、右下が動画の再生時間バッジで隠れること。1280×720 に換算すると 132×36 ほどで、そこに置いたものは半分持っていかれます。
もうひとつは見落とされがちですが、サムネイルは一覧で原寸表示されません。PC のトップページで幅 360px 前後、スマホのおすすめ欄では 168px 程度しかないことも珍しくありません。同じ YouTube サムネイルをこの 3 段階に縮めて並べてみると差は一目瞭然でした。360px なら小道具も表情も読めますが、168px で残るのは色の塊と人影だけです。
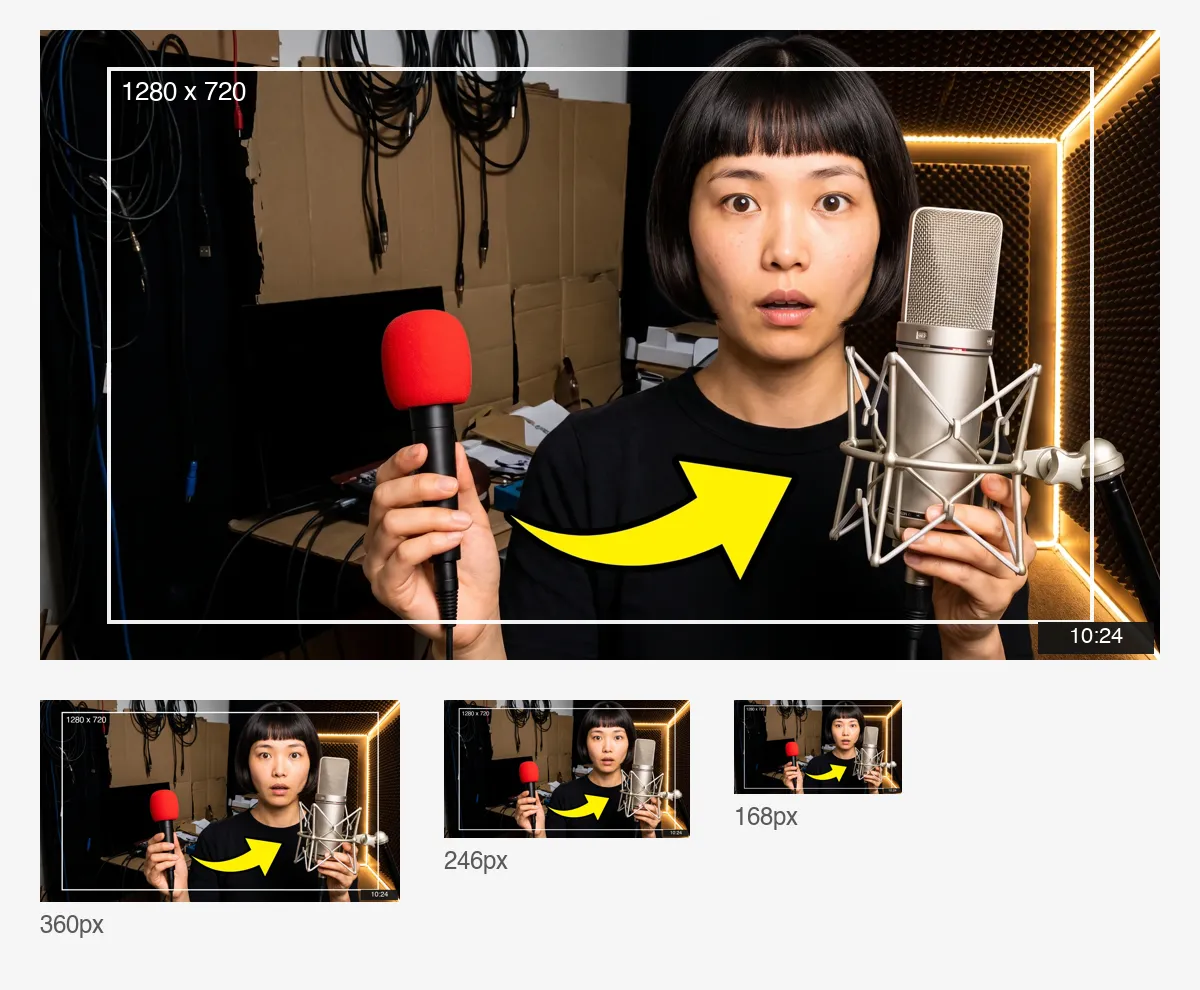
そこで先に 2 つのルールを決めました。被写体と重要な情報は上下左右に 6% の余白を取った中央セーフエリアに収める。右下は空けておく。そのうえで、あとから見出しを載せるためのきれいな領域を画面内に確保します。
まず「オーディション写真」を撮る。それが一式の土台になる
8 枚の YouTube サムネイルに写る人物が同一人物でなければならない、これが全体でいちばん難しい部分です。
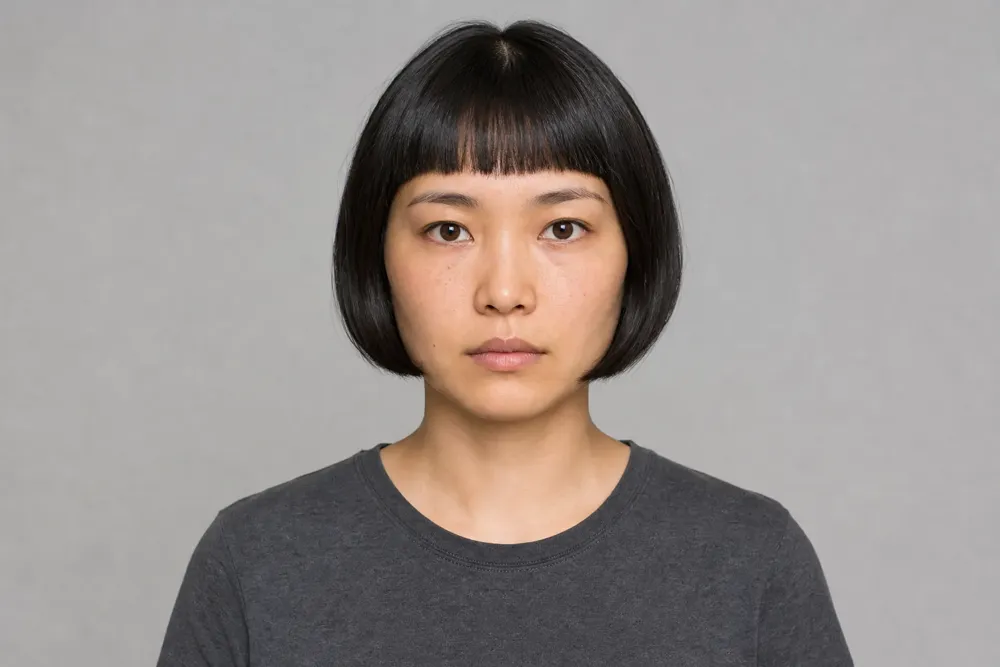
そこでまず AI 画像生成 できれいな基準画像を 1 枚だけ作りました。正面、目線の高さ、すっぴん、無表情、グレー背景、均一なライティング。オーディション写真のような一枚です。この画像自体はまったく見栄えがしませんし、公開する予定もありません。以降のすべてのカットで参照画像として使うことだけが役目です。
そして、ここからが失敗の話です。
最初の版では構図まで固定してしまいました。人物は画面左 3 分の 1、シルエットに沿って白い縁取り、頭の後ろに放射状の光、右半分はベタ塗り。変えていいのは表情と背景色だけ。8 枚を作り終えてみると顔はまったくブレていませんでしたが、並べると 8 枚のサムネイルではなく感情の一覧表に見えました。顔色と背景色が違うだけです。
理由は単純です。本物のサムネイルは「この回で何を話すか」を軸に設計されるのに、私がモデルに渡した変数は表情ひとつだけでした。設計する余地がないので、私のテンプレートを 8 回繰り返すしかなかったのです。
直し方は、設計の主導権を返すことでした。固定ブロックには本当に固定すべきものだけを残します。同じ人物、顔が明るく遮られていないこと、上半身が入っていること。舞台、小道具、グラフィック要素、配色、ライティング、奥行き、構図はすべてモデルが決めます。変数ブロックは一文だけ ―― この回で何を話すか。
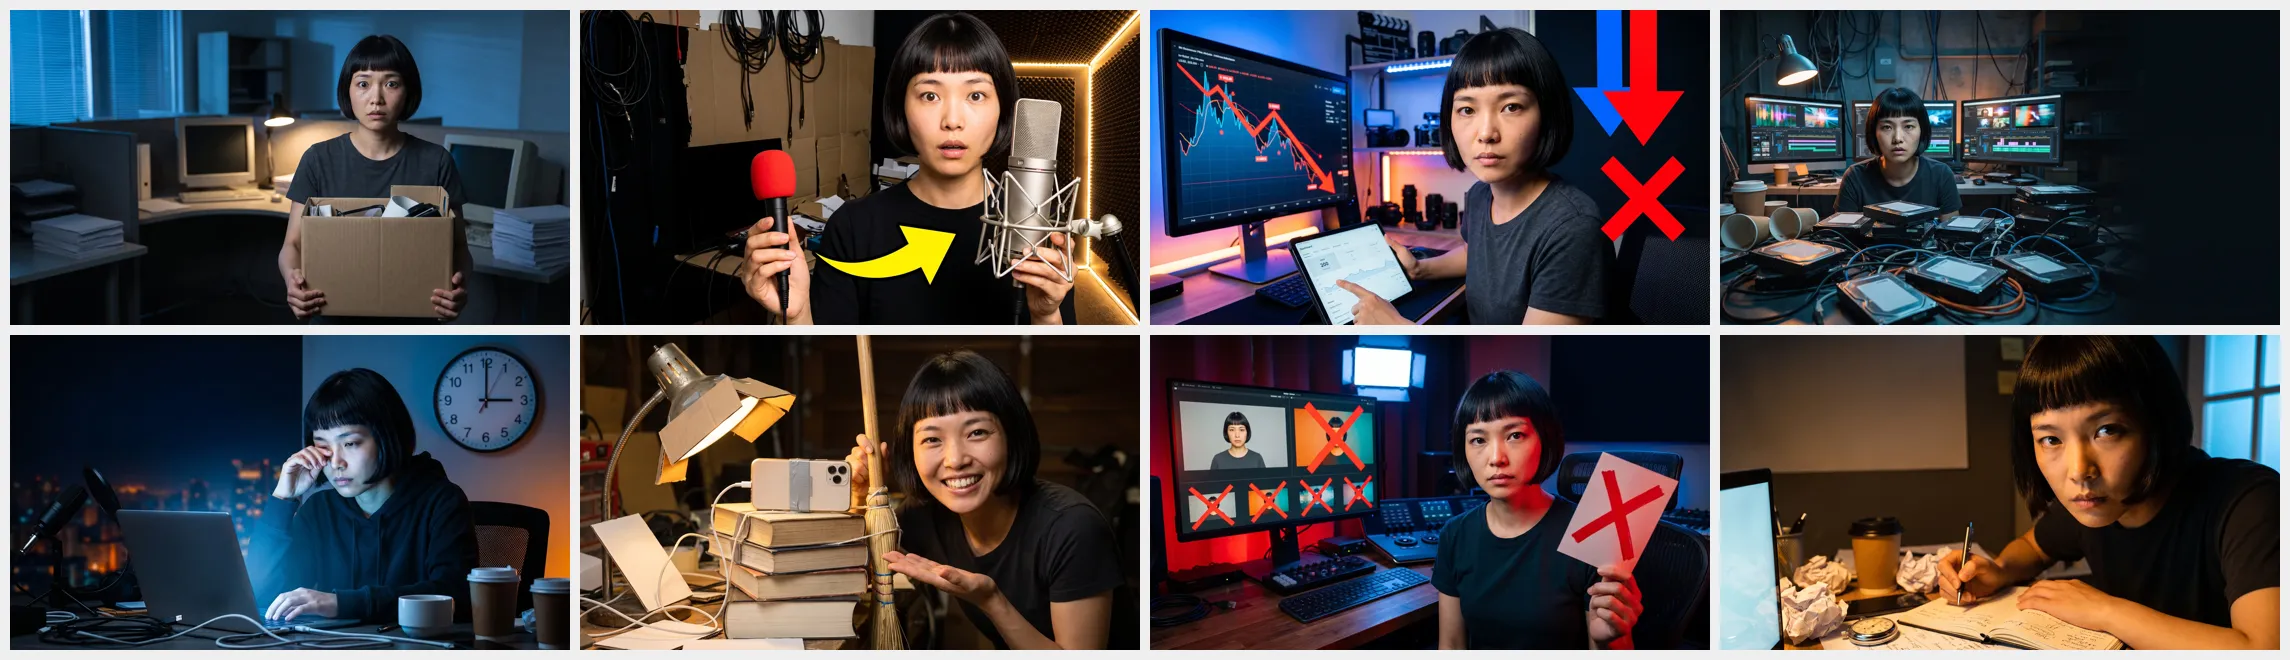
8 つの変数はこうです。会社を辞めて専業になる、3,000 円のマイクが 3 万円のマイクに勝つ、再生数 200 で止まっている、1 週間で 100 本編集する、1 か月間ずっと午前 3 時に投稿する、撮影機材一式がスマホ 1 台より安い、使うのをやめるべきカラープリセット 5 つ、12 分で台本を書く。
返ってきたものは第 1 版とは別次元でした。赤いハンドマイクとコンデンサーマイクのあいだに横たわる黄色い矢印。モニターを転げ落ちる赤い折れ線と、その脇の赤いバツ印。ずらりと並んだプリセットのサムネイルが一つずつ×で消されている図。午前 3 時の街の夜景と壁掛け時計。こうしたグラフィック言語はどれもプロンプトに書いていません。AI 画像モデルが自分で考え出したものです。
文字は書けないと思っていたら、書けた
AI 画像生成についてよく言われることがあります。モデルは読める文字を書けないので、画像の中の「文字」は必ず崩れる、と。私もそれに従って、どのプロンプトにも「画面内に文字を出さないこと」と書き添えていました。
最後に試しに、空けておいた領域へ直接見出しを書かせてみました。
正しく書けました。誤字はゼロ、字形はきれい、ウェイトも適切、3 行の改行位置も自然です。この古い経則は、今日の AI 画像モデルにはもうあまり当てはまりません。
それでも方針は変えませんでした。次の実験で本当の問題が露呈したからです。見出しの 200 を 500 に変え、ほかの語は一つも触らずに再実行しました。文字は相変わらず正しい。しかし画面全体が組み直されていました。彼女は横向きに座った姿から正面中央に変わり、モニターは左端から背後へ移動し、文字のサイズと位置もそれに合わせて変わっていました。2 枚を並べると、同じシリーズには見えません。
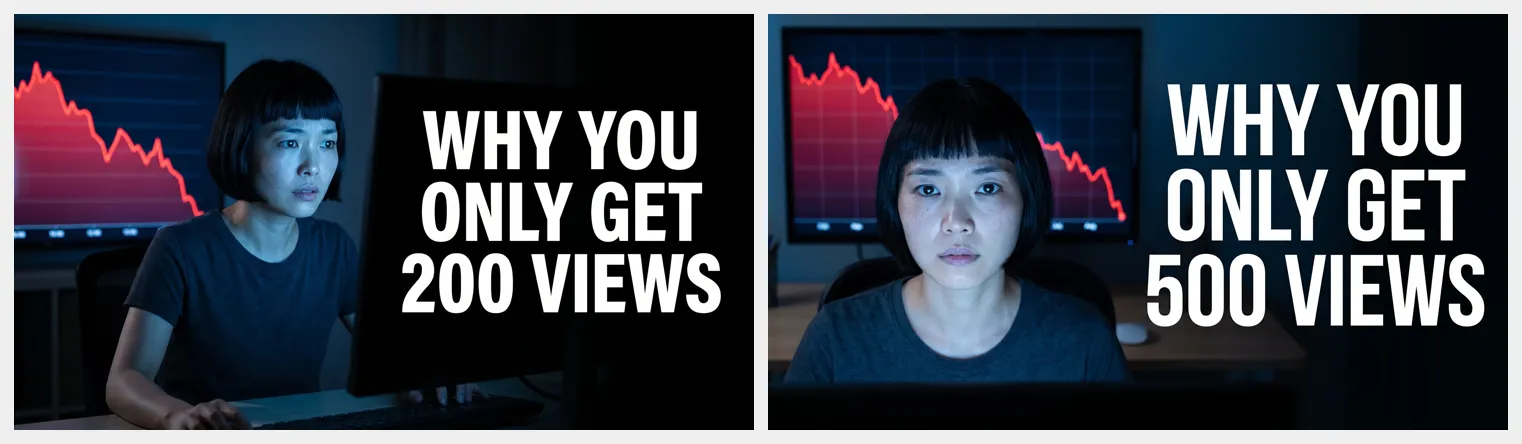
結論は変わりませんが、理由が変わりました。問題は文字が書けないことではなく、レイアウトが再現できないことです。YouTube サムネイルを一式作り、あとで見出しを差し替えたり A/B テストしたりするつもりなら、画像には絵だけを残し、文字は別に重ねましょう。1 枚だけ作ってもう触らないなら、モデルに書かせたほうが工程がひとつ減ります。
ボツにした 4 枚
設計の主導権を AI 画像モデルに渡すと、頼んでいないものを平気で画面に入れてきます。4 枚のやり直し、3 種類の失敗でした。
実在するブランド。「会社を辞める」の回では、側面に実在メーカー名が印刷されたマイクを持たせてきました。「1 週間で 100 本」の回では、机の上に一目でそれと分かるエナジードリンクの缶が 2 本。どちらも公開する画像には入れられません。
被写体の複製。ブランド禁止の条項を足して「辞める」を再実行したら、彼女が 2 人現れました。ひとりはデスクでタイプし、もうひとりは段ボール箱を抱えてその横に立っています。モデルは「オフィスを去る」を、演者が 2 人必要な場面だと解釈したわけです。
小道具に文字が出る。「機材一式がスマホより安い」の回では、段ボール箱に英単語が 2 つきれいに書かれていました。これがいちばん厄介です。画像は 21 言語で 1 枚を共有するので、どれか 1 言語の文字が入れば、残り 20 言語の読者にはノイズにしかなりません。
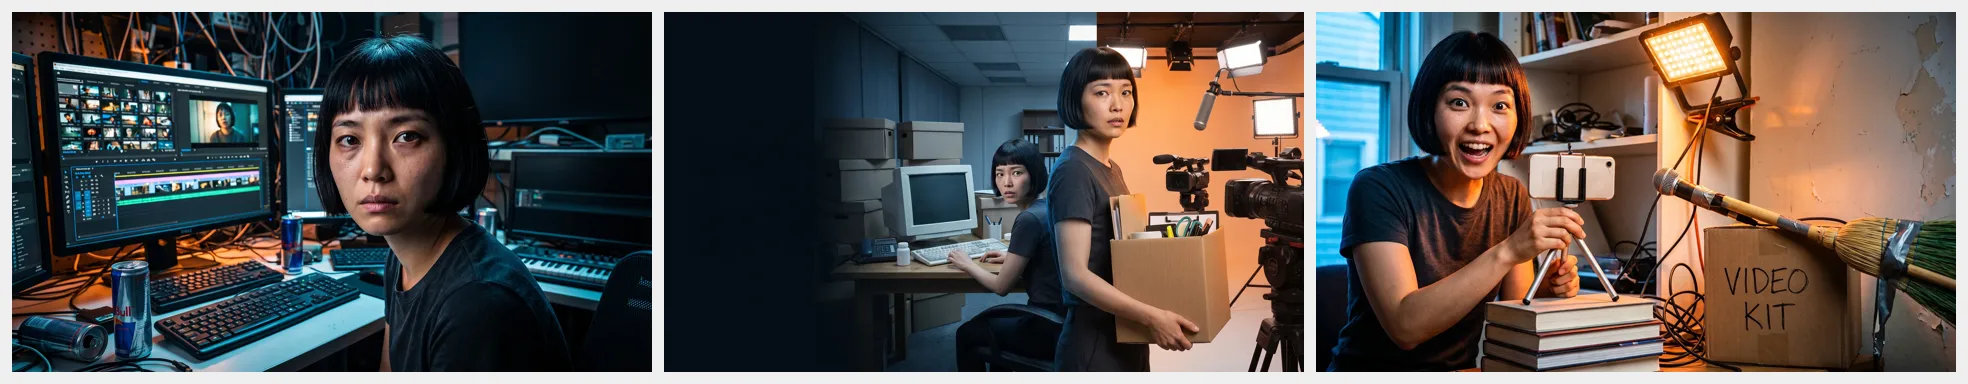
この 3 つはのちにすべて固定ブロックへ入りましたが、書き方は具体的でなければ効きません。「文字を出さない」では足りず、「画面、パッケージ、ラベル、機材、看板のいずれにも文字を出さない」と書く必要があります。「人物は 1 人」も足りません。「彼女の 2 人目、鏡像、背景に飾られた肖像も禁止」まで塞いでおきます。
そのまま使えるプロンプト構造
固定ブロックは毎回そのままコピーします。おおよそこういう内容です。
参照画像と同じ人物、同じ髪型を使うこと。誰が見ても同一人物と分かること、顔は明るく、遮られず、おおむねカメラを向いていること、上半身が入っていること。あなたはアートディレクターであり、幅 168 ピクセルでもクリックを奪える YouTube サムネイルを設計する。彼女の見た目以外 ―― 舞台、小道具、グラフィック要素、配色、ライティング、奥行き、構図はすべてあなたが決めてよい。大胆に、コントラストを強く、この回のテーマに寄せること。単色背景の平凡なポートレートにはしないこと。あとから見出しを載せるためのきれいな領域を画面内に空けること。文字、アルファベット、数字は一切禁止。画面、パッケージ、ラベル、機材、看板のいずれにも書かないこと。ブランドロゴや識別可能な商標も禁止で、小道具はすべて無印であること。画面に写る人物はちょうど 1 人。
変数ブロックは一文だけ ―― この回で何を話すか。
最後の 3 つの禁止事項は、いずれもやり直しのあとに足したものです。失敗 1 回につき 1 条項。この「固定ブロック+変数ブロック」の構造は、ほかの AI 画像モデルでもそのまま通用します。変わるのは言い回しの癖くらいです。
同じサムネイルをもう一度使う
8 枚が固まったあと、AI 画像で作った静止画にはもう一仕事ありました。午前 3 時の 1 枚を開始フレームにして、開始・終了フレームから動画生成 で 5 秒のオープニングを作りました。
ここにも実際の落とし穴があります。生成されたクリップは構図を組み直してしまい、見出し用に確保しておいたきれいな領域はほとんど食われました。オープニングなら問題ありませんが、エンドカードに使うなら組み直しが必要です。
一式をまとめて回すなら、ジェネレーティブキャンバス に 8 件の AI 画像ジョブを並べたほうが 1 枚ずつやるより快適です。どれを残しどれを作り直すか一目で分かります。プロンプトを一から書きたくなければ、テンプレート にそのまま使えるポートレートの作風があります。
午後いっぱいで 8 枚
YouTube サムネイル一式は、最初の実行から 8 枚確定まで午後いっぱいかかり、4 枚を捨てました。時間を食ったのは生成でもレタッチでもなく、何をモデルに委ねるかを見極める作業でした。最初は握りすぎて構図まで釘付けにし、結果として似たような画像を 8 枚受け取ったわけです。
再現するなら順序はこうです。セーフエリアと実際の 3 段階の表示サイズを測る。見栄えはしないがきれいな基準画像を 1 枚作る。固定ブロックは人物とわずかな禁止事項だけに絞る。各カットのテーマを唯一の変数として扱う。文字については、一式なら後から載せる、単発ならモデルに書かせる。