J'ai créé 8 miniatures YouTube avec l'IA : formats, cadrage et les quatre que j'ai jetées
Qu'une vidéo soit cliquée ou non dépend de sa miniature bien plus qu'on ne le croit. J'ai passé un après-midi à produire un jeu complet de 8 miniatures YouTube avec la génération d'images IA. Quatre ont fini à la poubelle en cours de route, un résultat a contredit un conseil que je tenais pour acquis, et j'ai commis une erreur plus fondamentale qui mérite sa propre section.
Mesurer les contraintes avant de générer quoi que ce soit
La taille recommandée d'une miniature YouTube est 1280×720, soit du 16:9. Beaucoup de gens connaissent ce chiffre. Deux autres points comptent davantage pour le rendu final.
D'abord, le coin inférieur droit est recouvert par le badge de durée de la vidéo. Ramené à 1280×720, il occupe environ 132×36, et tout ce qu'on y place perd la moitié de sa surface.
Ensuite, et c'est plus facile à oublier : une miniature n'est jamais affichée en taille réelle dans un flux. La page d'accueil sur ordinateur la montre autour de 360px de large, et le fil de recommandations mobile se contente souvent de 168px. J'ai réduit la même miniature YouTube à ces trois tailles et je les ai placées côte à côte. À 360px, les accessoires et l'expression se lisent encore. À 168px, il ne reste qu'une tache de couleur et une silhouette.
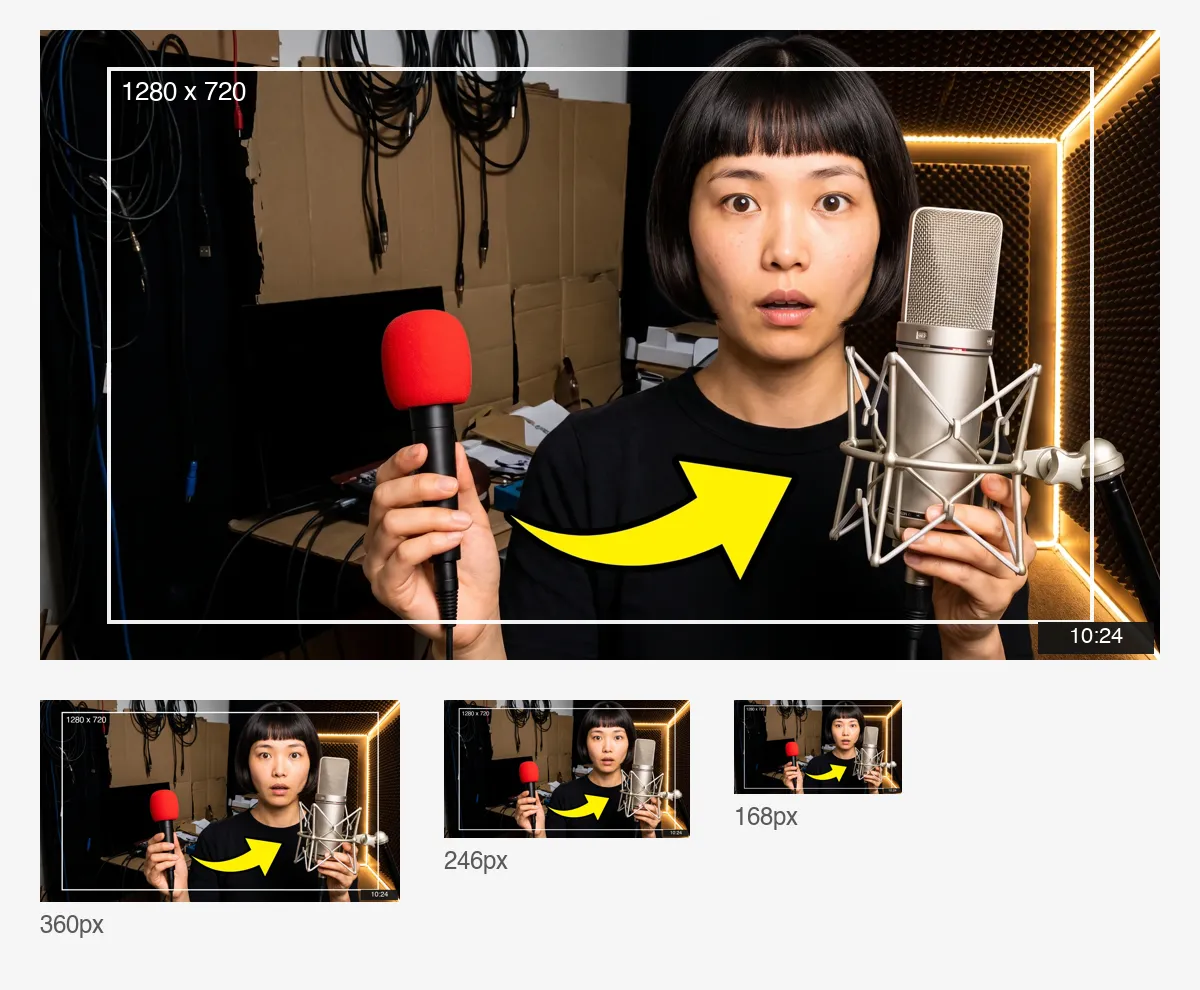
J'ai donc posé deux règles avant de générer. Garder le sujet et tout ce qui compte dans une zone de sécurité centrale avec 6% de marge sur les quatre côtés, et laisser le coin inférieur droit vide. Puis réserver dans l'image une zone propre où poser un titre plus tard.
Commencer par une photo de casting : c'est la fondation du jeu
Le plus difficile dans tout ce travail, c'est que la personne présente sur les huit miniatures doit être la même.
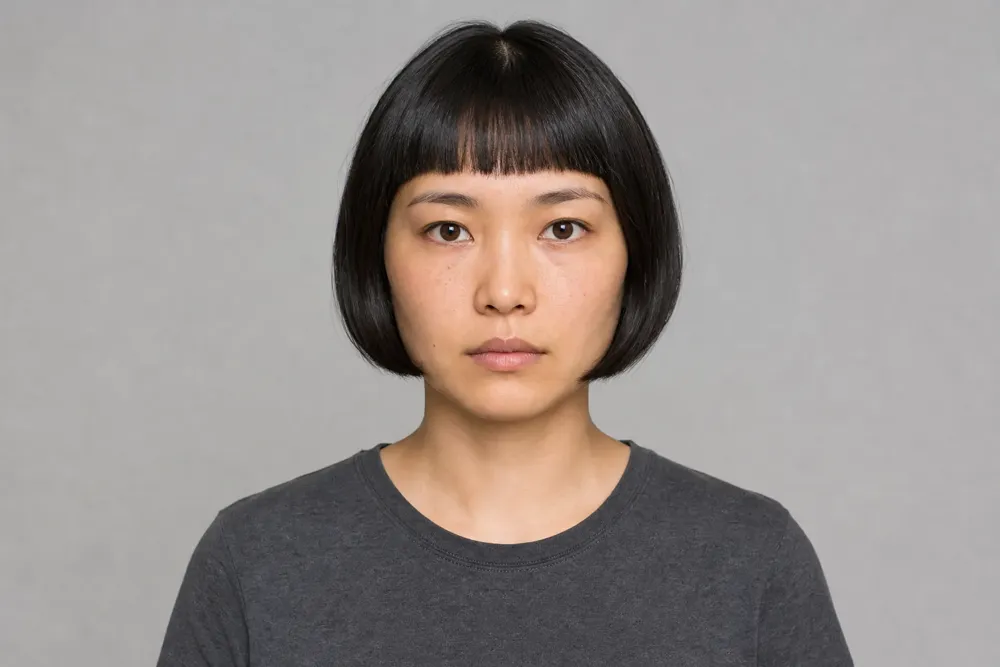
Ma méthode : produire d'abord une image de référence propre avec la génération d'images IA. De face, à hauteur d'yeux, sans maquillage, sans expression, fond gris, lumière plate et uniforme, comme une photo de casting. Cette image n'a rien de séduisant et n'a jamais été destinée à la publication. Son unique rôle est de servir de référence à toutes les images suivantes.
Et c'est là que vient l'erreur.
Dans ma première passe, j'avais aussi figé la composition. Sujet dans le tiers gauche, contour blanc découpé autour d'elle, étoile de rayons derrière sa tête, aplat de couleur sur la moitié droite. Seuls son expression et la couleur de fond avaient le droit de changer. Huit images plus tard, son visage n'avait pas dérivé d'un millimètre, et l'ensemble ressemblait à un nuancier d'émotions plutôt qu'à huit miniatures. Autre tête, autre couleur, rien de plus.
La raison est simple. Une vraie miniature se conçoit autour du sujet de la vidéo, or la seule variable que j'avais donnée au modèle était une expression de visage. Il n'avait rien à concevoir, alors il a répété mon gabarit huit fois.
Le correctif a consisté à lui rendre la main. Le bloc fixe ne verrouille plus que ce qui doit l'être : la même personne, son visage éclairé et non masqué, buste dans le cadre. Décor, accessoires, éléments graphiques, palette, lumière, profondeur et cadrage relèvent désormais du modèle. Le bloc variable est devenu une seule phrase — de quoi parle cette vidéo.
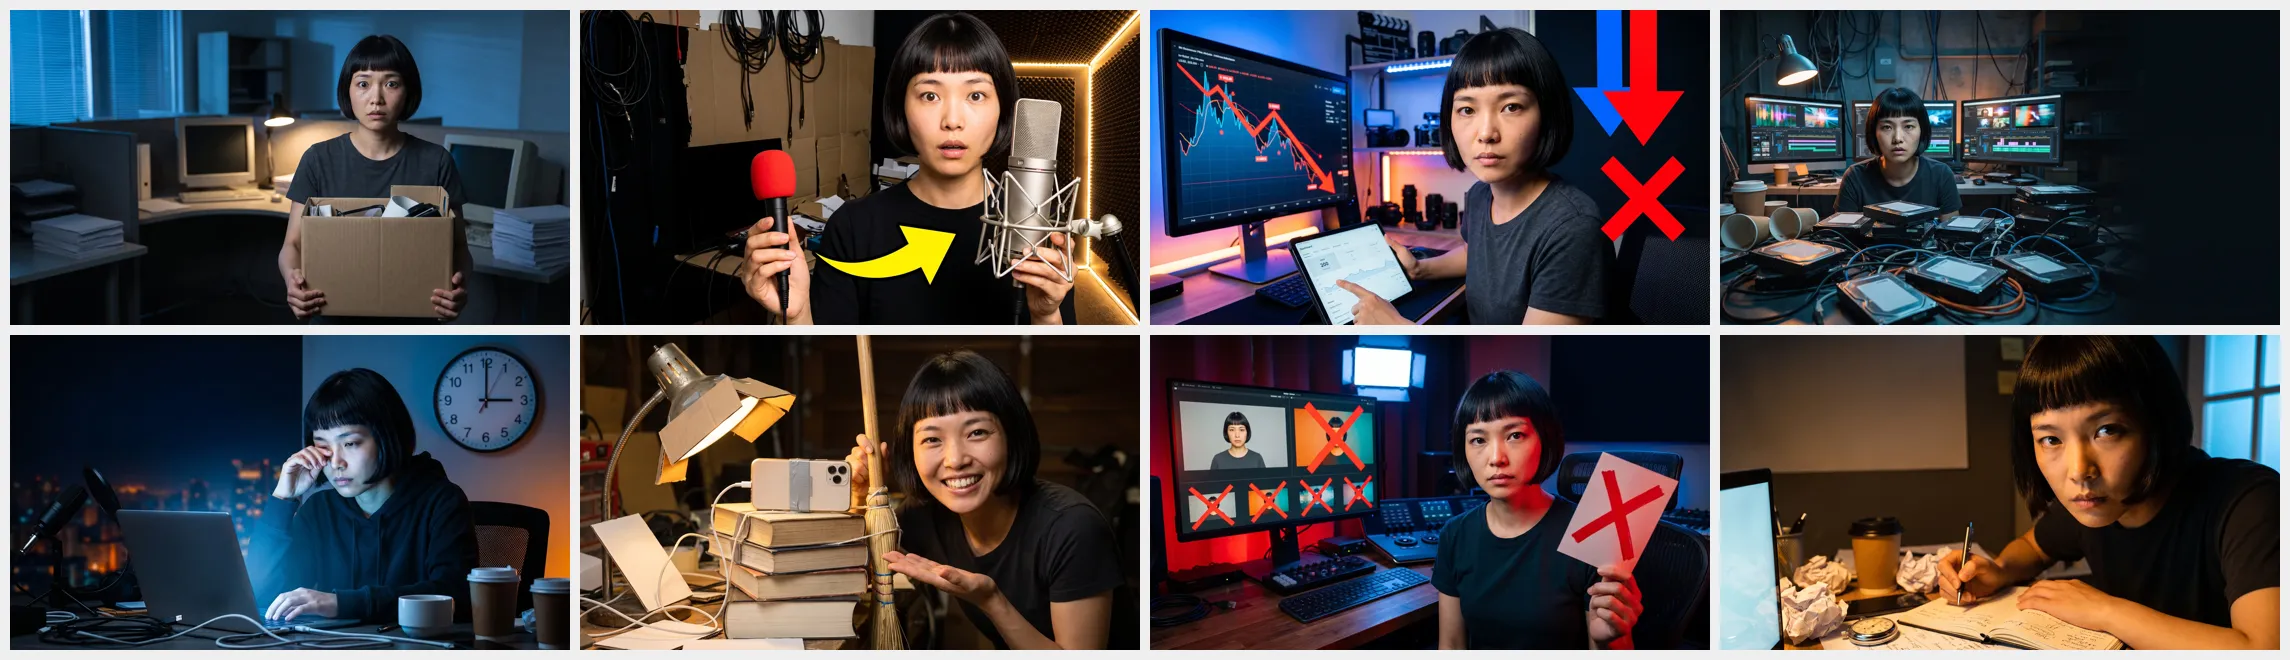
Les huit variables étaient : quitter son emploi, un micro à trente euros qui bat un micro à trois cents, rester bloqué à deux cents vues, monter cent vidéos en une semaine, publier à trois heures du matin pendant un mois, un setup de tournage complet moins cher qu'un téléphone, cinq préréglages d'étalonnage à abandonner, et écrire un script en douze minutes.
Ce qui est revenu n'a plus rien à voir avec la première passe. Une flèche jaune entre un micro-main rouge et un micro à condensateur. Une courbe rouge qui s'effondre sur un écran, avec une croix rouge à côté. Une rangée de vignettes de préréglages barrées une à une. Une horloge murale devant une ville de nuit à trois heures du matin. Rien de ce vocabulaire graphique ne figurait dans ma consigne : le modèle d'images IA a tout inventé.
Je croyais qu'il ne savait pas écrire. Il sait.
Un conseil circule beaucoup à propos de la génération d'images IA : les modèles ne savent pas écrire de texte lisible, donc tout lettrage en sortie sera illisible. Je m'y tenais, et chaque consigne se terminait par une instruction interdisant le texte dans l'image.
À la fin, j'ai testé et demandé au modèle d'écrire directement le titre dans la zone libre.
C'était juste. Pas une lettre fausse, des formes propres, une graisse cohérente, des césures sensées sur trois lignes. Cette vieille règle ne tient plus vraiment avec les modèles d'images IA d'aujourd'hui.
Je n'ai pourtant pas changé d'avis, car le deuxième test a révélé le vrai problème. J'ai remplacé 200 par 500 dans le titre, sans toucher à un seul autre mot, et j'ai relancé. Le texte restait correct, mais toute la scène avait été remise en place : elle passe d'assise de profil à cadrée de face au centre, l'écran quitte l'extrême gauche pour se placer derrière elle, et la typo change de taille et de position en conséquence. Mises côte à côte, les deux images n'appartiennent pas au même jeu.
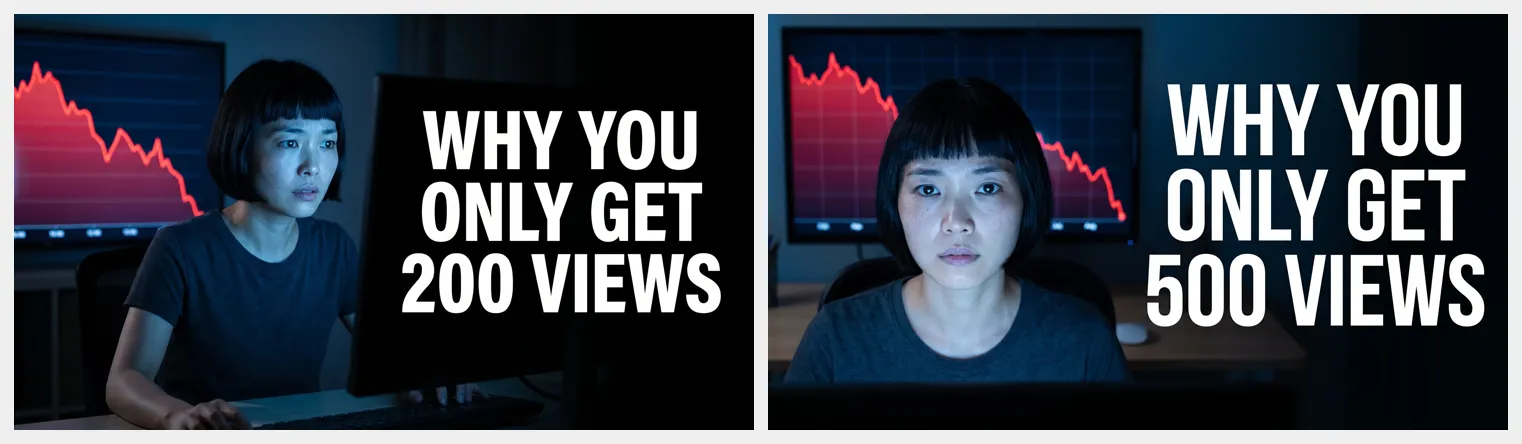
La conclusion tient donc toujours, mais pour une autre raison. Le problème n'est pas qu'il ne sache pas écrire, c'est que la mise en page n'est pas reproductible. Si vous produisez un jeu entier de miniatures YouTube et comptez changer les titres ou les tester en A/B plus tard, gardez le texte hors de l'image et posez-le séparément. Pour un one-shot auquel vous ne retoucherez jamais, laisser le modèle l'écrire vous fait gagner une étape.
Les quatre que j'ai jetées
Confier la direction artistique à un modèle d'images IA a un coût : il glisse volontiers dans le cadre des choses que vous n'avez jamais demandées. Quatre reprises, trois défauts distincts.
Des marques réelles. Sur l'image « quitter son emploi », il lui a mis dans les mains un micro portant le nom d'un fabricant bien réel sur le flanc. Sur celle des cent montages, il a posé sur le bureau deux canettes de boisson énergisante immédiatement identifiables. Ni l'un ni l'autre n'a sa place dans une image destinée à la publication.
Un sujet dupliqué. J'ai ajouté une clause interdisant les marques et relancé l'image « quitter son emploi » : je me suis retrouvé avec deux exemplaires d'elle, l'une tapant à un bureau, l'autre debout à côté avec un carton dans les bras. Le modèle avait lu « quitter le bureau » comme une scène nécessitant deux comédiennes.
Du texte sur les accessoires. Sur l'image du setup à petit budget, il a écrit proprement deux mots anglais sur le carton. C'est le défaut le plus gênant ici : ces images sont partagées entre 21 langues, donc du texte dans une seule langue devient du bruit pour les lecteurs des vingt autres.
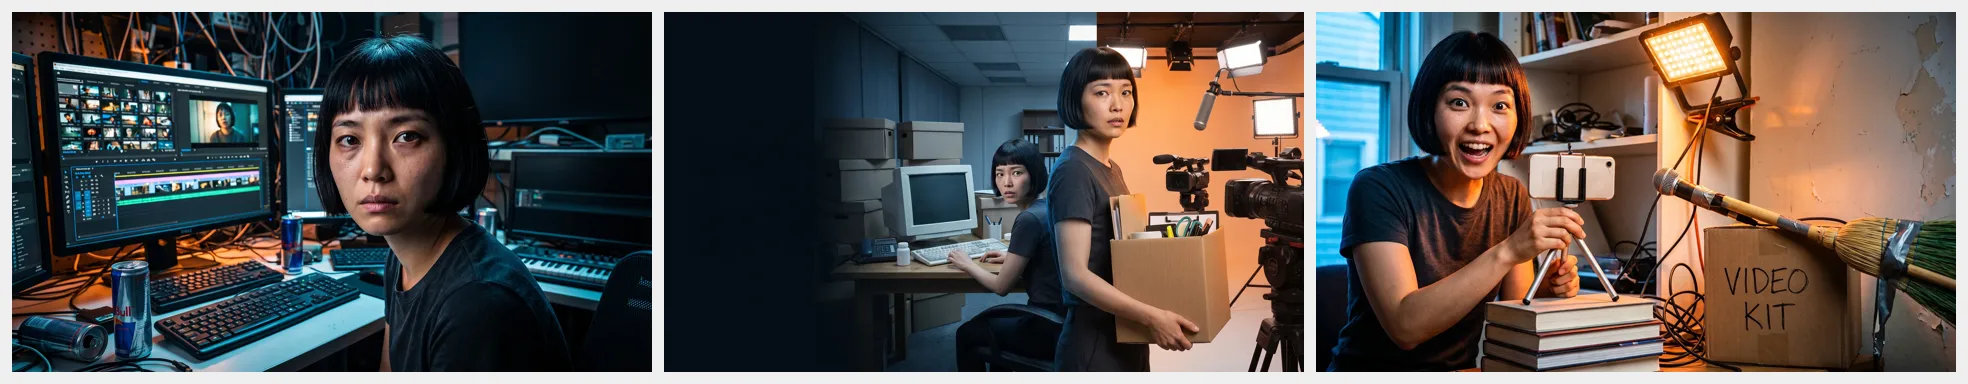
Les trois sont devenus des clauses du bloc fixe, et il faut les écrire précisément. « Pas de texte » ne suffit pas : il faut préciser aucun lettrage sur les écrans, emballages, étiquettes, matériels ou enseignes. « Une seule personne » ne suffit pas non plus, il faut aussi exclure un second exemplaire d'elle, un reflet, et un portrait d'elle en arrière-plan.
Une structure de consigne à copier telle quelle
Le bloc fixe est collé sans changement dans chaque consigne, et dit à peu près ceci.
Utilise la même personne que sur l'image de référence, même coiffure. Elle doit être immédiatement reconnaissable comme la même personne, visage éclairé, non masqué et globalement tourné vers l'objectif, buste dans le cadre. Tu es le directeur artistique et tu conçois une miniature YouTube qui doit décrocher un clic à 168 pixels de large — tout sauf son identité relève de toi : décor, accessoires, éléments graphiques, palette, lumière, profondeur et cadrage. Sois audacieux, très contrasté et spécifique à ce sujet, pas un portrait sur fond uni. Réserve dans l'image une zone propre pour un titre ajouté plus tard. Aucun texte, aucune lettre, aucun chiffre nulle part, y compris sur les écrans, emballages, étiquettes, matériels ou enseignes. Aucun logo de marque ni marque déposée identifiable ; tous les accessoires sans marquage. Exactement une personne dans le cadre.
Le bloc variable tient en une phrase — de quoi parle cette vidéo.
Ces trois dernières interdictions ont toutes été ajoutées après une reprise, une clause par défaut constaté. La structure se transpose telle quelle à d'autres modèles d'images IA ; seules les habitudes de formulation changent.
Une miniature, deux usages
Une fois les huit figées, les images IA avaient encore un service à rendre. J'ai pris celle de trois heures du matin comme image de départ et j'ai utilisé la génération vidéo à partir de la première et dernière image pour produire une intro de cinq secondes.
Il y a là aussi un vrai piège. Le plan généré a recadré la scène, et la zone propre que j'avais soigneusement réservée au titre a été largement mangée. Pour une intro, aucune importance. Pour une carte de fin, il faudrait tout remettre en page.
Pour lancer un lot entier d'un coup, étaler les huit tâches d'images IA sur la toile générative vaut mieux que d'y aller une par une : on voit d'un coup d'œil ce qu'on garde et ce qu'on refait. Si vous préférez ne pas écrire les consignes de zéro, les modèles proposent des styles de portrait applicables directement.
Huit images finales en un après-midi
Le jeu complet de miniatures YouTube a pris un après-midi, de la première génération aux huit images validées, avec quatre mises au rebut. Le plus long n'a été ni la génération ni la retouche, mais de comprendre ce qu'il fallait déléguer au modèle : j'ai d'abord trop serré, cloué la composition, et récupéré huit images qui se ressemblaient toutes.
Pour reproduire la démarche, l'ordre est le suivant : mesurer la zone de sécurité et les trois tailles d'affichage réelles, produire une image de référence peu flatteuse mais propre, réduire le bloc fixe à la personne et à ces quelques interdictions, et traiter le sujet de chaque image comme la seule variable. Pour le texte : ajoutez-le après coup pour un jeu, laissez le modèle l'écrire pour un one-shot.
Le jeu complet de miniatures YouTube n'a mobilisé que deux outils d'images IA, la génération d'images IA et l'édition d'images IA.