Hice 8 miniaturas de YouTube con IA: medidas, encuadre y las cuatro que tiré
Que un vídeo reciba clics depende de su miniatura más de lo que la mayoría supone. Dediqué una tarde entera a producir un juego completo de 8 miniaturas de YouTube con generación de imágenes IA. Cuatro acabaron descartadas por el camino, un resultado contradijo un consejo que daba por sentado, y cometí un error más de fondo que merece su propia sección.
Mide las especificaciones antes de generar nada
El tamaño recomendado de una miniatura de YouTube es 1280×720, es decir 16:9. Mucha gente conoce ese número. Hay otras dos cosas que pesan más en el resultado final.
La primera: la esquina inferior derecha queda tapada por la insignia de duración del vídeo. Llevado a 1280×720 ocupa unos 132×36, y cualquier cosa que pongas ahí pierde la mitad.
La segunda, más fácil de olvidar: las miniaturas nunca se muestran a tamaño real en un feed. La página de inicio de escritorio las enseña a unos 360px de ancho, y el feed de recomendaciones móvil se queda a menudo en unos 168px. Reduje la misma miniatura de YouTube a esos tres tamaños y los puse en fila. A 360px todavía se leen los objetos y la expresión. A 168px solo sobrevive una mancha de color y una silueta humana.
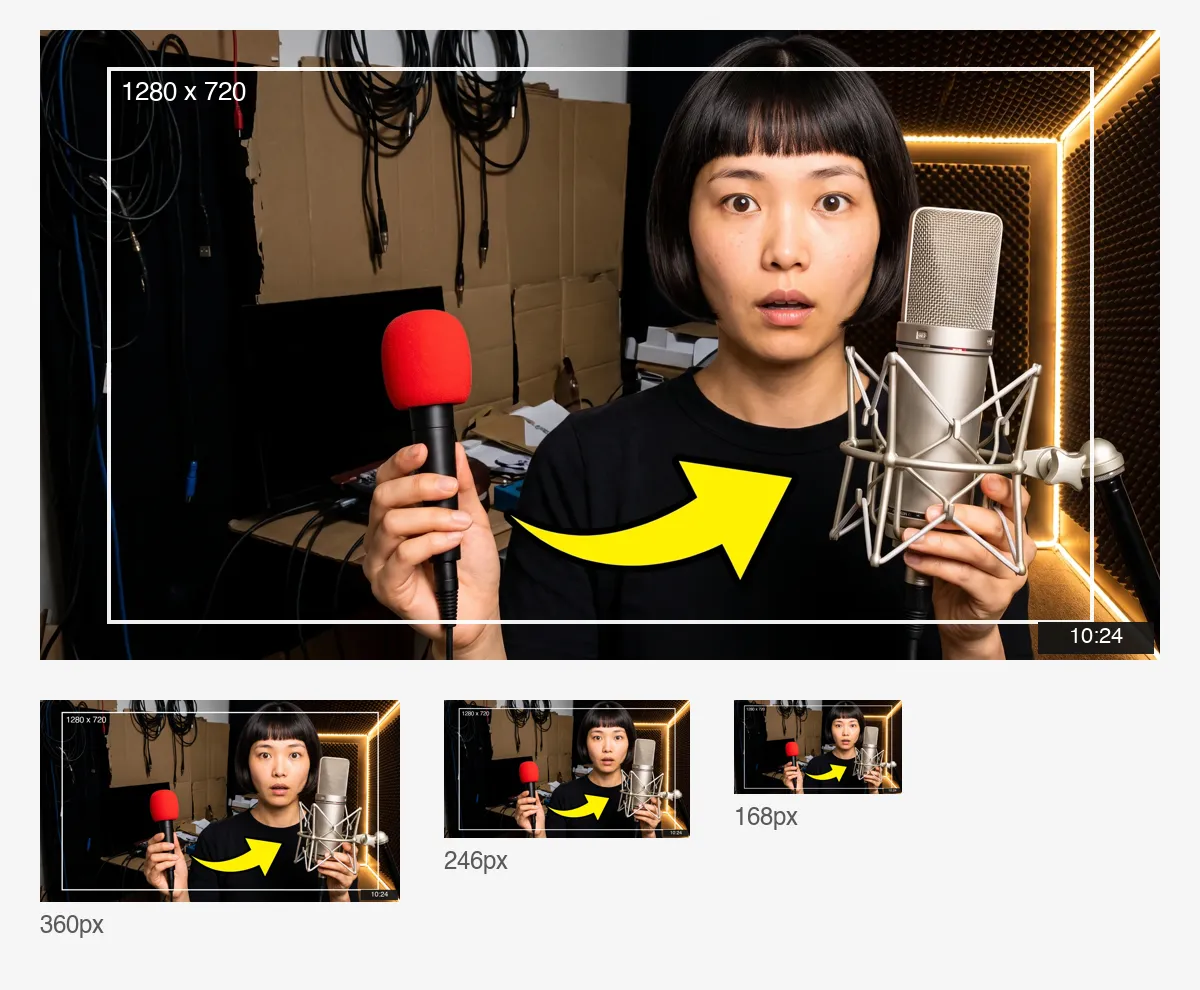
Así que fijé dos reglas antes de generar nada. Mantener al sujeto y todo lo relevante dentro de una zona segura central con un 6% de margen por los cuatro lados, y dejar vacía la esquina inferior derecha. Y reservar en el encuadre una zona limpia para superponer un titular después.
Empieza por una foto de casting: es el cimiento del juego
Lo más difícil de todo el trabajo es que la persona de las ocho miniaturas tiene que ser la misma.
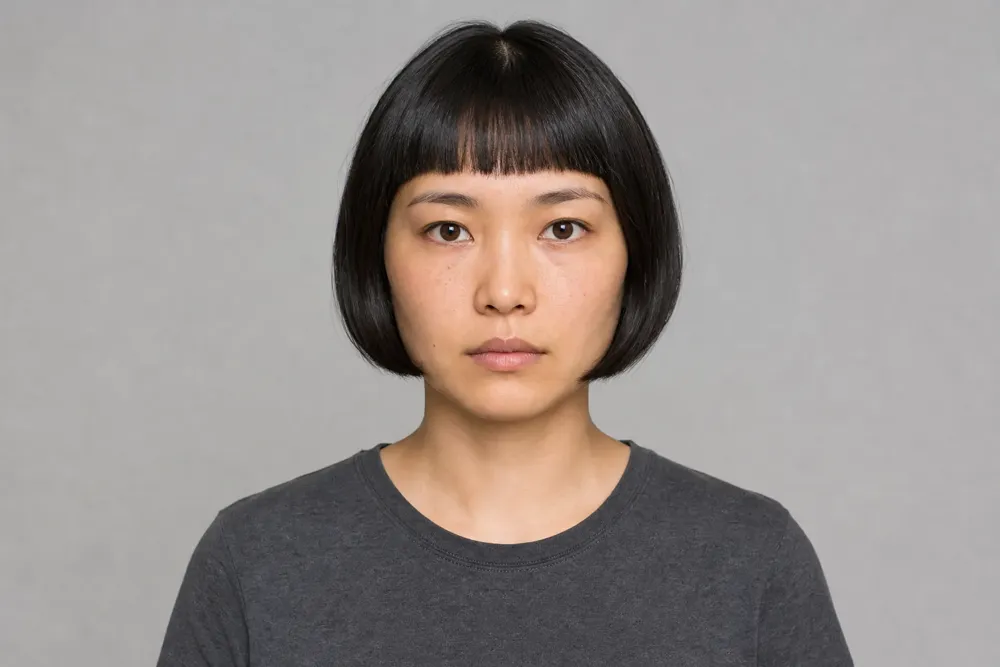
Mi método fue producir primero un fotograma de referencia limpio con generación de imágenes IA: de frente, a la altura de los ojos, sin maquillaje, sin expresión, fondo gris, luz plana y uniforme, como una foto de casting. Esa imagen no resulta atractiva y nunca se pensó para publicarse. Su único cometido es servir de referencia a todos los fotogramas siguientes.
Y aquí llega el error.
En mi primera pasada también dejé clavada la composición. Sujeto en el tercio izquierdo, contorno blanco recortado a su alrededor, un estallido de rayos detrás de la cabeza, un bloque plano de color llenando la mitad derecha. Lo único que podía cambiar era su expresión y el color de fondo. Ocho imágenes después su cara no había variado ni un ápice, y el conjunto parecía una tabla de emociones más que ocho miniaturas. Otra cara, otro color, nada más.
La razón es sencilla. Una miniatura de verdad se diseña alrededor de lo que trata el vídeo, y la única variable que le había dado al modelo era una expresión facial. No tenía nada que diseñar, así que repitió mi plantilla ocho veces.
La corrección fue devolverle el diseño. El bloque fijo ahora solo bloquea lo que hay que bloquear: la misma persona, su cara iluminada y sin obstrucciones, el torso en cuadro. Escenario, atrezo, elementos gráficos, paleta, luz, profundidad y encuadre pasan a ser decisión del modelo. El bloque variable se convirtió en una sola frase: de qué va este vídeo.
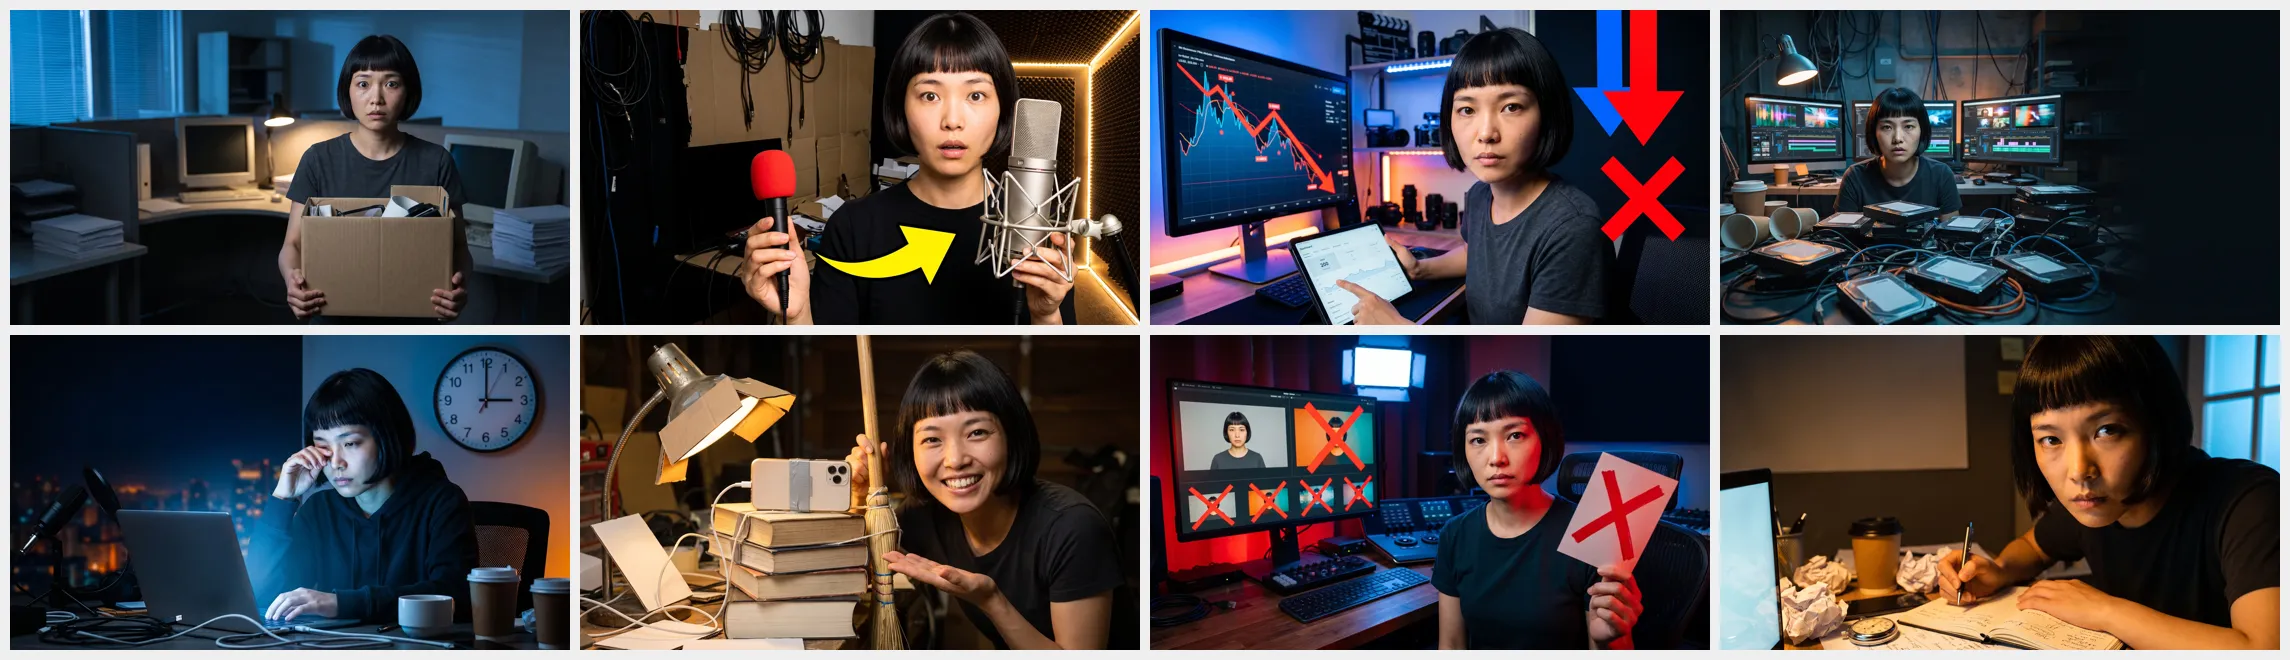
Las ocho variables fueron: dejar el trabajo, un micro de treinta euros que gana a uno de trescientos, estancarse en doscientas visualizaciones, montar cien vídeos en una semana, publicar a las tres de la madrugada durante un mes, un equipo de rodaje completo más barato que un móvil, cinco preajustes de color que hay que dejar de usar, y escribir un guion en doce minutos.
Lo que devolvió no juega en la misma liga que la primera pasada. Una flecha amarilla entre un micro de mano rojo y uno de condensador. Una línea roja desplomándose en un monitor con una cruz roja al lado. Una fila de miniaturas de preajustes tachadas una a una. Un reloj de pared contra el perfil nocturno de la ciudad a las tres de la madrugada. Nada de ese lenguaje gráfico estaba en mi indicación: lo inventó todo el modelo de imágenes IA.
Creía que no sabía escribir. Sí sabe.
Sobre la generación de imágenes IA circula mucho un consejo: los modelos no saben escribir texto legible, así que cualquier rótulo saldrá corrupto. Yo lo seguía, y todas mis indicaciones terminaban con una instrucción para mantener el texto fuera del encuadre.
Al final lo probé y le pedí al modelo que escribiera el titular directamente en la zona libre.
Lo escribió bien. Ni una letra equivocada, formas limpias, grosor coherente, cortes de línea sensatos en tres líneas. Esa vieja regla ya no se sostiene del todo con los modelos de imágenes IA de hoy.
Aun así no cambié de idea, porque la segunda prueba destapó el problema real. Cambié 200 por 500 en el titular, sin tocar ninguna otra palabra, y volví a lanzarlo. El texto seguía siendo correcto, pero todo el encuadre se había reorganizado: ella pasa de estar sentada de perfil a mirar de frente en el centro, el monitor se traslada del extremo izquierdo a justo detrás de ella, y la tipografía cambia de tamaño y de posición para acompañarlo. Puestas una al lado de la otra, no pertenecen al mismo juego.
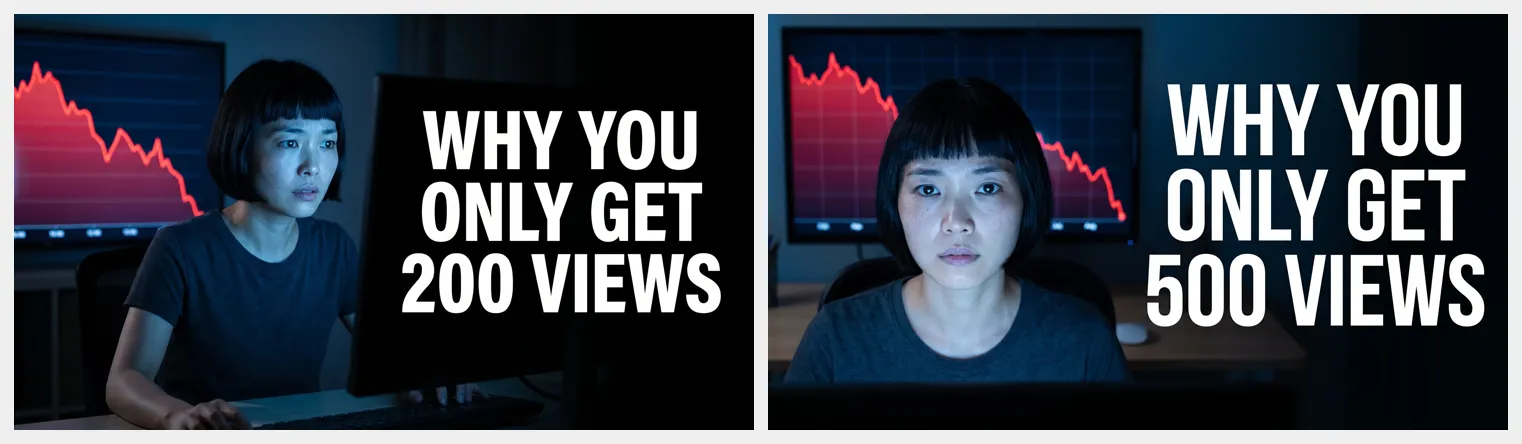
La conclusión sigue en pie, pero por otro motivo. El problema no es que no sepa escribir, sino que la maquetación no es reproducible. Si vas a hacer un juego entero de miniaturas de YouTube y cuentas con cambiar titulares o probarlos en A/B más adelante, deja el texto fuera de la imagen y superponlo aparte. Para una pieza única que no vas a tocar más, dejar que lo escriba el modelo te ahorra un paso.
Las cuatro que tiré
Ceder el control del diseño a un modelo de imágenes IA tiene un precio: mete en el encuadre, tan tranquilo, cosas que nunca pediste. Cuatro repeticiones, tres fallos distintos.
Marcas reales. En la imagen de dejar el trabajo le puso en las manos un micrófono con el nombre de un fabricante real impreso en el lateral. En la de los cien montajes colocó sobre la mesa dos latas de bebida energética reconocibles al instante. Ninguna de las dos cosas cabe en una imagen que vas a publicar.
Sujeto duplicado. Añadí una cláusula que prohibía las marcas y relancé la imagen de dejar el trabajo: aparecieron dos versiones de ella, una tecleando en un escritorio y otra de pie al lado con una caja de cartón en brazos. El modelo había leído «salir de la oficina» como una escena que necesita dos actrices.
Texto en el atrezo. En la imagen del equipo barato escribió pulcramente dos palabras en inglés sobre la caja de cartón. Este es el fallo que más importa aquí: estas imágenes se comparten entre 21 idiomas, así que un texto en uno solo es ruido para los lectores de los otros veinte.
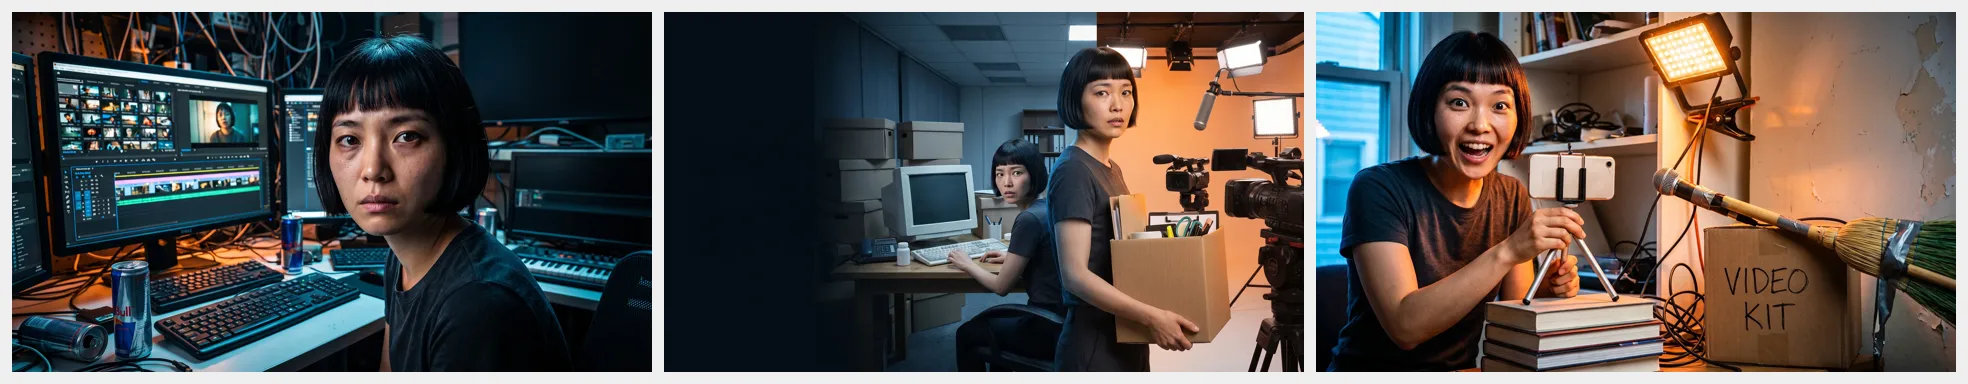
Los tres acabaron como cláusulas del bloque fijo, y tienen que ser específicas. «Sin texto» no basta: hay que decir sin rótulos en pantallas, envases, etiquetas, equipos ni carteles. «Una sola persona» tampoco basta; hay que descartar además una segunda versión de ella, un reflejo y un retrato suyo en el fondo.
Una estructura de indicación que puedes copiar
El bloque fijo se pega sin cambios en cada indicación y dice más o menos esto.
Usa a la misma persona de la imagen de referencia, mismo peinado. Debe ser reconocible al instante como la misma persona, con la cara iluminada, sin obstrucciones y aproximadamente hacia cámara, torso en cuadro. Eres el director de arte y diseñas una miniatura de YouTube que tiene que ganarse un clic a 168 píxeles de ancho: todo salvo su identidad lo decides tú, escenario, atrezo, elementos gráficos, paleta, luz, profundidad y encuadre. Hazlo audaz, de alto contraste y específico para este tema, no un retrato sobre un fondo de color. Reserva en el encuadre una zona limpia para un titular que se añadirá después. Ningún texto, letra ni número en ninguna parte, tampoco en pantallas, envases, etiquetas, equipos ni carteles. Ningún logotipo de marca ni marca registrada reconocible; todo el atrezo sin marcar. Exactamente una persona en el encuadre.
El bloque variable es una frase: de qué va este vídeo.
Esas tres últimas prohibiciones se añadieron todas después de una repetición, una cláusula por fallo. La estructura se traslada sin cambios a otros modelos de imágenes IA; solo cambian las costumbres de redacción.
Una miniatura, dos usos
Una vez cerradas las ocho, a las imágenes IA les quedaba un encargo más. Tomé la de las tres de la madrugada como fotograma inicial y usé generación de vídeo con primer y último fotograma para producir una intro de cinco segundos.
Aquí también hay una trampa real. El plano generado reencuadró la escena, y la zona limpia que había reservado con cuidado para el titular quedó casi devorada. Para una intro da igual. Para una tarjeta final habría que volver a maquetar.
Para lanzar un lote entero de golpe, repartir los ocho trabajos de imágenes IA por el lienzo generativo va mejor que ir de uno en uno: ves de un vistazo cuál conservar y cuál rehacer. Si prefieres no escribir las indicaciones desde cero, en plantillas hay estilos de retrato que puedes aplicar directamente.
Ocho imágenes finales en una tarde
El juego completo de miniaturas de YouTube llevó una tarde desde el primer envío hasta los ocho fotogramas cerrados, con cuatro descartados. Lo lento no fue ni generar ni retocar, sino averiguar qué había que delegar en el modelo: al principio apreté demasiado, clavé la composición y me llevé ocho imágenes que se parecían todas entre sí.
Si quieres reproducirlo, el orden es: mide la zona segura y los tres tamaños reales de visualización, genera un fotograma de referencia poco lucido pero limpio, reduce el bloque fijo a la persona más esas pocas prohibiciones, y trata el tema de cada imagen como la única variable. En cuanto al texto: añádelo después si es un juego, deja que lo escriba el modelo si es una pieza única.
El juego completo de miniaturas de YouTube usó exactamente dos herramientas de imágenes IA, generación de imágenes IA y edición de imágenes IA.