Ich habe 8 YouTube-Thumbnails mit KI gebaut: Maße, Bildaufbau und die vier, die rausflogen
Ob ein Video geklickt wird, hängt stärker vom Thumbnail ab, als die meisten annehmen. Ich habe einen Nachmittag damit verbracht, mit KI-Bildgenerierung einen kompletten Satz von 8 YouTube-Thumbnails zu produzieren. Vier flogen unterwegs raus, ein Ergebnis widersprach einem Rat, den ich für gesetzt hielt, und ich habe einen grundlegenderen Fehler gemacht, der einen eigenen Abschnitt verdient.
Erst die Maße nachmessen, dann generieren
Die empfohlene Größe für ein YouTube-Thumbnail ist 1280×720, also 16:9. Diese Zahl kennen viele. Zwei andere Dinge entscheiden stärker darüber, wie das fertige Bild wirkt.
Erstens: Die rechte untere Ecke wird vom Badge mit der Videolänge überdeckt. Auf 1280×720 gerechnet sind das rund 132×36, und was dort liegt, verliert die Hälfte.
Zweitens, und leichter zu übersehen: Thumbnails werden in einem Feed nie in Originalgröße gezeigt. Die Startseite am Rechner zeigt sie mit etwa 360px Breite, der Empfehlungsfeed am Handy oft nur mit rund 168px. Ich habe dasselbe YouTube-Thumbnail auf alle drei Größen herunterskaliert und nebeneinandergelegt. Bei 360px sind Requisiten und Gesichtsausdruck noch lesbar. Bei 168px bleibt nur ein Farbfleck und eine menschliche Silhouette.
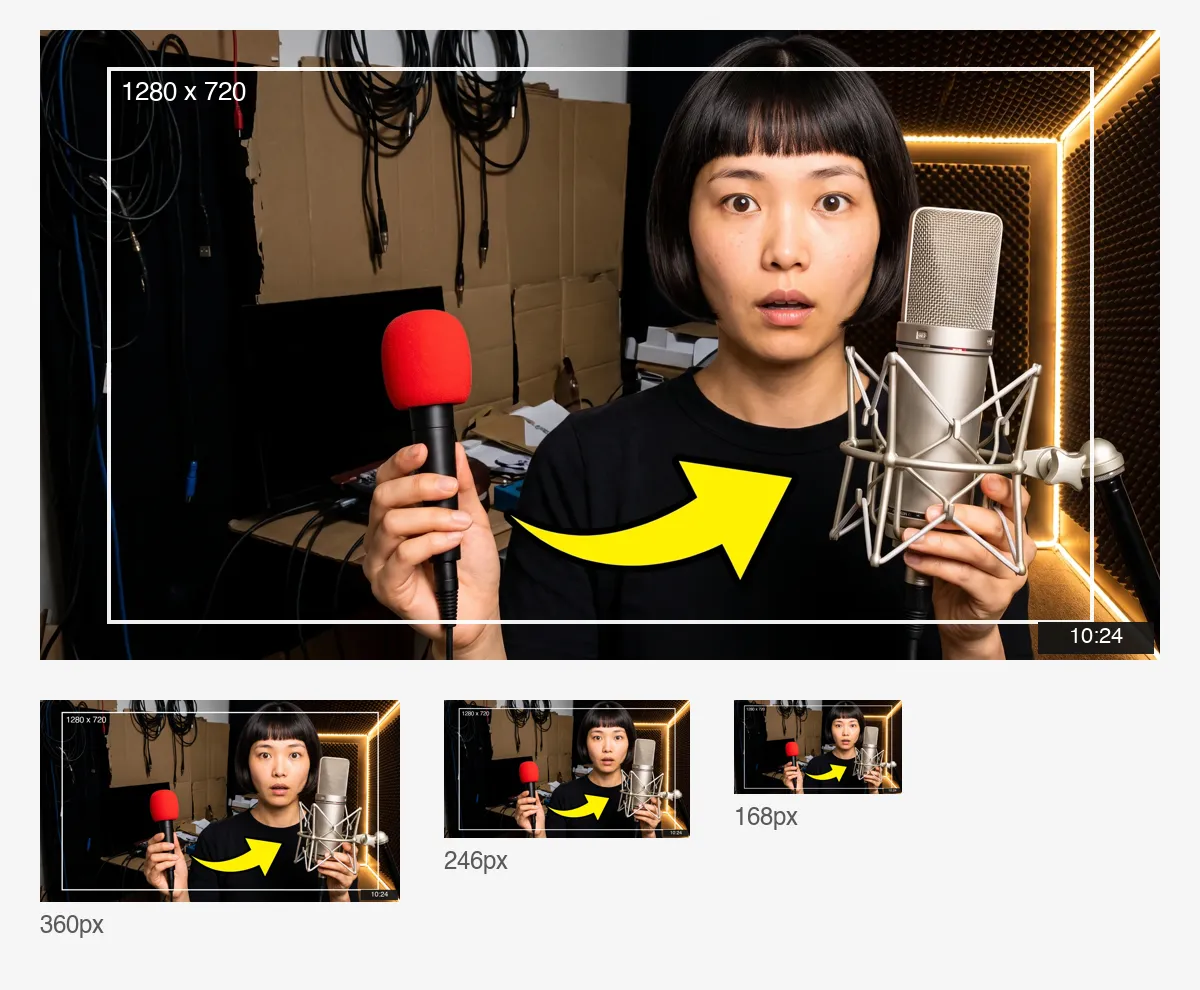
Also habe ich vor dem ersten Generieren zwei Regeln festgelegt. Motiv und alles Wichtige bleiben in einer mittigen Schutzzone mit 6% Rand auf allen Seiten, und die rechte untere Ecke bleibt frei. Dazu reserviere ich im Bild eine saubere Fläche, auf die später eine Schlagzeile gelegt wird.
Mit einem Castingfoto anfangen — das ist das Fundament des Satzes
Das Schwierigste an der ganzen Arbeit ist, dass die Person auf allen acht Thumbnails dieselbe sein muss.
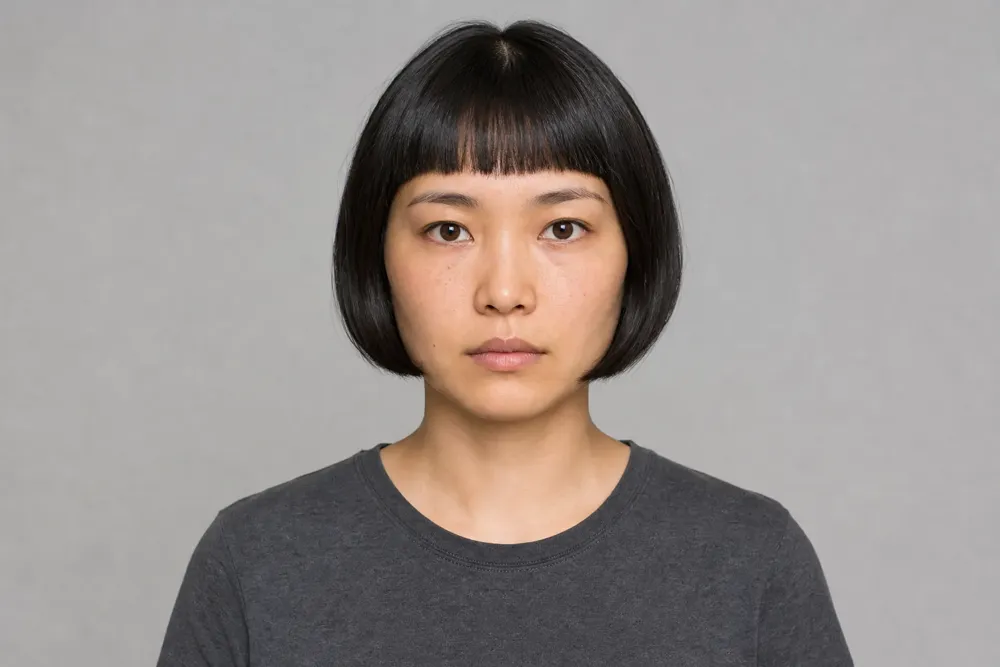
Mein Weg war, zuerst ein sauberes Referenzbild mit KI-Bildgenerierung zu erzeugen: frontal, auf Augenhöhe, ungeschminkt, ohne Mimik, grauer Hintergrund, flaches gleichmäßiges Licht, wie ein Castingfoto. Dieses Bild sieht nach nichts aus und war nie zur Veröffentlichung gedacht. Seine einzige Aufgabe ist, für jedes folgende Bild die Referenz zu sein.
Und jetzt zum Fehler.
Im ersten Durchgang hatte ich auch den Bildaufbau festgezurrt. Motiv im linken Drittel, weiße Freistellerkontur um sie herum, ein Strahlenkranz hinter dem Kopf, eine flache Farbfläche auf der rechten Hälfte. Ändern durften sich nur Gesichtsausdruck und Hintergrundfarbe. Acht Bilder später war ihr Gesicht kein Stück abgedriftet, und der Satz sah aus wie eine Gefühlstabelle statt wie acht Thumbnails. Anderes Gesicht, andere Farbe, sonst nichts.
Der Grund ist simpel. Ein echtes Thumbnail wird um das Thema des Videos herum entworfen, und die einzige Variable, die ich dem Modell gegeben hatte, war ein Gesichtsausdruck. Es gab nichts zu gestalten, also hat es meine Vorlage achtmal wiederholt.
Die Korrektur bestand darin, die Gestaltung zurückzugeben. Der feste Block sperrt jetzt nur noch, was gesperrt gehört: dieselbe Person, ihr Gesicht ausgeleuchtet und unverdeckt, Oberkörper im Bild. Schauplatz, Requisiten, grafische Elemente, Farbpalette, Licht, Tiefe und Bildaufbau entscheidet das Modell. Der variable Block wurde zu einem einzigen Satz — worum es in diesem Video geht.
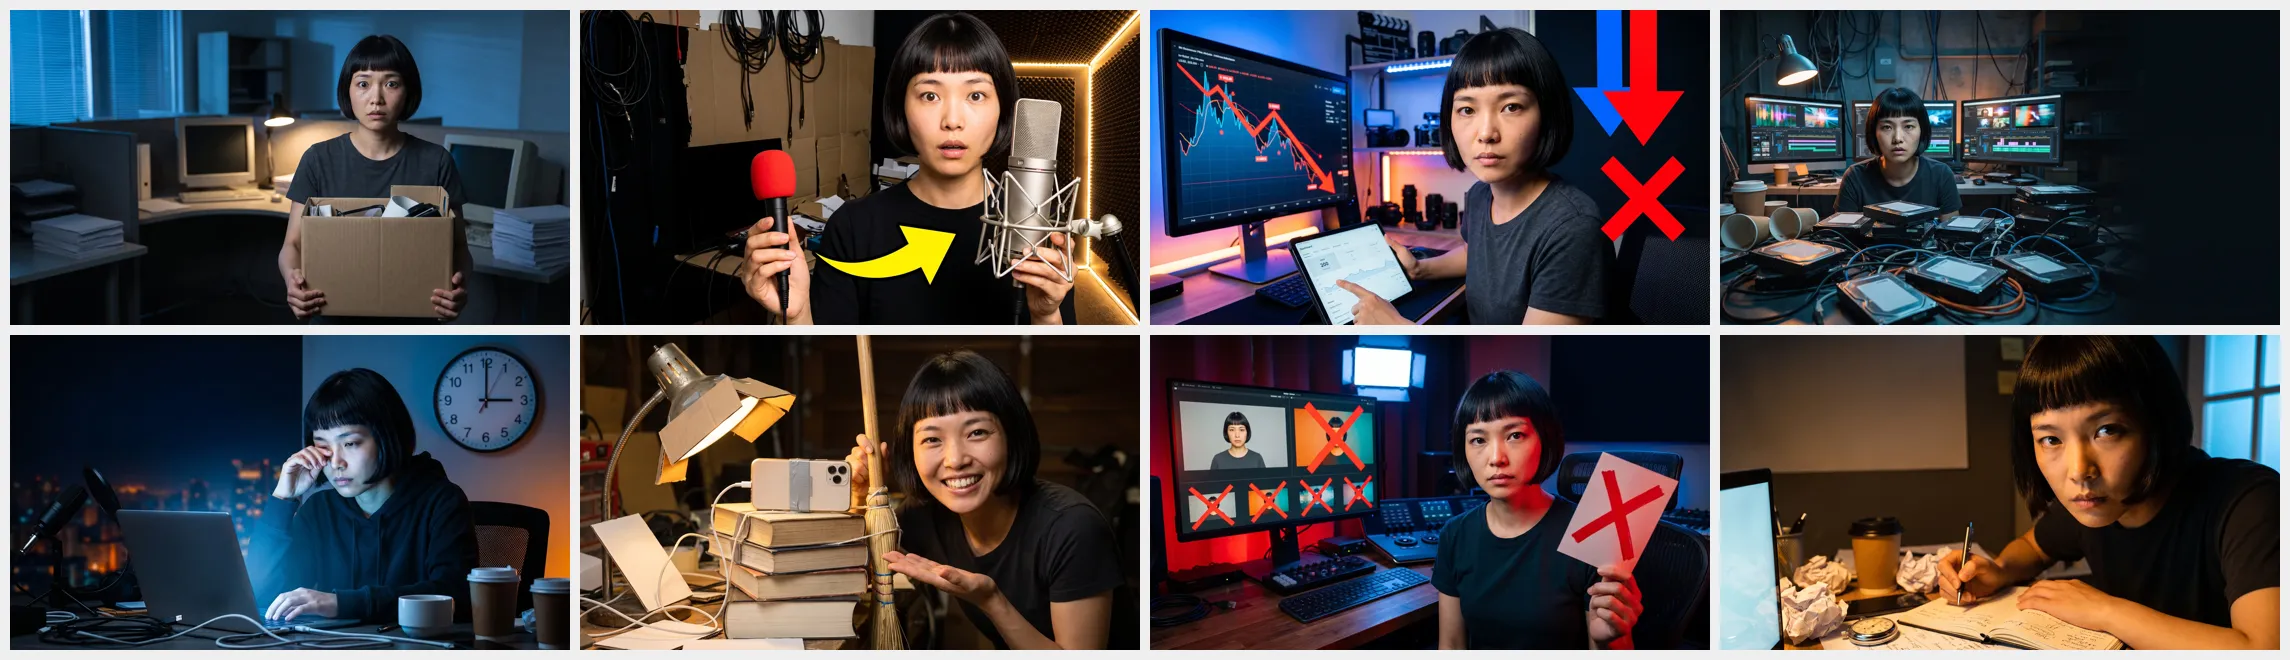
Die acht Variablen lauteten: den Bürojob kündigen, ein Mikro für dreißig Euro schlägt eines für dreihundert, bei zweihundert Aufrufen feststecken, hundert Videos in einer Woche schneiden, einen Monat lang um drei Uhr nachts hochladen, ein komplettes Drehsetup billiger als ein Handy, fünf Farblooks, die man weglassen sollte, und ein Skript in zwölf Minuten schreiben.
Was zurückkam, spielt in einer anderen Liga als der erste Durchgang. Ein gelber Pfeil zwischen einem roten Handmikro und einem Kondensatormikrofon. Eine rote Kurve, die über einen Monitor abstürzt, daneben ein rotes Kreuz. Eine Reihe von Preset-Vorschaubildern, jedes einzeln durchgestrichen. Eine Wanduhr vor nächtlicher Stadtsilhouette um drei Uhr. Nichts von dieser Bildsprache stand in meinem Prompt — das KI-Bildmodell hat sich das alles selbst ausgedacht.
Ich dachte, es kann keine Schrift. Es kann.
Über KI-Bildgenerierung kursiert ein Rat besonders hartnäckig: Modelle können keine lesbare Schrift setzen, also wird jede Beschriftung im Ergebnis verhunzt. Ich habe mich daran gehalten, und jeder Prompt endete mit der Anweisung, Text aus dem Bild herauszuhalten.
Am Ende habe ich es getestet und das Modell gebeten, die Schlagzeile direkt in die freie Fläche zu setzen.
Es hat sie richtig gesetzt. Kein falscher Buchstabe, saubere Formen, passende Schriftstärke, sinnvolle Umbrüche über drei Zeilen. Diese alte Regel trägt bei heutigen KI-Bildmodellen nicht mehr wirklich.
Meine Haltung habe ich trotzdem nicht geändert, denn der zweite Test legte das eigentliche Problem offen. Ich habe in der Schlagzeile 200 durch 500 ersetzt, kein weiteres Wort angefasst und neu laufen lassen. Die Schrift stimmte weiterhin, aber das gesamte Bild war neu arrangiert: Sie sitzt nicht mehr im Profil, sondern frontal in der Mitte, der Monitor wandert vom linken Rand direkt hinter sie, und die Typografie ändert Größe und Position mit. Nebeneinandergelegt gehören die beiden Bilder nicht zum selben Satz.
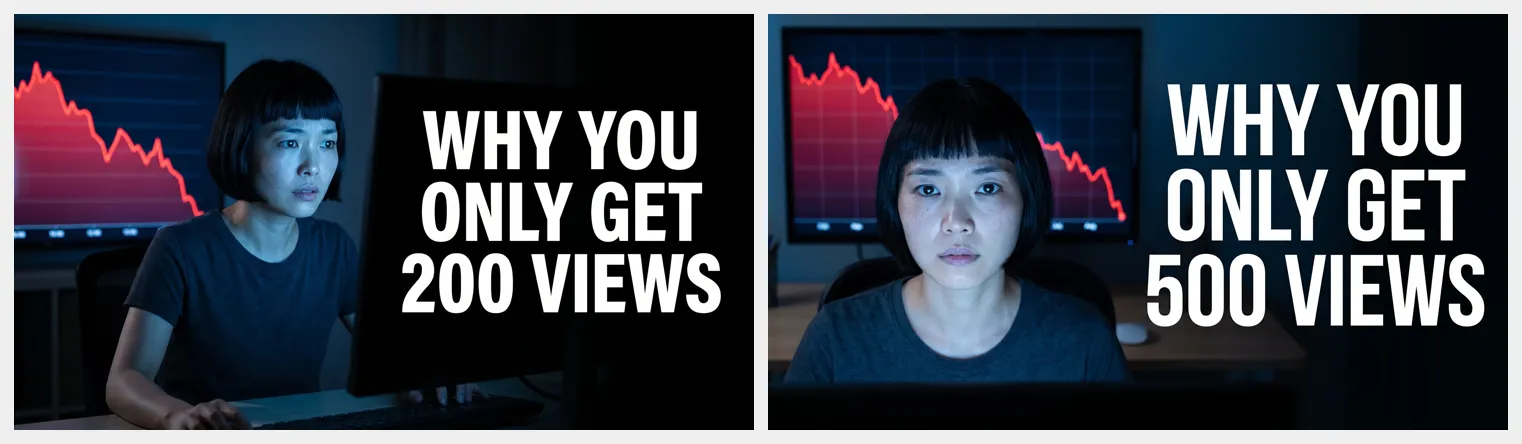
Die Schlussfolgerung bleibt also, die Begründung ändert sich. Das Problem ist nicht, dass es keine Schrift kann. Das Problem ist, dass das Layout nicht reproduzierbar ist. Wenn Sie einen ganzen Satz YouTube-Thumbnails bauen und später Schlagzeilen tauschen oder A/B-testen wollen, halten Sie Text aus dem Bild heraus und legen ihn separat darüber. Für ein Einzelstück, das Sie nie wieder anfassen, spart es einen Arbeitsschritt, das Modell schreiben zu lassen.
Die vier, die rausflogen
Die Gestaltungshoheit an ein KI-Bildmodell abzugeben, hat einen Preis: Es packt bereitwillig Dinge ins Bild, nach denen Sie nie gefragt haben. Vier Wiederholungen, drei verschiedene Fehler.
Echte Marken. Im Kündigungsbild hat es ihr ein Mikrofon in die Hand gegeben, auf dessen Seite der Name eines realen Herstellers steht. Im Bild mit den hundert Schnitten standen zwei sofort erkennbare Energydrink-Dosen auf dem Tisch. Beides gehört nicht in ein Bild, das veröffentlicht werden soll.
Ein verdoppeltes Motiv. Ich habe eine Klausel gegen Markenzeichen ergänzt und das Kündigungsbild neu laufen lassen — und bekam sie doppelt: einmal am Schreibtisch tippend, einmal daneben stehend mit einem Karton im Arm. Das Modell hatte "das Büro verlassen" als Szene gelesen, die zwei Darstellerinnen braucht.
Schrift auf Requisiten. Im Bild mit dem billigen Setup hat es zwei englische Wörter sauber auf den Karton geschrieben. Das wiegt hier am schwersten: Diese Bilder werden über 21 Sprachen hinweg geteilt, Text in nur einer Sprache ist für die Leser der anderen zwanzig also Rauschen.
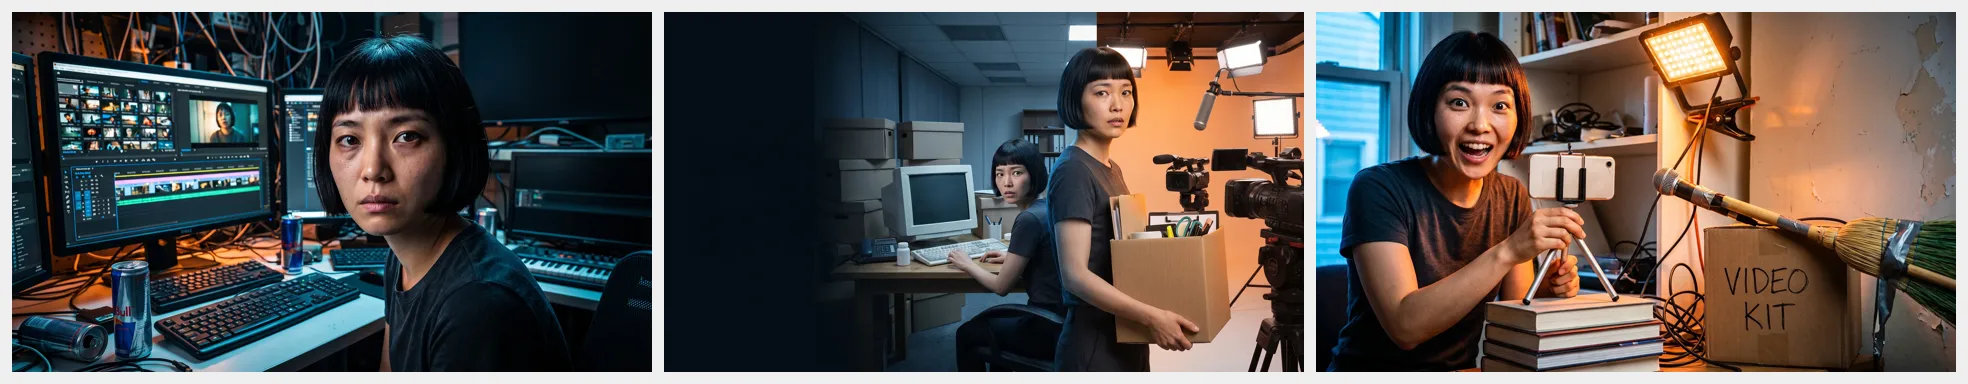
Alle drei wurden zu Klauseln im festen Block, und sie müssen konkret formuliert sein. "Kein Text" reicht nicht — es muss dastehen: keine Schrift auf Bildschirmen, Verpackungen, Etiketten, Geräten oder Schildern. "Eine Person" reicht ebenfalls nicht; man muss zusätzlich eine zweite Ausgabe von ihr, eine Spiegelung und ein Porträt von ihr im Hintergrund ausschließen.
Eine Prompt-Struktur zum Abschreiben
Der feste Block wird unverändert in jeden Prompt kopiert und lautet ungefähr so.
Verwende dieselbe Person wie auf dem Referenzbild, gleiche Frisur. Sie muss sofort als dieselbe Person erkennbar sein, Gesicht ausgeleuchtet, unverdeckt und grob zur Kamera gerichtet, Oberkörper im Bild. Du bist der Art Director und entwirfst ein YouTube-Thumbnail, das sich bei 168 Pixeln Breite einen Klick verdienen muss — alles außer ihrer Identität entscheidest du: Schauplatz, Requisiten, grafische Elemente, Farbpalette, Licht, Tiefe und Bildaufbau. Mach es mutig, kontraststark und spezifisch für dieses Thema, kein Porträt vor farbigem Hintergrund. Lass im Bild eine saubere Fläche für eine später ergänzte Schlagzeile frei. Nirgends Text, Buchstaben oder Ziffern, auch nicht auf Bildschirmen, Verpackungen, Etiketten, Geräten oder Schildern. Keine Markenlogos oder erkennbaren Markenzeichen; alle Requisiten ohne Aufdruck. Genau eine Person im Bild.
Der variable Block ist ein Satz — worum es in diesem Video geht.
Diese letzten drei Verbote wurden alle nach einer Wiederholung ergänzt, eine Klausel pro Fehler. Die Struktur lässt sich unverändert auf andere KI-Bildmodelle übertragen; nur die Formulierungsgewohnheiten unterscheiden sich.
Ein Thumbnail, zweimal genutzt
Als die acht standen, hatten die KI-Bilder noch eine Aufgabe. Ich habe das Drei-Uhr-nachts-Bild als Startframe genommen und mit Video aus erstem und letztem Frame ein fünf Sekunden langes Intro erzeugt.
Auch hier gibt es einen echten Haken. Der erzeugte Clip hat den Bildausschnitt neu gesetzt, und die saubere Fläche, die ich sorgfältig für die Schlagzeile reserviert hatte, war weitgehend aufgefressen. Für ein Intro egal. Für eine Endcard müsste man neu layouten.
Wer einen ganzen Schwung auf einmal laufen lassen will, verteilt die acht KI-Bild-Aufträge besser über die Generative Leinwand, statt eins nach dem anderen abzuarbeiten — man sieht auf einen Blick, was bleibt und was neu muss. Wer die Prompts nicht bei null schreiben möchte, findet unter Vorlagen Porträt-Looks zum direkten Anwenden.
Acht fertige Bilder an einem Nachmittag
Der ganze Satz YouTube-Thumbnails hat vom ersten Lauf bis zu den acht finalen Bildern einen Nachmittag gedauert, vier landeten im Papierkorb. Langsam war weder das Generieren noch das Retuschieren, sondern herauszufinden, was man dem Modell überlässt — anfangs habe ich zu fest zugegriffen, den Bildaufbau festgenagelt und acht Bilder bekommen, die alle gleich aussahen.
Zum Nachbauen ist die Reihenfolge: Schutzzone und die drei realen Anzeigegrößen ausmessen, ein unspektakuläres, aber sauberes Referenzbild erzeugen, den festen Block auf die Person plus diese wenigen Verbote eindampfen und das Thema jedes Bildes als einzige Variable behandeln. Zum Text: für einen Satz nachträglich ergänzen, für ein Einzelstück das Modell schreiben lassen.
Der ganze Satz YouTube-Thumbnails kam mit genau zwei KI-Bildwerkzeugen aus, KI-Bildgenerierung und KI-Bildbearbeitung.