Fiz 8 thumbnails do YouTube com IA: tamanhos, enquadramento e as quatro que joguei fora
Se um vídeo recebe cliques ou não depende do thumbnail muito mais do que a maioria imagina. Passei uma tarde inteira produzindo um conjunto completo de 8 thumbnails do YouTube com geração de imagens por IA. Quatro foram descartados pelo caminho, um resultado contrariou um conselho que eu tinha como certo, e cometi um erro mais de fundo que merece uma seção só para ele.
Meça as especificações antes de gerar qualquer coisa
O tamanho recomendado de um thumbnail do YouTube é 1280×720, ou seja, 16:9. Muita gente conhece esse número. Outras duas coisas pesam mais no resultado final.
Primeiro: o canto inferior direito fica coberto pelo selo de duração do vídeo. Convertido para 1280×720, ele ocupa cerca de 132×36, e qualquer coisa colocada ali perde metade de si.
Segundo, e mais fácil de esquecer: thumbnails nunca aparecem em tamanho real num feed. A página inicial no computador mostra por volta de 360px de largura, e o feed de recomendações do celular costuma dar uns 168px. Reduzi o mesmo thumbnail do YouTube para esses três tamanhos e coloquei lado a lado. Em 360px os objetos e a expressão ainda se leem. Em 168px sobra apenas uma mancha de cor e uma silhueta humana.
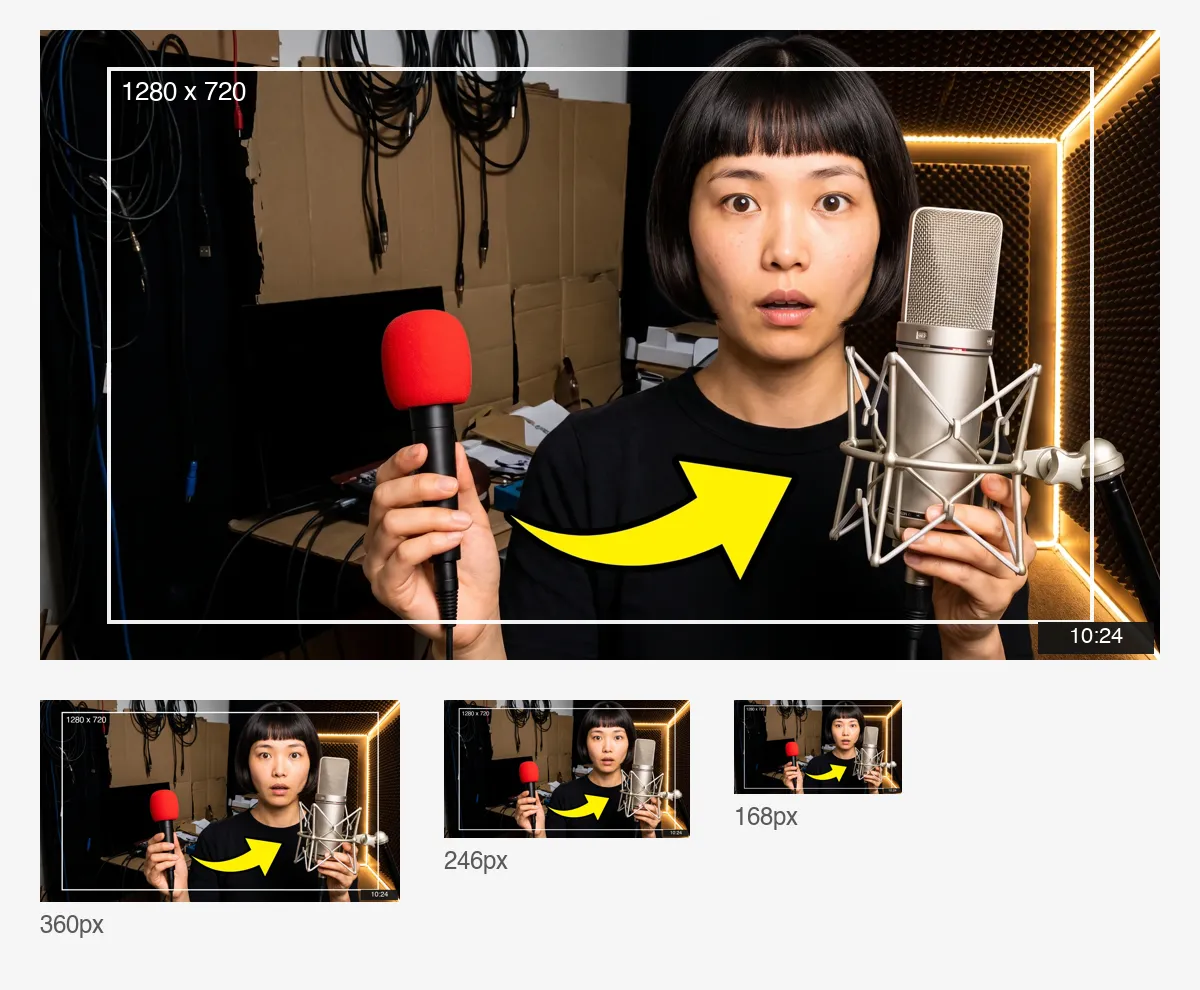
Então defini duas regras antes de gerar qualquer coisa. Manter a pessoa e tudo que importa dentro de uma área segura central com 6% de margem nos quatro lados, e deixar o canto inferior direito vazio. E reservar no quadro uma região limpa para sobrepor um título depois.
Comece por uma foto de teste: é o alicerce do conjunto
A parte mais difícil de todo o trabalho é que a pessoa dos oito thumbnails precisa ser a mesma.
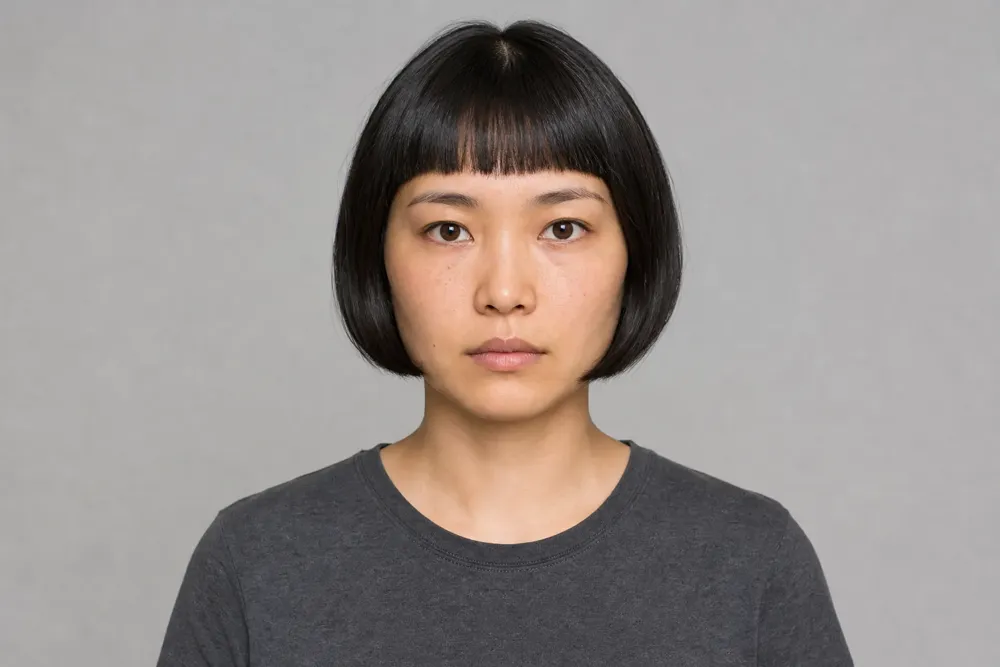
Meu caminho foi produzir primeiro um quadro de referência limpo com geração de imagens por IA: de frente, na altura dos olhos, sem maquiagem, sem expressão, fundo cinza, luz chapada e uniforme, como uma foto de teste de elenco. Essa imagem não tem graça nenhuma e nunca foi feita para ser publicada. O único papel dela é servir de referência para todos os quadros seguintes.
E aqui entra o erro.
Na primeira leva eu também travei a composição. Pessoa no terço esquerdo, contorno branco recortado em volta dela, um estouro de raios atrás da cabeça, um bloco chapado de cor preenchendo a metade direita. A única coisa que podia mudar era a expressão e a cor de fundo. Oito imagens depois o rosto não tinha variado nada, e o conjunto parecia uma tabela de emoções em vez de oito thumbnails. Outra cara, outra cor, e só.
O motivo é simples. Um thumbnail de verdade é desenhado em torno do assunto do vídeo, e a única variável que eu tinha dado ao modelo era uma expressão facial. Não havia nada para projetar, então ele repetiu meu gabarito oito vezes.
A correção foi devolver o projeto para ele. O bloco fixo agora trava só o que precisa ser travado: a mesma pessoa, rosto iluminado e desobstruído, tronco no quadro. Cenário, objetos de cena, elementos gráficos, paleta, luz, profundidade e enquadramento passaram a ser decisão do modelo. O bloco variável virou uma única frase: sobre o que é este vídeo.
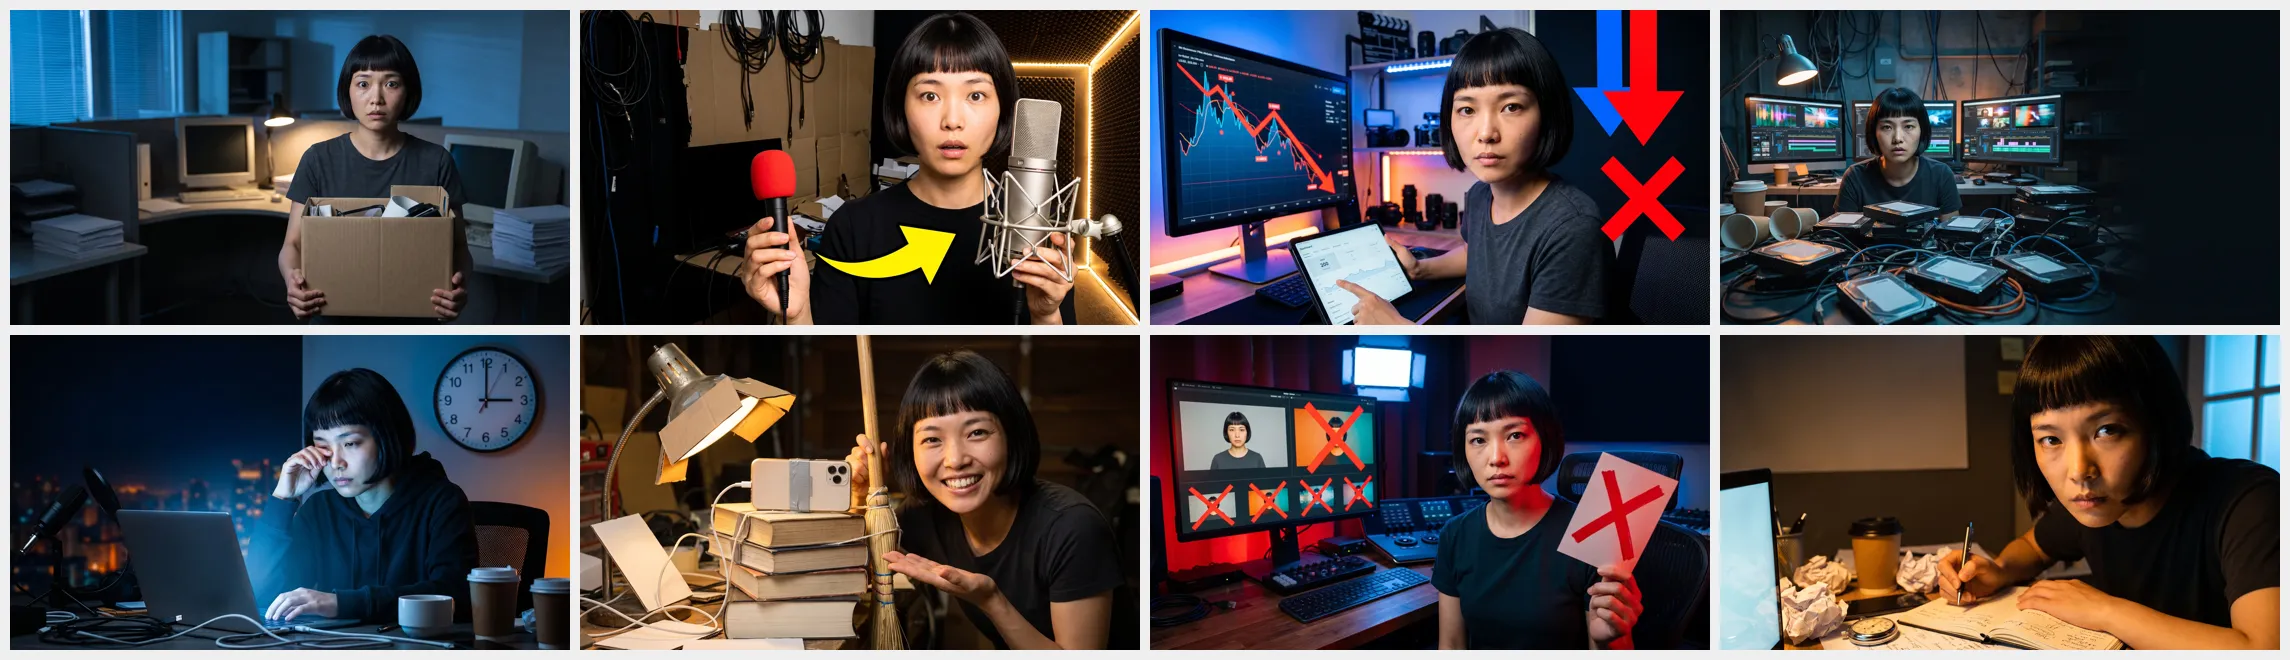
As oito variáveis foram: largar o emprego, um microfone de trinta reais que ganha de um de trezentos, estar travado em duzentas visualizações, editar cem vídeos numa semana, publicar às três da manhã por um mês, um setup de gravação inteiro mais barato que um celular, cinco presets de cor que todo mundo deveria parar de usar, e escrever um roteiro em doze minutos.
O que voltou não joga na mesma liga da primeira leva. Uma seta amarela entre um microfone de mão vermelho e um condensador. Uma linha vermelha despencando num monitor com um X vermelho ao lado. Uma fileira de miniaturas de presets riscadas uma a uma. Um relógio de parede contra a cidade noturna às três da manhã. Nada dessa linguagem gráfica estava no meu comando: o modelo de imagens por IA inventou tudo.
Eu achava que ele não escrevia. Escreve.
Circula muito um conselho sobre geração de imagens por IA: os modelos não conseguem escrever texto legível, então qualquer letra na saída sai embaralhada. Eu seguia isso, e todo comando terminava com uma instrução para manter texto fora do quadro.
No fim testei e pedi ao modelo para escrever o título direto na região livre.
Escreveu certo. Nenhuma letra errada, formas limpas, peso coerente, quebras de linha sensatas em três linhas. Essa regra antiga já não se sustenta muito bem com os modelos de imagens por IA de hoje.
Mesmo assim não mudei de ideia, porque o segundo teste expôs o problema real. Troquei 200 por 500 no título, sem mexer em nenhuma outra palavra, e rodei de novo. O texto continuou correto, mas o quadro inteiro tinha sido remontado: ela sai de sentada de perfil para enquadrada de frente no centro, o monitor sai do canto esquerdo para logo atrás dela, e a tipografia muda de tamanho e posição junto. Lado a lado, as duas não pertencem ao mesmo conjunto.
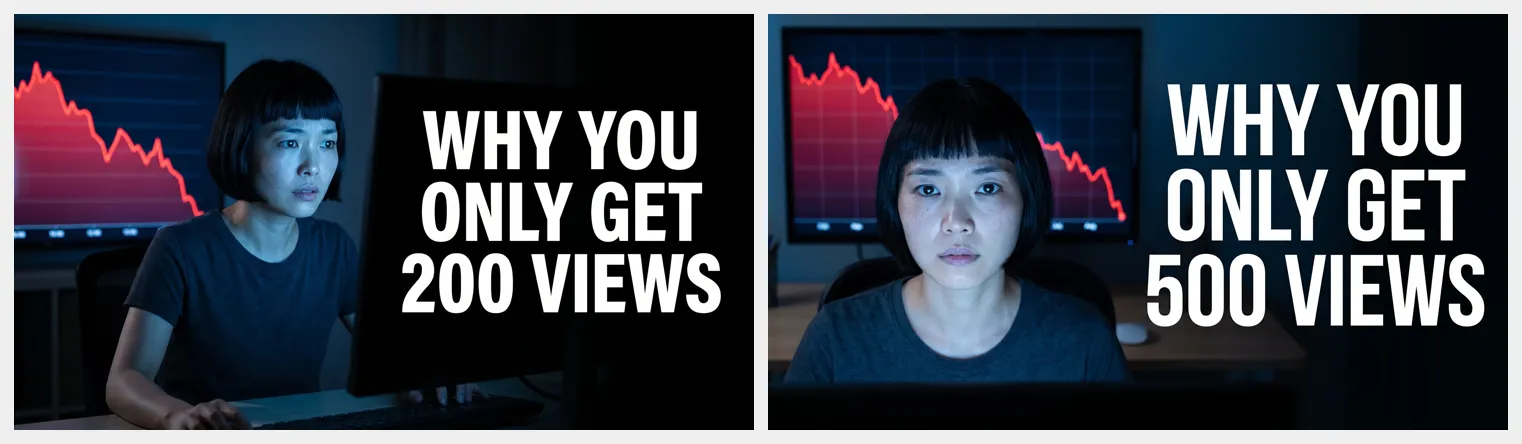
A conclusão continua de pé, mas por outro motivo. O problema não é que ele não saiba escrever, é que o layout não é reproduzível. Se você vai fazer um conjunto inteiro de thumbnails do YouTube e pretende trocar títulos ou testar em A/B depois, mantenha o texto fora da imagem e sobreponha à parte. Para uma peça única em que você nunca vai mexer, deixar o modelo escrever economiza uma etapa.
As quatro que joguei fora
Entregar a direção de arte para um modelo de imagens por IA tem um custo: ele coloca no quadro, sem cerimônia, coisas que você nunca pediu. Quatro refações, três falhas distintas.
Marcas reais. Na imagem de largar o emprego, ele colocou na mão dela um microfone com o nome de um fabricante real impresso na lateral. Na das cem edições, pôs sobre a mesa duas latas de energético reconhecíveis na hora. Nenhuma das duas cabe numa imagem que você vai publicar.
Pessoa duplicada. Acrescentei uma cláusula proibindo marcas e rodei de novo a imagem de largar o emprego: apareceram duas versões dela, uma digitando numa mesa e outra em pé ao lado segurando uma caixa de papelão. O modelo leu "sair do escritório" como uma cena que precisa de duas atrizes.
Texto nos objetos de cena. Na imagem do setup barato, ele escreveu caprichadamente duas palavras em inglês na caixa de papelão. Essa é a falha que mais importa aqui: estas imagens são compartilhadas entre 21 idiomas, então texto em um idioma só vira ruído para os leitores dos outros vinte.
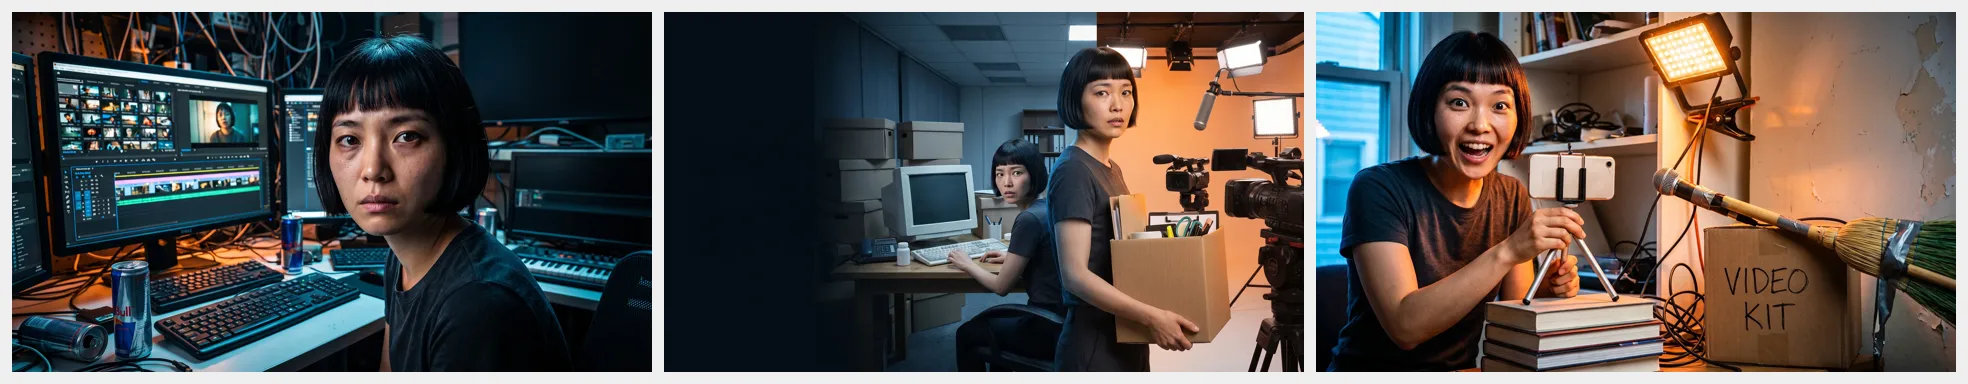
As três viraram cláusulas do bloco fixo, e precisam ser específicas. "Sem texto" não basta: tem que dizer sem letras em telas, embalagens, etiquetas, equipamentos ou placas. "Uma pessoa só" também não basta; é preciso excluir uma segunda versão dela, um reflexo e um retrato dela ao fundo.
Uma estrutura de comando para copiar
O bloco fixo é colado sem alteração em todo comando, e diz mais ou menos isto.
Use a mesma pessoa da imagem de referência, mesmo cabelo. Ela precisa ser reconhecível na hora como a mesma pessoa, com o rosto iluminado, desobstruído e mais ou menos voltado para a câmera, tronco no quadro. Você é o diretor de arte projetando um thumbnail do YouTube que precisa conquistar um clique a 168 pixels de largura — tudo além da identidade dela é decisão sua: cenário, objetos de cena, elementos gráficos, paleta, luz, profundidade e enquadramento. Faça ousado, de alto contraste e específico para este assunto, não um retrato sobre fundo colorido. Reserve no quadro uma região limpa para um título acrescentado depois. Nenhum texto, letra ou número em lugar nenhum, inclusive em telas, embalagens, etiquetas, equipamentos ou placas. Nenhum logotipo de marca ou marca registrada reconhecível; todos os objetos sem marcação. Exatamente uma pessoa no quadro.
O bloco variável é uma frase: sobre o que é este vídeo.
Essas três últimas proibições foram todas acrescentadas depois de uma refação, uma cláusula por falha. A estrutura passa sem alteração para outros modelos de imagens por IA; muda só o jeito de redigir.
Um thumbnail, dois usos
Com os oito fechados, as imagens geradas por IA ainda tinham um serviço a prestar. Peguei a das três da manhã como quadro inicial e usei geração de vídeo por primeiro e último quadro para produzir uma vinheta de cinco segundos.
Aqui também há uma armadilha de verdade. O trecho gerado reenquadrou a cena, e a região limpa que eu tinha reservado com cuidado para o título foi quase toda devorada. Para uma vinheta, tudo bem. Para um card de encerramento, seria preciso diagramar de novo.
Para rodar um lote inteiro de uma vez, espalhar os oito trabalhos de imagens por IA pela tela generativa funciona melhor do que ir um a um: você vê de relance o que manter e o que refazer. Se preferir não escrever os comandos do zero, em modelos há estilos de retrato prontos para aplicar.
Oito finais numa tarde
O conjunto inteiro de thumbnails do YouTube levou uma tarde do primeiro envio aos oito quadros fechados, com quatro descartados. O demorado não foi gerar nem retocar, e sim descobrir o que entregar ao modelo: no começo eu segurei demais, preguei a composição e recebi oito imagens todas parecidas.
Se quiser reproduzir, a ordem é: meça a área segura e os três tamanhos reais de exibição, gere um quadro de referência sem graça mas limpo, reduza o bloco fixo à pessoa mais aquelas poucas proibições, e trate o assunto de cada imagem como a única variável. Sobre o texto: acrescente depois se for um conjunto, deixe o modelo escrever se for peça única.
O conjunto inteiro de thumbnails do YouTube usou exatamente duas ferramentas de imagens por IA, geração de imagens por IA e edição de imagens por IA.