Avatares que falam
Um retrato mais uma faixa de voz viram um vídeo de apresentador — sem tempo diante da câmera, sem filmagem.
Entregue um áudio e um rosto, e a pessoa na tela diz exatamente aquilo — com os movimentos de boca alinhados. É a ferramenta por trás de avatares que falam, dublagem e versões em outros idiomas.
Sem necessidade de filmagem — uma foto ou um clipe mais o áudio já entregam a cena daquela pessoa dizendo o texto.
O modelo se alinha às sílabas do áudio, o que é muito mais confiável do que pedir "falando" a um modelo de vídeo, que normalmente só devolve uma boca se mexendo.
Coloque uma faixa em outro idioma sob o mesmo material e a boca acompanha o novo idioma — sem nova filmagem para as versões internacionais.
Alguns são mais fortes em transformar uma foto parada em um clipe falando, outros em redublar vídeo já existente. Rode os mesmos arquivos em outro modelo.
Um retrato mais uma faixa de voz viram um vídeo de apresentador — sem tempo diante da câmera, sem filmagem.
Coloque uma nova faixa de voz sob um vídeo existente; a boca se realinha e a imagem fica intocada.
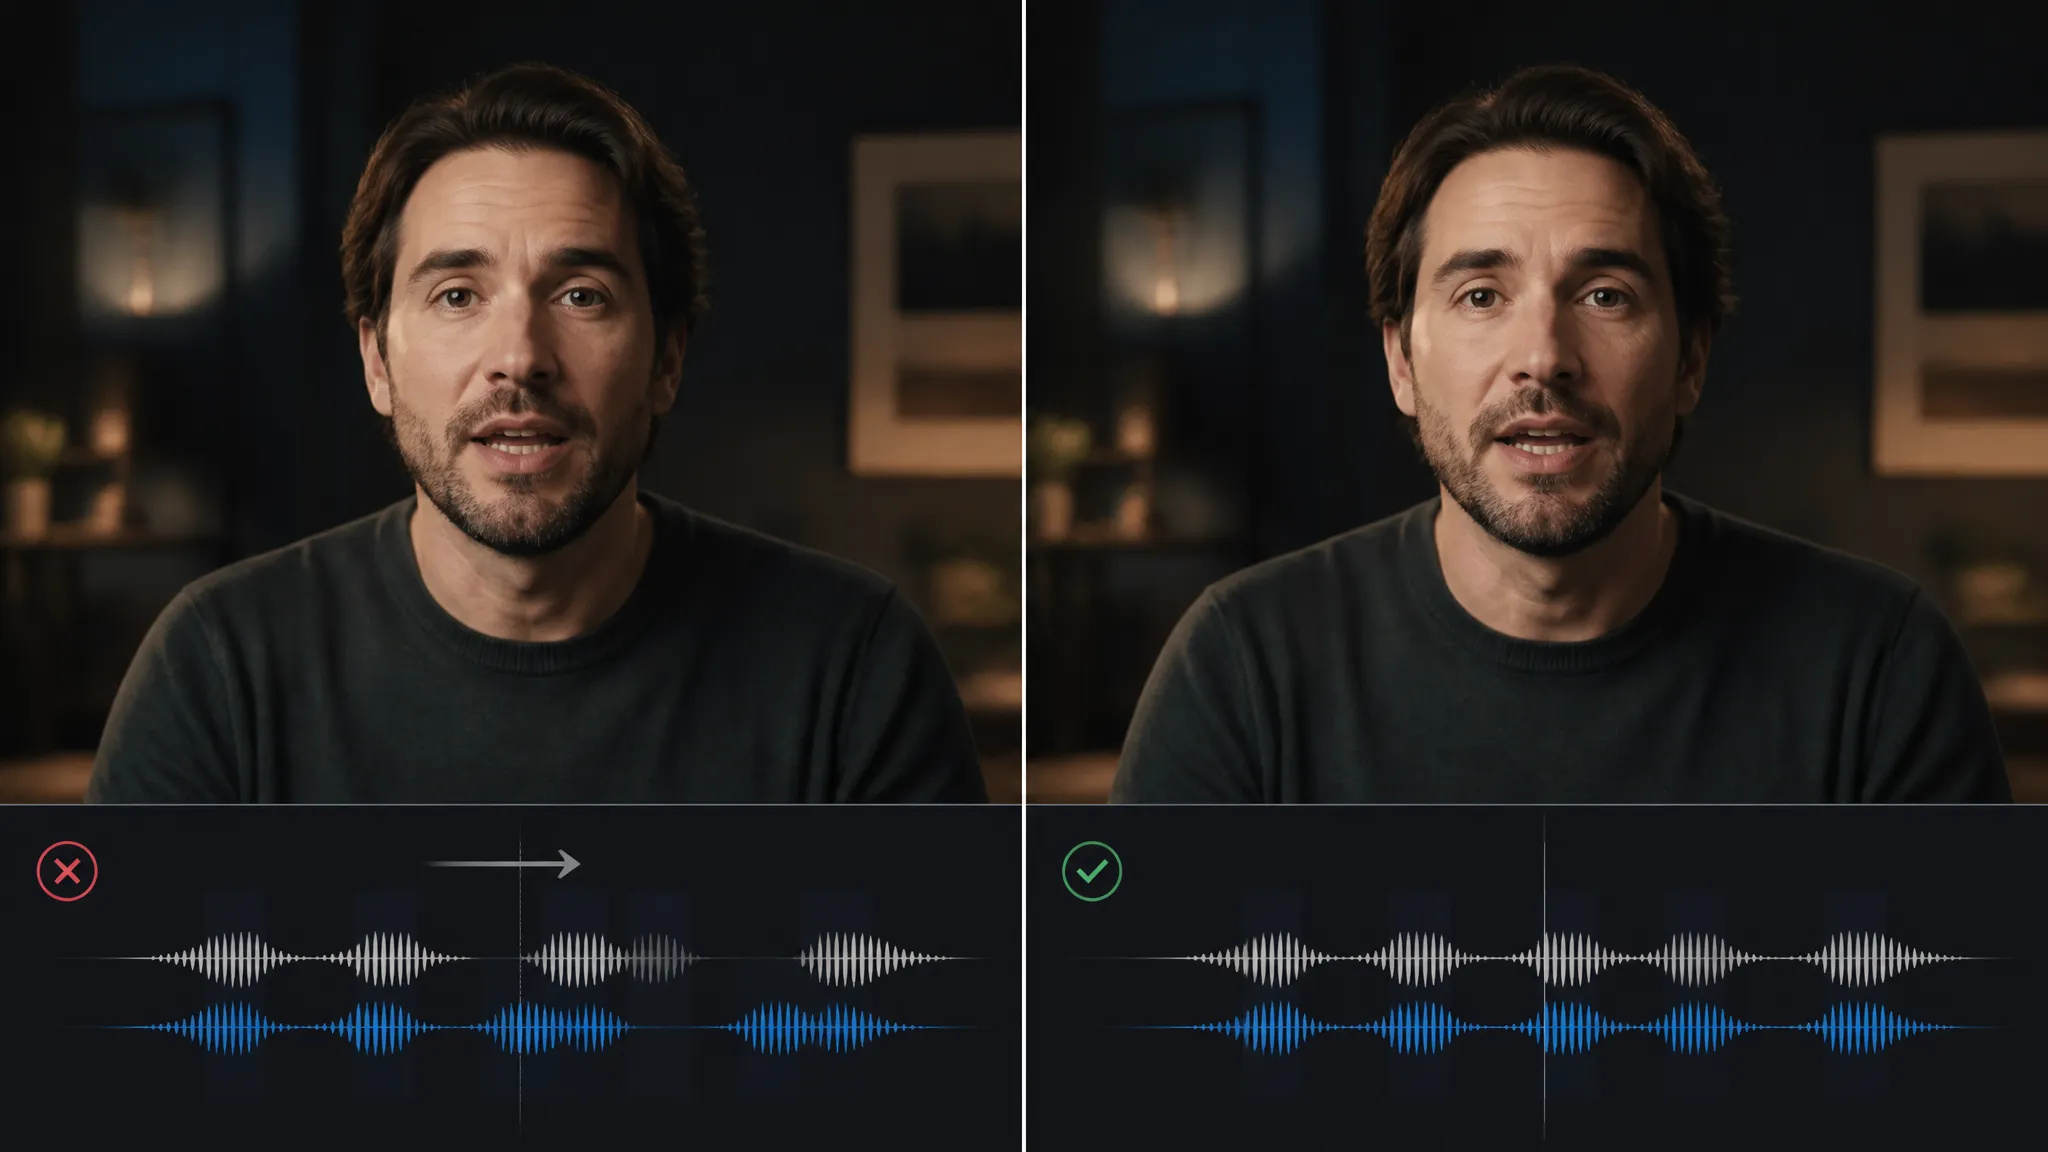
Quando a boca de um clipe gerado por IA não bate com a fala, realinhe aqui.
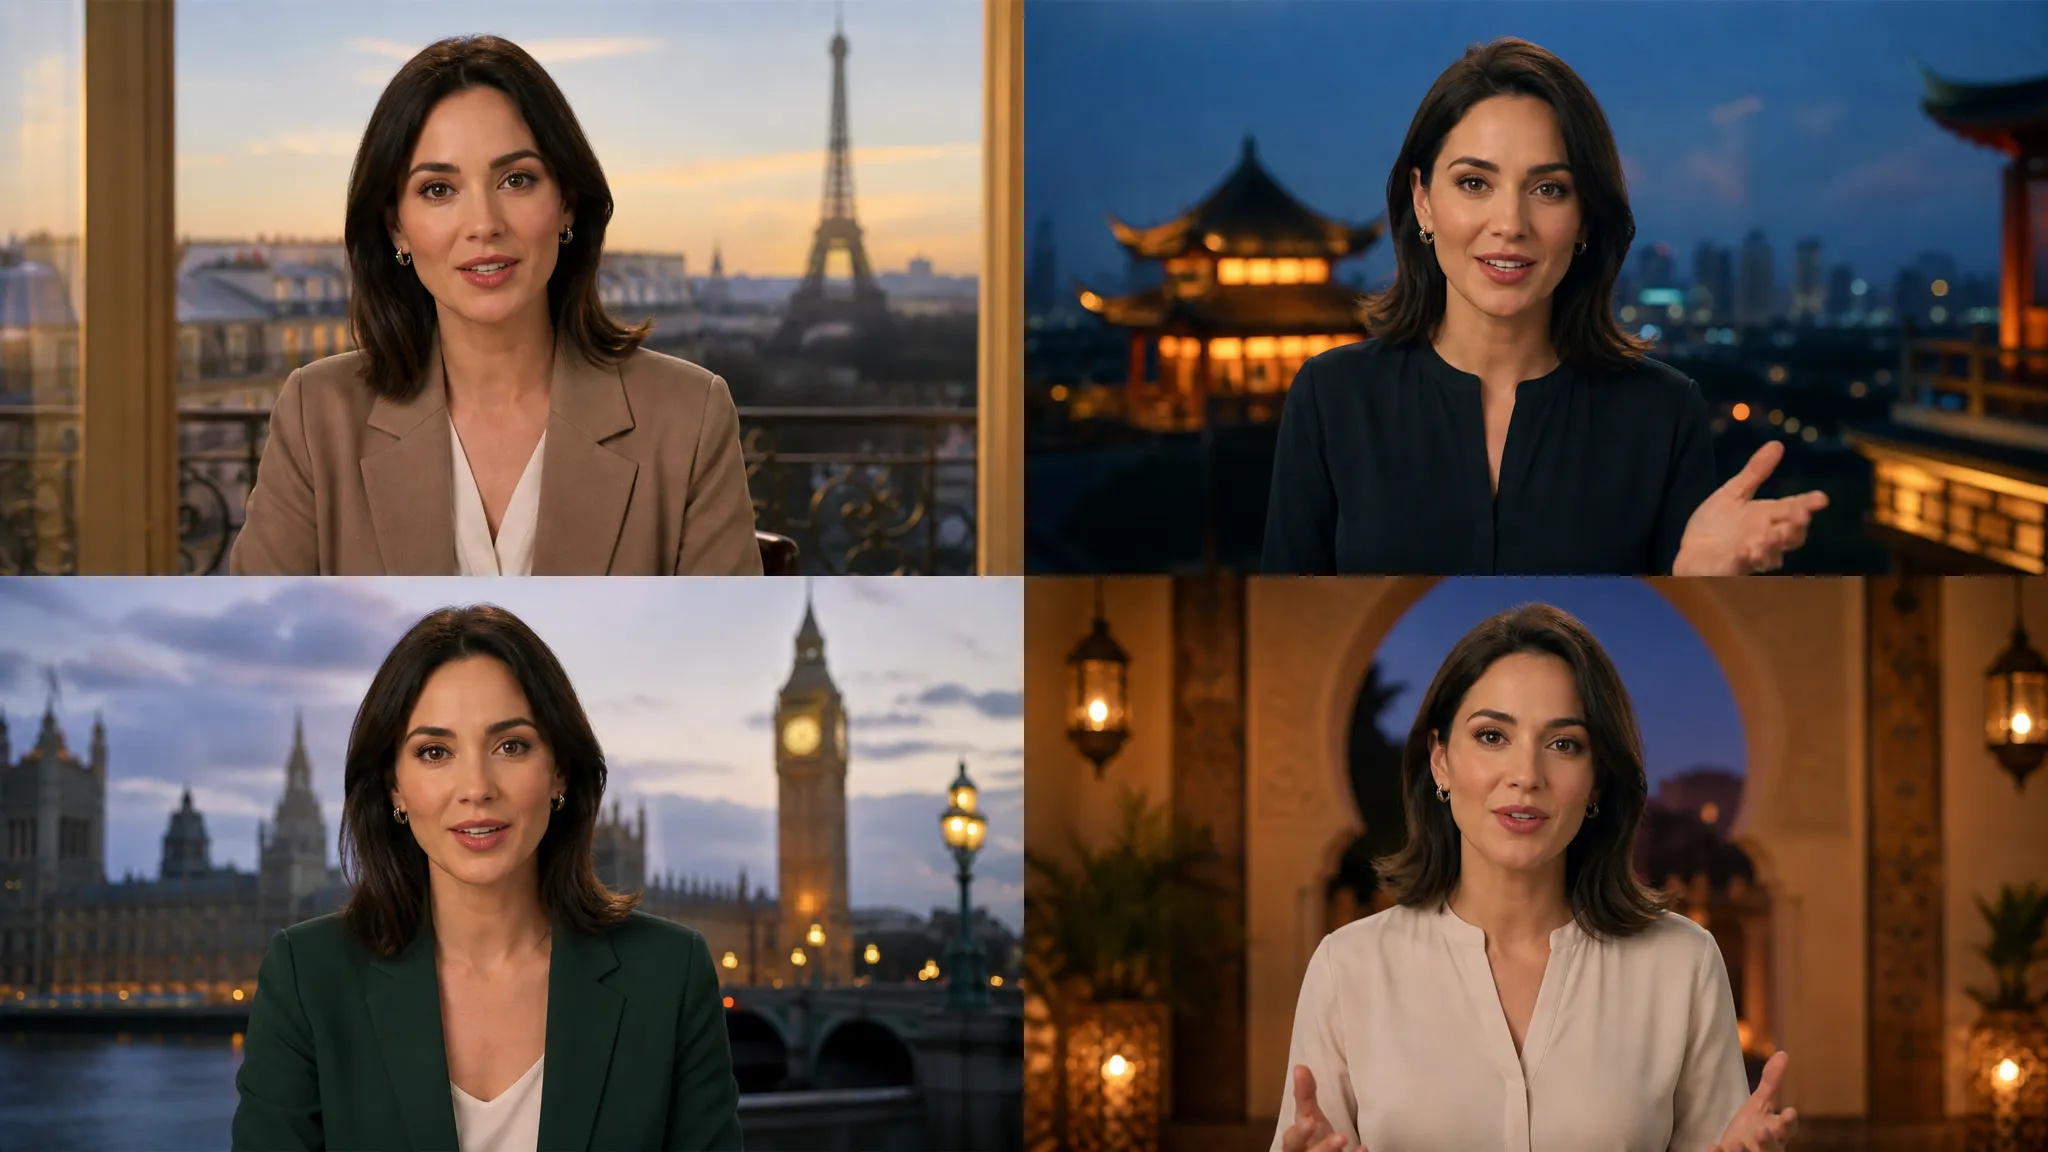
Uma pessoa falando vários idiomas, para que a versão de cada mercado pareça mesmo ela dizendo aquilo.
Abra a Sincronia Labial com IA e envie um rosto — uma foto ou um clipe de vídeo.
Envie o áudio a ser falado; ele pode vir do texto para fala ou da clonagem de voz.
Baixe o resultado ou mande para a tela para continuar montando.
Pedir "esta pessoa está falando" a um gerador de vídeo normalmente produz uma boca se mexendo cujo movimento não tem nada a ver com a sua fala. O modelo só sabe que deve haver fala, não o que está sendo dito.
A sincronia labial segue o outro caminho: ela sustenta um áudio real e alinha os formatos de boca sílaba por sílaba. Assim a pessoa diz a fala que você entregou, em vez de encenar um movimento genérico de boca.
Essa etapa costuma ser o último elo de uma corrente — escrever o roteiro, gerar a voz e então fazer a pessoa dizê-la.
Exige-se muito pouco: um rosto e uma faixa de áudio. Mas a qualidade do rosto conduz o resultado diretamente:
Do lado do áudio, os três caminhos funcionam: texto para fala (o mais rápido — escreva e escolha uma voz), clonagem de voz (quando você precisa de uma voz específica) ou a sua própria gravação.
Encare isto como a etapa de montagem: acerte primeiro o áudio (é ele que define a qualidade percebida — uma leitura ruim não é salva por um alinhamento de boca perfeito), prepare o rosto e depois combine os dois.
Uma ordem que vale internalizar: feche o áudio antes de rodar a sincronia labial. O caminho inverso obriga a recompor o vídeo a cada mudança de roteiro, o que custa muito mais do que gerar de novo uma faixa de voz.
Dois: um rosto nítido e de frente (foto ou vídeo) e uma faixa de áudio. O rosto deve estar frontal, com as feições visíveis e a boca desobstruída — ângulos de perfil, máscaras e luz muito fraca degradam bastante o alinhamento.
Gere no texto para fala — escreva o roteiro, escolha uma voz, pronto. Para uma voz específica, crie antes na clonagem de voz. Você também pode enviar um áudio gravado por você mesmo. Os três caminhos funcionam aqui.
Porque isso devolve uma boca se mexendo cujo movimento não tem nada a ver com a sua fala. A sincronia labial se alinha a um áudio real, sílaba por sílaba, então a boca corresponde a palavras de verdade. Quando a pessoa precisa dizer algo específico, esta é a página.
Funciona, com alguma variação de precisão conforme o modelo e o idioma. Inglês e chinês em geral alinham muito bem. Se um resultado decepcionar, rode os mesmos arquivos em outro modelo — isso costuma resolver.
Prompt*
Imagem*
Audio*