كيف تصنع فيديو Deep Down in My Heart بالذكاء الاصطناعي من صورتين
يجلس شخص على أريكة ويقول بصدق: «Deep down in my heart… I still love you». يتجمد الشخص الذي بجانبه في مكانه. تمتلئ عيناه بالدموع، وتنهار ملامحه، وفجأة يغطي وجهه وينخرط في البكاء. أما الشخص الذي اعترف بحبه فيبدو أكثر ارتباكًا، ولا يعرف ماذا يفعل بيديه.
هذا التحول العاطفي هو ما يجذب الانتباه في مقابلة Deep Down in My Heart الثنائية. مع قالب Deep Down In My Heart Duo من ZOOOP، تكفي صورتان لإنشاء فيديو ثنائي بالذكاء الاصطناعي خاص بك. لا تحتاج إلى كتابة أوامر نصية أو إلى المونتاج اليدوي.
ما هو اتجاه Deep Down in My Heart؟
يدور هذا النمط حول التباين بين شخصين في مقابلة. أحدهما صادق تمامًا، والآخر غير مستعد للاعتراف فيفقد السيطرة على مشاعره. تنتقل الكاميرا بين اللقطة التي تجمعهما ولقطة قريبة للشخص الباكي، فينتقل المشاهد خلال ثوانٍ من اعتراف هادئ إلى نوبة بكاء مبالغ فيها.
ما زال هذا الاتجاه في مرحلة مبكرة، وقد بدأت تظهر نسخ بأشخاص حقيقيين. وهو مناسب للأصدقاء والأزواج والإخوة والثنائيات العائلية الخيالية. يمكنك استخدام صور حقيقية، لكن المقابلة نفسها مولّدة بالذكاء الاصطناعي. وضّح ذلك عند نشرها، خصوصًا إذا كان من الممكن الخلط بين الثنائي ومحادثة حقيقية.
ماذا يتضمن هذا الفيديو الثنائي بالذكاء الاصطناعي؟
يغطي القالب اللحظات الأساسية: شخصان يجلسان جنبًا إلى جنب، واعتراف بالحب، ورد فعل عاطفي يتصاعد، ثم محاولة مرتبكة من الشخص الآخر للمواساة. يحتفظ كل شخص بوجهه وعمره وتسريحة شعره وملابسه. ولا تتبادل الشخصيتان الأدوار في منتصف الفيديو.
الناتج الافتراضي عمودي ويتضمن الصوت. الشخص الموجود في الصورة الأولى يبكي، بينما يقول الشخص في الصورة الثانية «I still love you». لذلك، عند إنشاء هذا الفيديو الثنائي بالذكاء الاصطناعي، يكون أهم قرار في توزيع الأدوار هو اختيار من سيبكي.
يمكن أن تُظهر الصورتان صديقين أو زوجين أو شخصًا بالغًا شابًا وآخر أكبر سنًا. الأشخاص في هذا المقال أمثلة خيالية، مما يسهّل رؤية كيف تظهر الأعمار والملامح المختلفة في المشهد النهائي.
كيف تختار صورتين
استخدم شخصًا واحدًا في كل صورة. في الصورة الجماعية، سيضطر القالب إلى تخمين الوجه الذي تريده. تُعد الصورة الشخصية الأمامية التي تظهر نصف الجسم الخيار الأسهل، مع إضاءة متساوية ومن دون أيدٍ أو شعر يحجب العينين.
اجعل صاحب الدور العاطفي في الصورة 1. يتجمد هذا الشخص، ثم تدمع عيناه، وأخيرًا يغطي وجهه أثناء البكاء. لا بأس بزاوية بسيطة، لكن وضوح ملامح الوجه يجعل تغير التعبير أسهل في القراءة.
ضع الشخص الذي يعترف بالحب في الصورة 2. تصلح الملابس اليومية، ولا حاجة إلى أناقة مبالغ فيها. وتشابه الإضاءة وجودة الصورة في الصورتين يساعد على جعل الشخصين يبدوان وكأنهما في الغرفة نفسها.
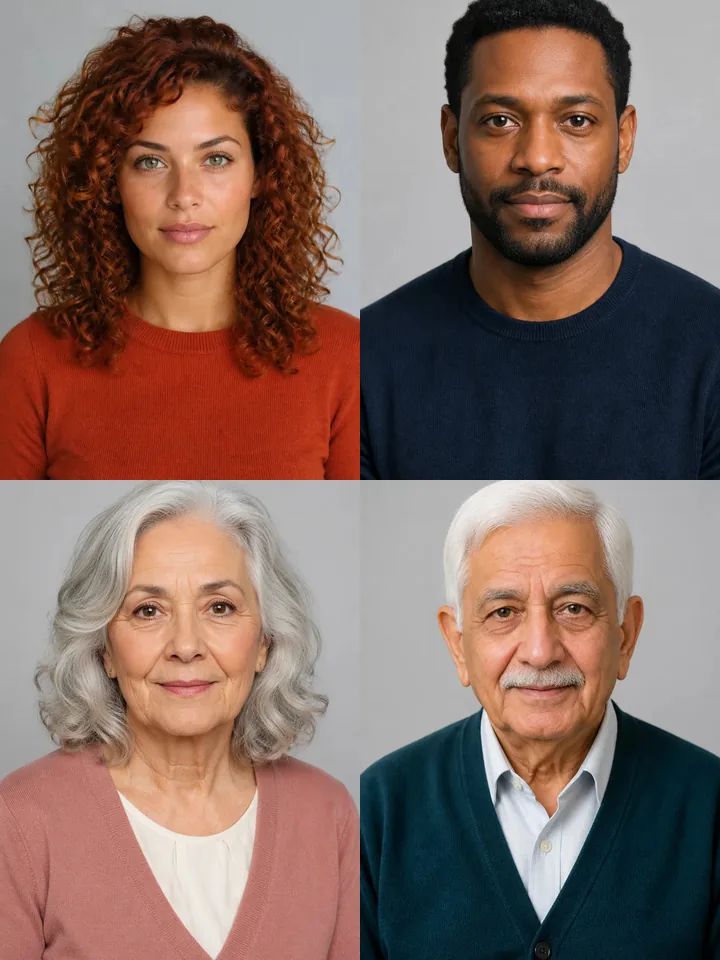
إذا انتهت الصورة عند الكتفين، فسيُتخيل باقي الزي. استخدم صورة تُظهر الجزء العلوي من الجسم حتى الخصر عندما يكون قميص أو سترة معينة مهمًا. ولا تستخدم إلا صور بالغين وافقوا على الظهور في عملك.
أنشئ فيديو Deep Down in My Heart باستخدام ZOOOP
- افتح صفحة القالب. ارفع صورة الشخص الباكي بوصفها الصورة 1، وصورة الشخص الذي يعترف بالحب بوصفها الصورة 2.
- احتفظ بدقة 480p الافتراضية، أو اختر 720p للحصول على نتيجة أوضح.
- أرسل المهمة، وانتظر اكتمال الإنشاء، ثم نزّل الفيديو النهائي.
إعداد المقابلة والإيقاع العاطفي جاهزان مسبقًا. لست بحاجة إلى إعداد قائمة لقطات. لإنشاء فيديو ثنائي آخر بالذكاء الاصطناعي، ارفع زوجًا مختلفًا من صورتين أو بدّل ترتيبهما ليصبح الشخص الذي اعترف سابقًا هو من يبكي.
النسختان الشابة والأكبر سنًا: ما الذي تغيّر؟
في النسخة الشابة، تغطي المرأة ذات الشعر المجعد وجهها وتبكي، بينما ينتقل الرجل من الاعتراف الصادق إلى ارتباك واضح. تنتقل الملابس من الصور المدخلة، وتجعل لقطات رد الفعل القصيرة المشهد سهل المشاركة في محادثة جماعية أو على منصة فيديوهات قصيرة.
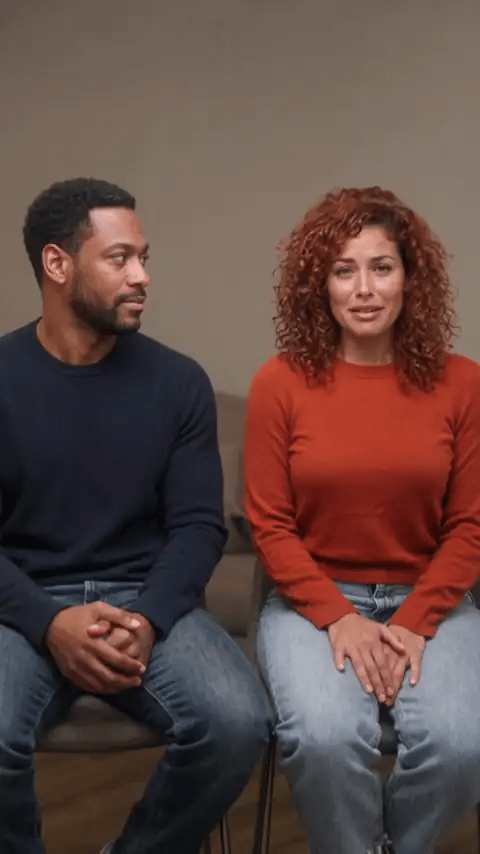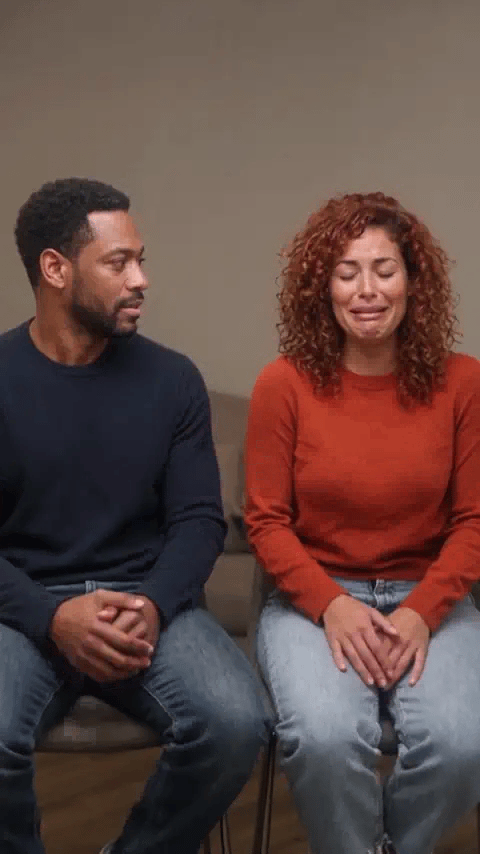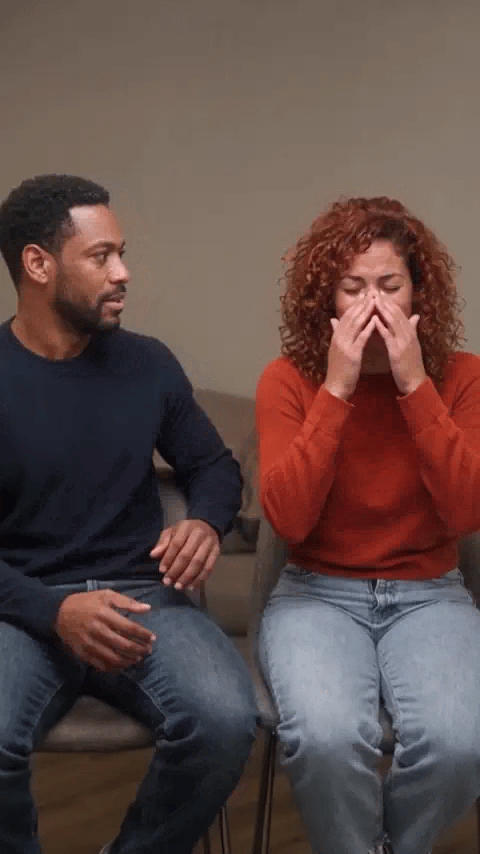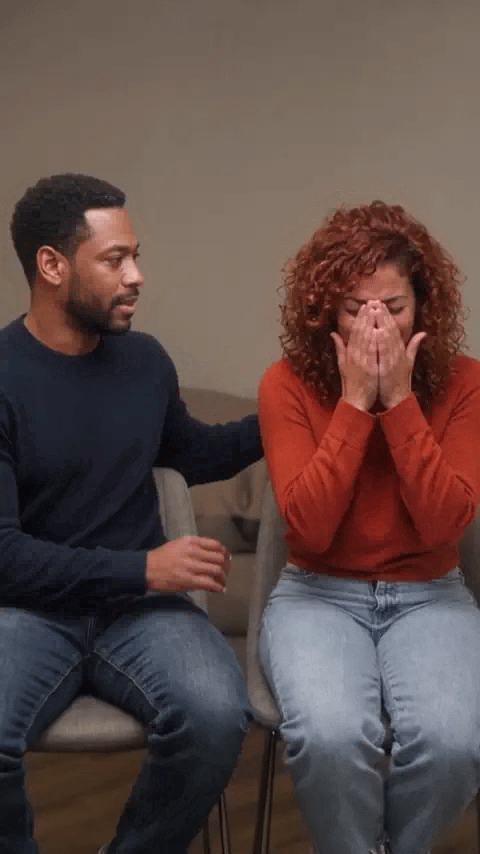
تترك النسخة الأكبر سنًا انطباعًا مختلفًا قليلًا. يتحدث الرجل بصوت هادئ وجاد، بينما تنتقل المرأة من عينين دامعتين إلى تغطية وجهها. يضفي عمرهما على عبارة «I still love you» لمحة من لمّ شمل طال انتظاره. إنه نمط الفيديو الثنائي نفسه بالذكاء الاصطناعي، لكن تغيير الشخصيات يغيّر النبرة العاطفية.
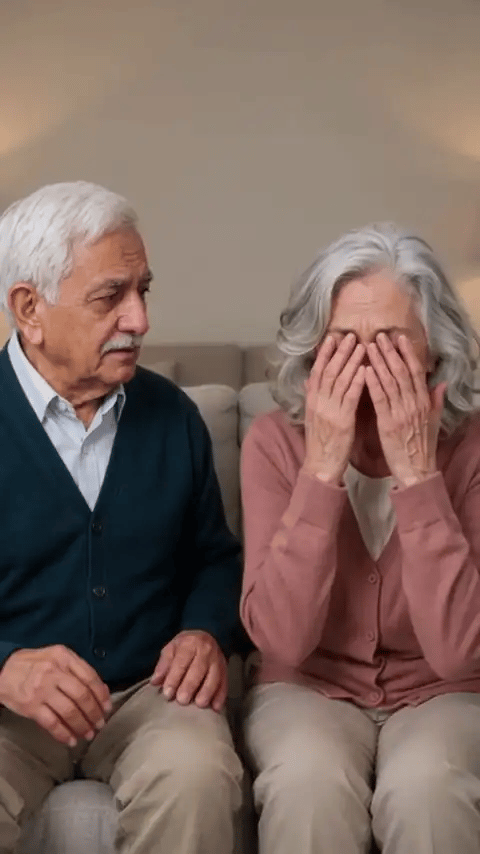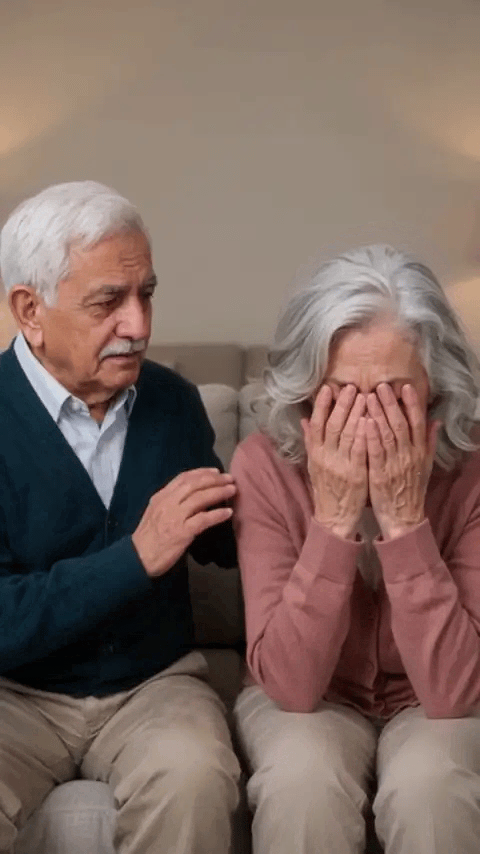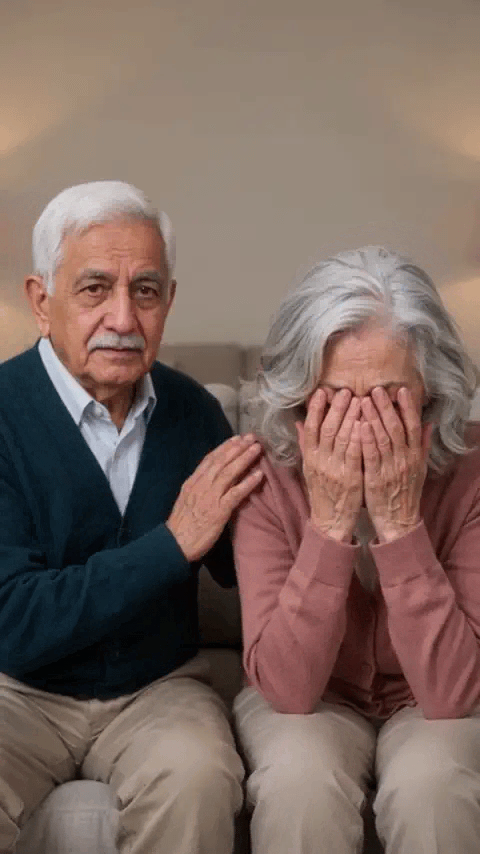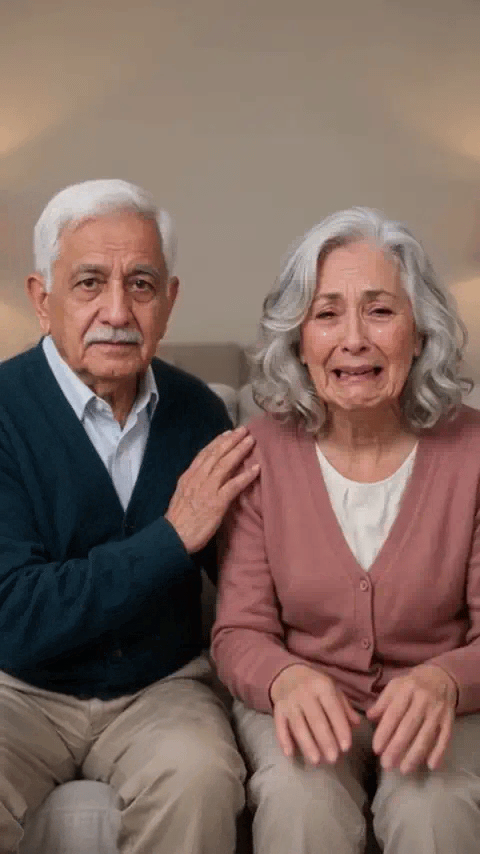
تعرض هذه الرسوم المتحركة داخل المقال الصور فقط. أما مقاطع الفيديو التي تنزّلها فتتضمن الصوت.
أخطاء شائعة يجب تجنبها
عكس الأدوار. إذا بكى الشخص الخطأ، فمن المرجح أنك عكست الصورتين 1 و2. بدّلهما وأعد الإنشاء.
إخفاء جزء كبير من الوجه. الزوايا الجانبية الحادة والنظارات الشمسية والإضاءة الخلفية والأيدي على الوجه تقلل التفاصيل المفيدة. تصلح الصور العادية، لكن تجنب اللقطات التي لا يشغل فيها كل شخص سوى جزء صغير جدًا من الإطار.
توقع تطابق كل بكسل. الهدف هو شخص يمكن التعرف عليه، لا نسخة مطابقة للصورة الأصلية. قد تتغير تفاصيل الوجه الدقيقة أكثر أثناء التعبير الشديد مقارنة بلقطة هادئة. عادةً ما تكون الصورة الأوضح أكثر فائدة من تغيير المشهد بشكل متكرر.
تقديم مقابلة خيالية على أنها حقيقية. المقطع المرح بين الأصدقاء شيء، والنشر العام شيء آخر. على المنصات العامة، ضع علامة توضح أنه مولّد بالذكاء الاصطناعي، وتجنب اختلاق علاقات أو قصص شخصية قد تضلل المشاهدين بشأن أشخاص حقيقيين.
ماذا تجرب بعد ذلك؟
بعد إنشاء هذا الفيديو الثنائي بالذكاء الاصطناعي، يمكن للشخصيتين نفسيهما الظهور في عمل آخر، ولا يلزم استخدام الصورتين مرة واحدة فقط. جرّب التحكم في الحركة لمنح شخص في صورة أداءً مختلفًا، أو استخدم مزامنة الشفاه لحوار تكتبه بنفسك. تنتظرك أفكار أخرى لفيديوهات ثنائية وفردية بالذكاء الاصطناعي في مكتبة قوالب ZOOOP.
في أول فيديو ثنائي بالذكاء الاصطناعي، ابدأ بزوج بسيط من صورتين: إضاءة متشابهة وملابس بسيطة ووجوه غير محجوبة. يسهّل ذلك تقييم توزيع الأدوار وترتيب الصور. عند تجربة عمر أو ثنائي مختلف، غيّر متغيرًا واحدًا في كل مرة.
اختر الشخصين والصورتين، وافتح Deep Down In My Heart Duo، ثم نزّل الفيديو الثنائي بالذكاء الاصطناعي عند اكتمال إنشائه. أنت من يقرر من يقول «I still love you» ومن يبكي.