Grok Imagine Image 2.0 Low kontra Medium: test tekstu i edycji
Recenzja Grok Imagine 2.0: Low i Medium kontra pierwszy Grok Imagine i GPT Image 2.6 na plakatach, opakowaniach, menu, portretach, edycji 3 zdjęć i czasie.
7 sierpnia xAI wypuścił Grok Imagine Image 2.0. Oficjalna zapowiedź składa kilka obietnic: model trzyma się promptu aż do szczegółów, składa tekst jak projektant, zachowuje czytelność drobnego tekstu i przy edycji trzyma się tego, co mu dasz. Od 15 listopada możesz go używać także na ZOOOP.
ZOOOP miał już pierwszą generację Grok Imagine, więc chciałem odpowiedzieć na dwa pytania: co Grok Imagine 2.0 faktycznie robi lepiej i czy warto traktować Low i Medium jak dwa osobne narzędzia. Puściłem te same prompty obok siebie przez oba poziomy jakości 2.0, model pierwszej generacji i GPT Image 2.6. W skrócie: w tekście tym razem wszystkie cztery zremisowały. Grok Imagine Image 2.0 wychodzi na prowadzenie w edycjach, które zostawiają twój obiekt nienaruszony, w tym, że nie dodaje rzeczy, o które nie prosiłeś, i w układach, które wyglądają bliżej gotowego projektu.
Czym jest Grok Imagine Image 2.0 i czym różni się od pierwszej wersji
Grok Imagine Image 2.0 to model obrazów drugiej generacji od xAI. Na ZOOOP działa tak samo jak Grok Imagine pierwszej generacji: generuje prosto z promptu albo przyjmuje do 3 obrazów referencyjnych, żeby je edytować lub połączyć. Masz siedem proporcji obrazu, 16:9, 3:2, 4:3, 1:1, 3:4, 2:3 i 9:16, w 1K lub 2K. Pole promptu mieści do 8000 znaków, więc tekst, hierarchia i kolory zmieszczą się w jednym akapicie.
Najbardziej widoczna zmiana względem pierwszej wersji to nowy wybór między dwoma poziomami jakości, Low i Medium. Low kosztuje mniej niż Medium, choć oba plasują się w tańszej części modeli w narzędziu Generator obrazu na ZOOOP. Model pierwszej generacji nie został wycofany i pojawia się w każdym porównaniu poniżej.
Jak testowaliśmy
Cztery prompty, każdy puszczony raz na czterech modelach, wszystkie w 1K: Grok Imagine Image 2.0 na Low i na Medium, Grok Imagine pierwszej generacji oraz GPT Image 2.6 na Medium jako punkt odniesienia. Wybrałem prompty, które celują w obszary, gdzie według xAI poprawa jest największa:
- Plakat wieczoru jazzowego, 2:3. Nagłówek "MIDNIGHT TIDE", jedna linijka drobnego tekstu na dole, "Live at Harbor Hall · Friday 21 November · Doors 8 PM", w stylu sitodruku.
- Opakowanie herbaty w puszce, 1:1. Etykieta z napisem "CHAMOMILE CALM", pod nim linijka drobnego tekstu "Organic herbal infusion · 20 pyramid bags" i ręcznie rysowany rumianek.
- Portret uliczny, 3:4. Deszczowa Lizbona: kobieta po sześćdziesiątce ze srebrnymi lokami, w żółtym płaszczu przeciwdeszczowym, śmieje się pod markizą kawiarni.
- Menu na tablicy kredowej, 4:3. Nagłówek "TODAY'S BREWS", sześć napojów napisanych ręcznie, po jednym w linijce, każdy z małą ikoną. Ceny nie były częścią promptu.
Osobno zrobiłem kompozycję z trzech obrazów, tylko na 2.0 Medium i modelu pierwszej generacji.
Plakaty i opakowania: czy tekst naprawdę jest poprawny?
Najpierw wynik, którego się nie spodziewałem. Wszystkie cztery modele poprawnie napisały i nagłówek, i drobny tekst, łącznie z modelem pierwszej generacji. Dolna linijka z datą i godziną wyszła co do litery bezbłędnie na wszystkich czterech plakatach.
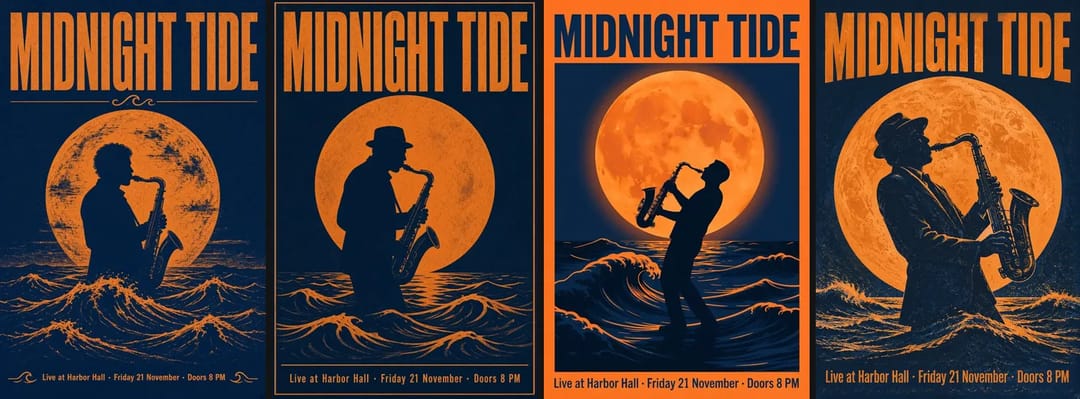
Od lewej do prawej: Grok Imagine Image 2.0 Low, 2.0 Medium, Grok Imagine pierwszej generacji, GPT Image 2.6.
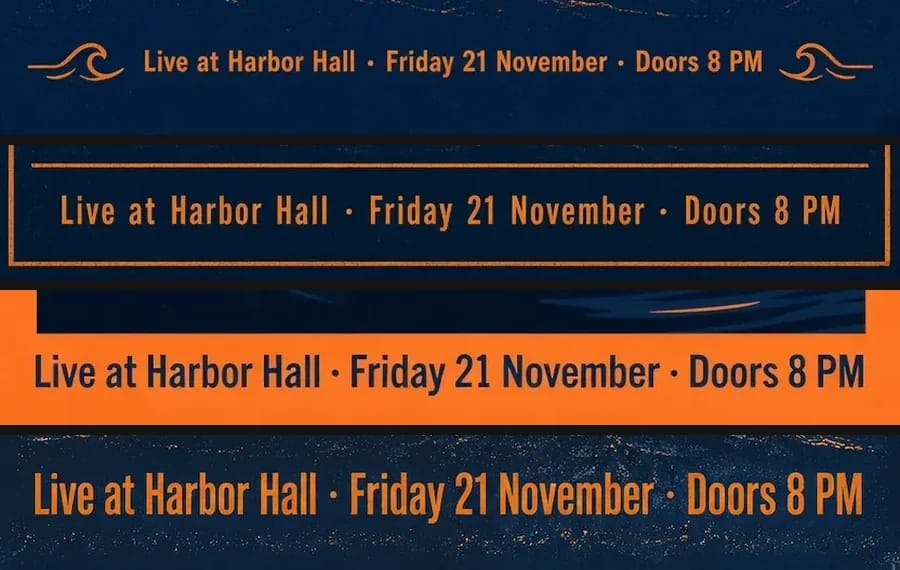
Od góry: 2.0 Low, 2.0 Medium, Grok Imagine pierwszej generacji, GPT Image 2.6.
Mówiąc więc szczerze: przy tak krótkim tekście ulepszenie "dokładniejszego tekstu" nie było widoczne. Drobny tekst jest ostry, ale model pierwszej generacji już radził sobie z linijką tej długości. Trudniejsze układy, jak cała strona instrukcji albo kilka kolumn drobnego druku, nie były częścią tego testu.
Różnica jest w układzie. Na wszystkich czterech plakatach jest księżyc, fale i sylwetka saksofonisty. 2.0 Low otacza drobny tekst małymi falistymi ozdobnikami. 2.0 Medium prowadzi cienką linię wokół całego plakatu i chowa w niej drobny tekst, więc całość wygląda jak plakat koncertowy, który naprawdę trafił do drukarni. Model pierwszej generacji zmniejsza grafikę do bloku na pomarańczowym tle, a kompozycja robi się bardziej płaska. GPT Image 2.6 ma ziarno, które najbardziej przypomina prawdziwy sitodruk.
Puszka z herbatą pokazuje większą różnicę.
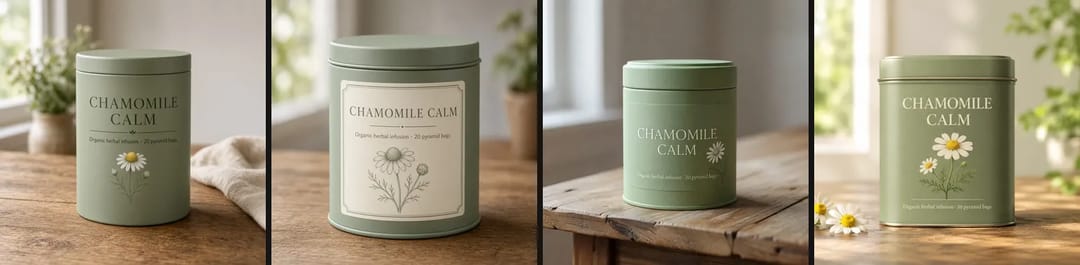
Od lewej do prawej: 2.0 Low, 2.0 Medium, Grok Imagine pierwszej generacji, GPT Image 2.6.
Grok Imagine Image 2.0 na Medium zamienił etykietę w naklejkę w kolorze złamanej bieli z cienką ramką i rumiankiem narysowanym kreską, a cała puszka wygląda jak coś, co można zdjąć ze sklepowej półki. Low drukuje słowa bezpośrednio na puszce. Hierarchia nadal jest czytelna i na prezentację pomysłu wystarczy. U modelu pierwszej generacji drobny tekst po powiększeniu trochę się rozmywa, choć pisownia jest poprawna.
Menu i portret: tu Low i Medium się rozchodzą
Menu na tablicy kredowej to jedyny raz, kiedy Grok Imagine Image 2.0 Low wyraźnie coś pomylił.
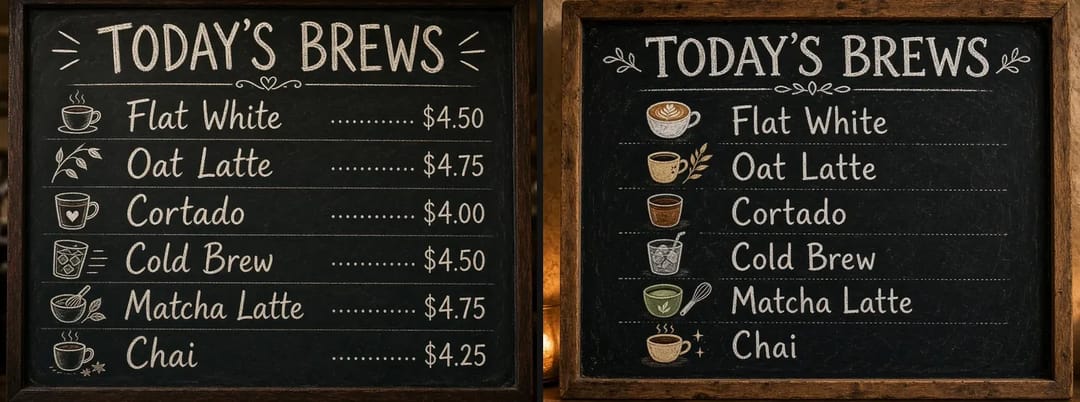
Po lewej: 2.0 Low. Po prawej: 2.0 Medium.
Oba dały wszystkie sześć napojów i ich ikony. Ale Low sam z siebie dodał cenę na końcu każdej linijki, choć prompt w ogóle nie wspominał o cenach. Gdyby kawiarnia naprawdę użyła tej tablicy, ktoś musiałby poprawiać te liczby jedną po drugiej. Medium napisał tylko to, o co go poproszono. Jeden test nie dowodzi, że Low zawsze tak robi, ale warto pamiętać, że Low czasem dodaje rzeczy, o które nikt nie prosił.
Portret nie ma dobrej ani złej odpowiedzi. Wszystkie cztery są dobre, a różnice sprowadzają się do gustu.
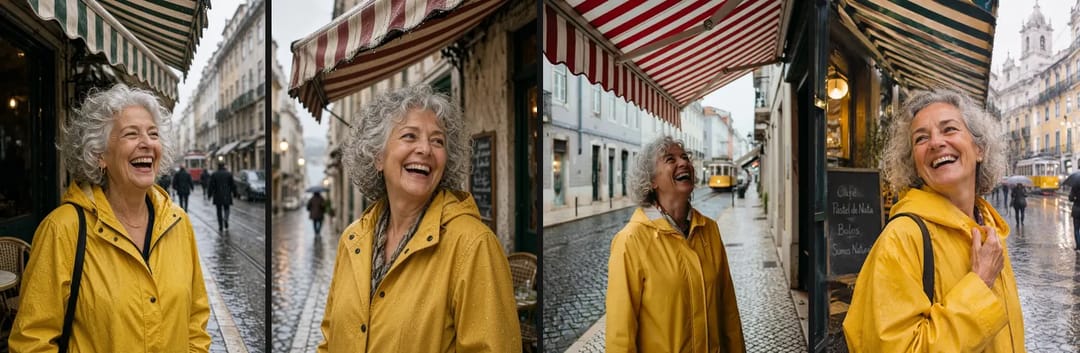
Od lewej do prawej: 2.0 Low, 2.0 Medium, Grok Imagine pierwszej generacji, GPT Image 2.6.
Na 2.0 Low kobieta śmieje się prosto do obiektywu, co wygląda trochę na pozowane. Na Medium przechyla głowę i śmieje się swobodnie, jak w chwili, którą ktoś akurat złapał. Model pierwszej generacji odsuwa się, a ulica wypełnia większość kadru. GPT Image 2.6 też wygląda spontanicznie, a mała tablica kredowa za nią wymienia po portugalsku kilka wypieków, co jest miłym lizbońskim akcentem. Żaden z czterech nie pominął niczego, o co prosił prompt.
Edycja i łączenie: trzy obrazy w jeden
Tu Grok Imagine Image 2.0 w końcu odskakuje od pierwszej generacji. Obrazy referencyjne były trzy: zdjęcie corgi z telefonu, czerwony rower w stylu vintage z koszykiem i słoneczna uliczka nad morzem. Prompt prosił, żeby corgi siedział w przednim koszyku roweru, a rower stał zaparkowany na tej uliczce.
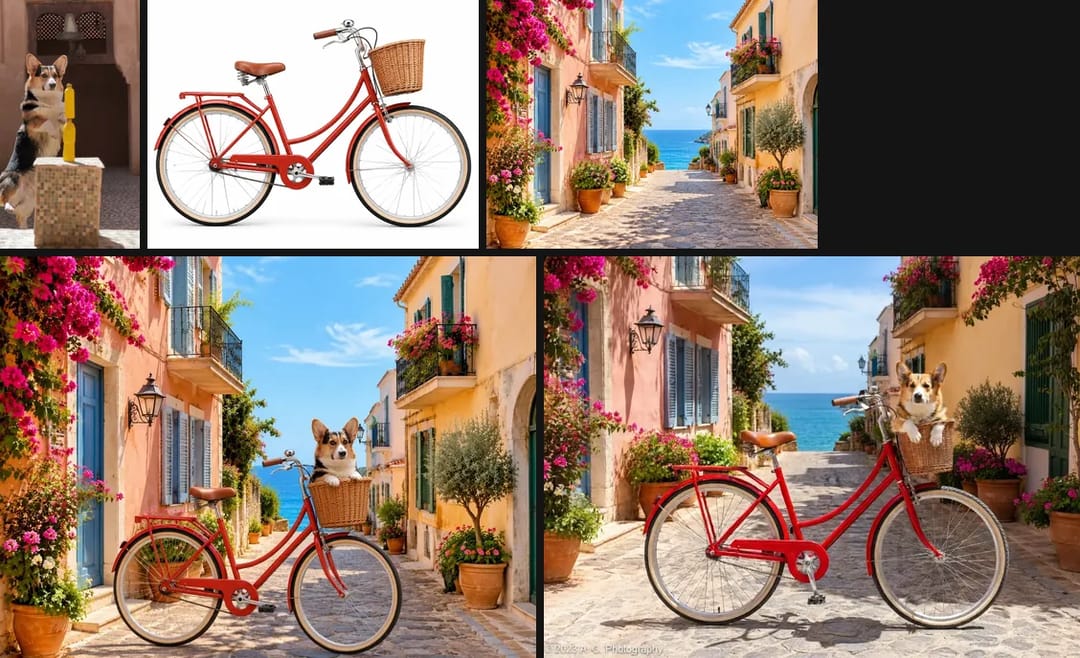
Górny rząd, trzy referencje: zdjęcie corgi, rower i uliczka nad morzem. Dolny rząd: kompozycja z 2.0 Medium po lewej, kompozycja z pierwszej generacji po prawej.
Na pierwszy rzut oka oba dały radę. Corgi siedzi w koszyku, rower i uliczka zgadzają się z referencjami, a nawet lampa ścienna i doniczki z kwiatami trafiły do kadru. Żeby zobaczyć różnicę, trzeba powiększyć.
Pierwsza to pies. Corgi na zdjęciu referencyjnym jest trójkolorowy, z czarną sierścią nad oczami i wzdłuż grzbietu. 2.0 Medium zachował te czarne znaczenia. Corgi z modelu pierwszej generacji wyszedł płowo-biały i z bliska to już nie jest twój pies. Druga jest w lewym dolnym rogu, gdzie model pierwszej generacji dodał małą linijkę tekstu, która wygląda jak podpis fotografa. 2.0 tego nie zrobił. Znak wodny, który pojawia się znikąd, to kolejna rzecz do usunięcia przed publikacją.
Zapewnienie xAI, że model przy edycji zachowuje to, co mu dasz, widać tutaj. Jeśli używasz narzędzia Edytuj obraz do zdjęć własnego zwierzaka, portretu czy produktu, to ma większe znaczenie niż to, czy nagłówek jest poprawnie napisany.
Szybkość: ile trwają Low i Medium
Tyle trwał każdy obraz w tym teście, wszystkie w 1K:
- 2.0 Low: od 14 do 57 sekund, zwykle poniżej 30
- 2.0 Medium: od 68 do 90 sekund
- Grok Imagine pierwszej generacji: od 11 do 14 sekund
- GPT Image 2.6 Medium: od 26 do 51 sekund
Medium w Grok Imagine Image 2.0 jest wyraźnie wolny. Każdy obraz zajmuje ponad minutę, dłużej niż GPT Image 2.6 w ustawieniu Medium. Model pierwszej generacji jest najszybszy i bardzo równy. Przy premierze wypróbowaliśmy też dwa szybkie zadania na 2.0 Low: tekst na obraz w 1K zajął 18 sekund, a zamiana zdjęcia w akwarelę 17, więc edycje idą mniej więcej tak szybko jak generowanie od zera.
Kiedy go używać, a kiedy przejść na GPT Image 2.6
Jeśli na obrazie jest tekst albo edytuję zdjęcie i nie chcę, żeby ludzie czy przedmioty się rozjechały, Grok Imagine Image 2.0 jest moim domyślnym wyborem. Zacznij od Low, żeby wypróbować kierunki. Jest tańszy i szybki, więc możesz za jednym razem puścić kilka kompozycji. Potem uruchom prompt, który ci się podoba, ponownie na Medium jako wersję finalną: układ wygląda na bardziej dopracowany, a model rzadziej wtrąca rzeczy, o których prompt nie wspominał. Cokolwiek wyjdzie z Low, zrób korektę tekstu.
Jeśli potrzebujesz tylko plakatu z krótkim nagłówkiem, Grok Imagine pierwszej generacji też zrobi to dobrze, i to dużo szybciej, więc to dobry wybór, gdy się spieszysz. Ale gdy w grę wchodzą obrazy referencyjne, zwłaszcza kompozycje, w których zwierzak, twarz albo szczegóły produktu muszą przejść nietknięte, przełącz się na Grok Imagine 2.0.
Do 4K, więcej niż 3 obrazów referencyjnych albo długiego, gęstego układu przejdź na GPT Image 2.6. Grok Imagine Image 2.0 kończy na 2K i przyjmuje najwyżej 3 obrazy referencyjne, i to są twarde limity.
Wszystkie te modele są na tej samej stronie, w narzędziu Generator obrazu, więc możesz przełączać się między nimi, nigdzie nie wychodząc. Jeden prompt puszczony przez każdy z nich powie ci więcej niż jakakolwiek recenzja.
Najczęściej zadawane pytania
Grok Imagine Image 2.0 Low czy Medium: którego używać?
Low do wypróbowywania kierunków i serii szkiców: jest tańszy, a większość obrazów wraca w ciągu pół minuty. Medium do obrazu finalnego: układy są bardziej dopracowane i model rzadziej coś dodaje od siebie, ale każdy obraz zajmuje ponad minutę.
Ilu obrazów referencyjnych mogę użyć?
Do 3. Bez obrazu to tekst na obraz, jeden obraz zamienia to w edycję, a dwa lub trzy pozwalają je połączyć.
Czy może tworzyć obrazy większe niż 2K?
Nie, 2K to maksimum. Jeśli potrzebujesz 4K, przejdź na GPT Image 2.6.
Czy potrafi tworzyć przezroczyste tła?
Nie, nie generuje przezroczystego tła. Jeśli chcesz od razu wycięty PNG, użyj zamiast tego Seedream 5.5.
Czy mogę pisać prompty w innych językach niż angielski?
Możesz je wpisać. Ale każdy prompt w tym teście był po angielsku i nie porównywałem jeszcze wyników w innych językach, więc nie mogę powiedzieć, jak dobrze działają.