مراجعة Vidu Q4: اختبرنا نموذج Vidu AI الجديد بأربعة مراجع ومقطع صوتي ودقة 2K
Vidu Q4 هو النموذج الذي أطلقته Vidu AI في أكتوبر 2026، ولا يزال يحمل وسم المعاينة. يَعِد بأمرين: أن تضع عناصر مرجعية كثيرة في لقطة واحدة، وأن تثبّت صوت الشخصية بمقطع صوتي.
يبدو هذا جيدًا على شريحة عرض. لكن هل يصمد في الواقع؟ بعد أن أضفنا Vidu Q4 إلى ZOOOP، جهّزنا مجموعة ثابتة واحدة من المدخلات وطرحنا عليها أربعة أسئلة.
الخلاصة السريعة
- المراجع متعددة العناصر تعمل فعلًا. أعطيناه شخصين ودراجة سكوتر وشارعًا، فظهرت الأربعة كلها في لقطة واحدة، دون أن يختلط الشخصان أو يتغيّر لون السكوتر.
- المرجع الصوتي يؤدي مهمته. الكلام في المقطع يأتي بطبقة صوت تكاد تطابق الصوت المرجعي.
- مقارنةً بـ Vidu Q3 Pro، تبدو لقطة بسيطة من الإطار الأول متطابقة تقريبًا، بينما تكلفة Vidu Q4 أقل بشكل ملحوظ.
- دقة 2K أوضح بكثير من 540p، لكن الدقة الأعلى تعطيك مقطعًا جديدًا، لا نسخة مكبّرة.
- لا يوجد وضع للنص وحده، ولا إطار أخير. تبدأ دائمًا من صورة واحدة على الأقل.
ما هو Vidu Q4
Vidu Q4 هو أحدث نموذج فيديو من Vidu AI، ويعمل بطريقتين. وضع الإطار الأول يحرّك صورة واحدة، ويحافظ الناتج على نسبة أبعاد الصورة. وضع المراجع يقبل ما يصل إلى 12 صورة مرجعية وما يصل إلى ثلاثة مقاطع صوتية بصيغة MP3 مدة كل منها من 3 إلى 12 ثانية، ويبني مشهدًا واحدًا حول تلك العناصر والأصوات.
مدة المقاطع في الوضعين من 3 إلى 16 ثانية، مع خمس درجات دقة من 540p إلى 4K، وصوت أصلي يُولَّد مع الفيديو ويمكنك إيقافه. على ZOOOP تجد وضع الإطار الأول في تحويل الإطار الأول والأخير إلى فيديو، ووضع المراجع في مولّد الفيديو بالذكاء الاصطناعي. اختر Vidu Q4 في أيّ منهما.
الاختبار 1: أربعة عناصر مرجعية في لقطة واحدة
صنعنا أربع صور مرجعية باستخدام مولّد الصور بالذكاء الاصطناعي: امرأة بمعطف أحمر، ورجل ملتحٍ يضع نظارة، ودراجة سكوتر عتيقة بلون أخضر نعناعي، وشارع مرصوف بالحجارة في بلدة أوروبية قديمة.
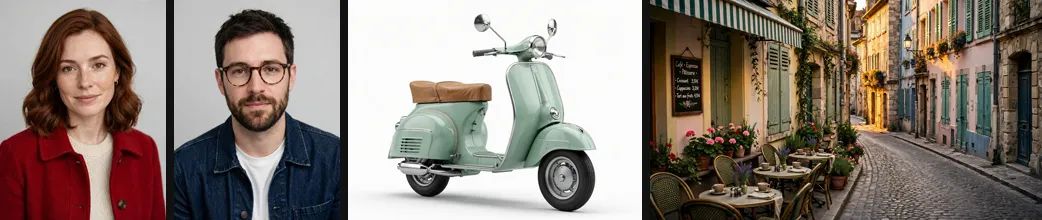
الأمر النصي: يقود الرجل السكوتر في الشارع وقت الساعة الذهبية والمرأة تجلس خلفه، وتلوّح هي للكاميرا. 720p، و5 ثوانٍ.
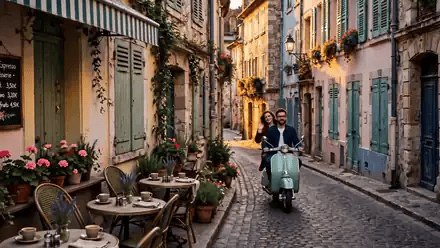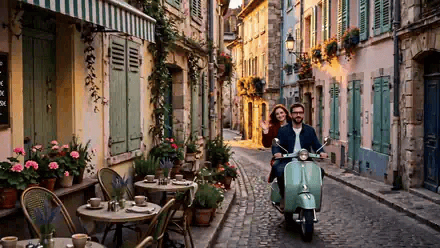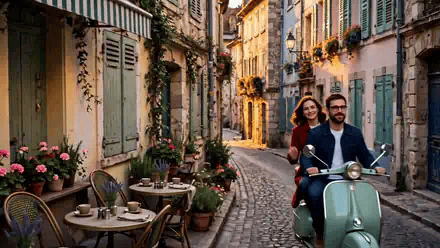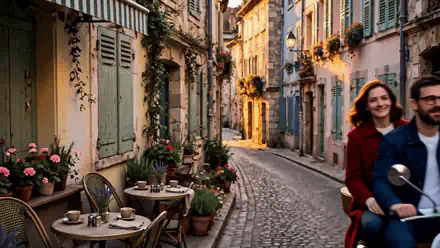
أوقف المقطع عند الثانية الأخيرة وستجد كل مرجع في مكانه. المعطف الأحمر والشعر الكستنائي المائل إلى الحمرة لها، والنظارة واللحية له، والسكوتر بذلك اللون الأخضر النعناعي نفسه، والشارع هو شارع المرجع، بما في ذلك طاولات المقهى على اليسار.
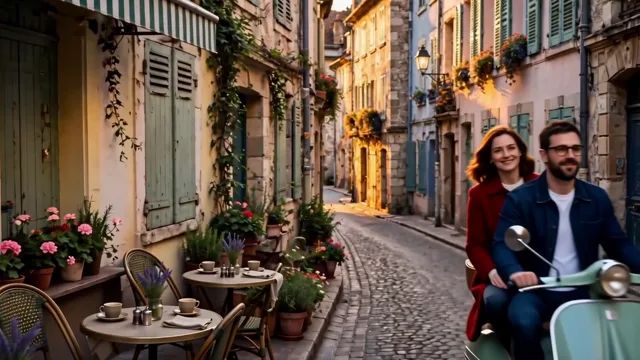
نقطة الضعف: في النصف الأول يكون الراكبان بعيدين ووجهاهما صغيرين. إن كنت تحتاج إلى وجوه واضحة طوال المقطع، فاكتب "medium shot" أو "the riders fill half the frame" في الأمر النصي.
الاختبار 2: مرجع صوتي للشخصية
هنا يتميّز Vidu Q4 أكثر من أي مكان آخر، وهذه هي القدرة الجديدة الأبرز في هذا الجيل من Vidu AI. استخدمنا تحويل النص إلى كلام لصنع مقطع مدته 5.7 ثانية لامرأة تعرّف بنفسها، ثم أعطينا النموذج هذا المقطع مع صورة صاحبة المعطف الأحمر، وطلبنا أن تقول الجملة للكاميرا وهي في الشارع. 540p، عمودي 9:16، و6 ثوانٍ.
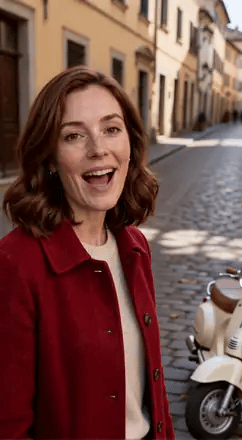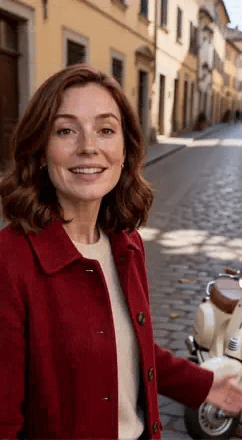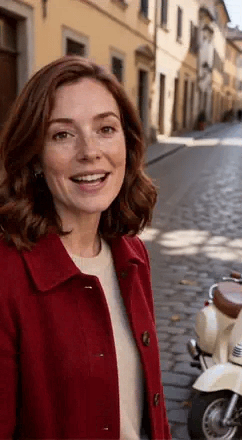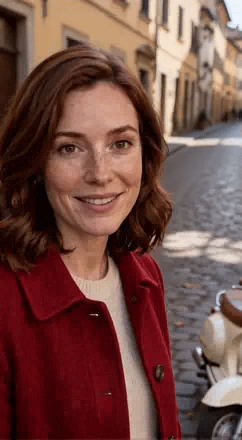
حركة الفم وإيقاع الكلام متوافقان مع الصوت. لتقييم الصوت لم نعتمد على آذاننا وحدها، بل قسنا طبقة الصوت: الوسيط في المقطع المرجعي نحو 219 هرتز، وفي الكلام المولَّد نحو 225 هرتز، أي أن الفرق أقل من 3% ومدى الانتشار شبه متطابق. بعبارة أخرى، Vidu Q4 يتبع الصوت المرجعي فعلًا.
سيعجب هذا كل من يصنع سلسلة: يمكن للشخصية نفسها أن تحتفظ بالصوت نفسه من مقطع إلى آخر.
الاختبار 3: الإطار الأول نفسه، Vidu Q4 مقابل Vidu Q3 Pro
سؤال شائع: ما الذي يتفوّق فيه Vidu Q4 على Vidu Q3؟ أخذنا صورة واحدة لامرأة تحمل قهوتها عند نافذة مقهى، وأمرًا نصيًا واحدًا (ترفع الفنجان، وتأخذ رشفة، وتبتسم وتلتفت نحو الكاميرا)، وشغّلناه على النموذجين بدقة 720p ولمدة 5 ثوانٍ.
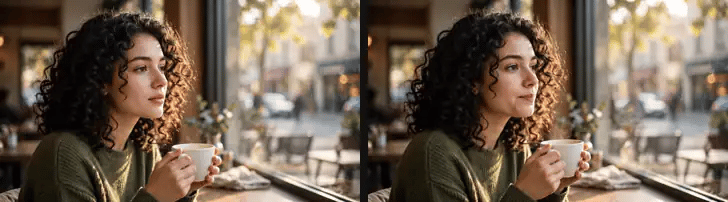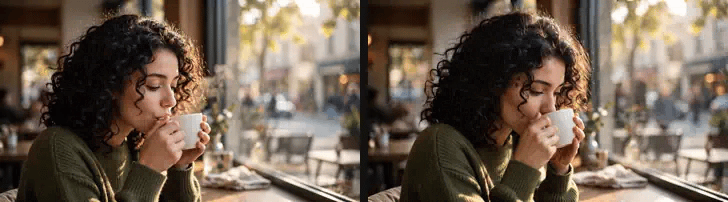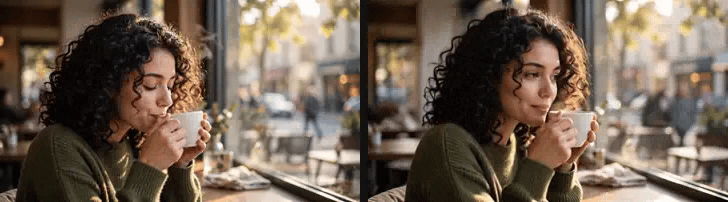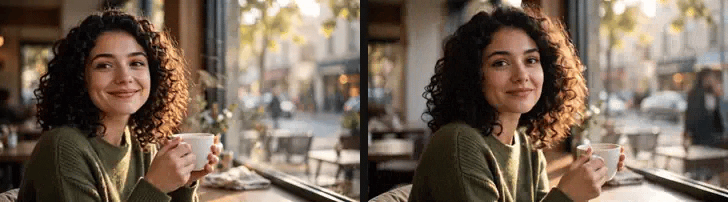
بصراحة، الفرق ضئيل جدًا. الحركة تكاد تكون واحدة في المقطعين: رشفة، ثم ينخفض الفنجان قليلًا، ثم التفاتة وابتسامة. والضوء والشعر والفنجان صمدت كلها بالقدر نفسه.
لذا إن كان كل ما تحتاجه هو تحريك صورة واحدة، فكلٌّ من Vidu Q3 Pro و Vidu Q4 يؤدي المهمة، و Q4 هنا هو الأرخص بوضوح. أما المكان الذي يتقدّم فيه Q4 فهو العمل بالمراجع متعددة العناصر والمدفوع بالصوت، كما في الاختبارين 1 و2، وهذا ما لا تقدّمه سلسلة Vidu Q3.
الاختبار 4: ما حجم الفرق بين 540p و2K
صورة السكوتر نفسها، والأمر النصي نفسه ("slow push-in as sunlight glints off the chrome mirrors")، 3 ثوانٍ بدقة 540p وبدقة 2K. هذه هي المنطقة نفسها مقتطعة من كل منهما:
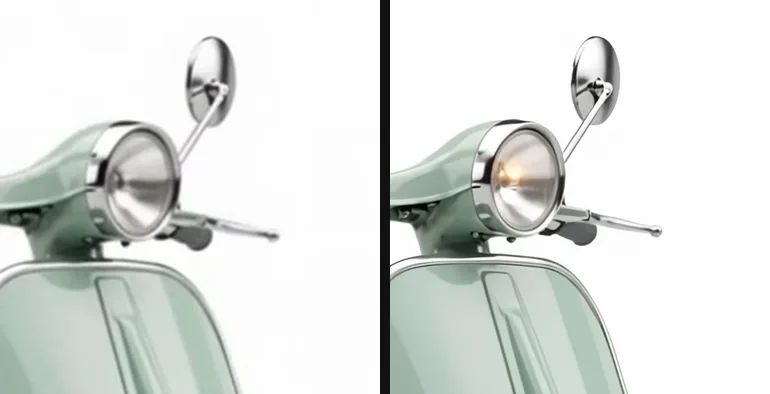
في 540p تبدو حافة المرآة وذراع الفرامل ضبابيتين؛ وفي 2K تظهر لمعات الكروم ومعدن الذراع بوضوح. ويحافظ وضع الإطار الأول أيضًا على شكل الصورة: صورة المنتج هذه بنسبة 4:3 عادت فيديو بنسبة 4:3.
لكن انتبه: المصباح الأمامي مضاء في مقطع 2K ومطفأ في مقطع 540p. تغيير الدقة يعطيك مقطعًا مختلفًا، لا لقطة 540p نفسها مكبّرة. استخدم 540p لاختبار الأوامر النصية، لا لاختيار لقطة ثم "ترقيتها".
ما الذي تعطّل، والحدود
- لا توليد من النص وحده. وضع الإطار الأول يحتاج إلى صورة، ووضع المراجع يحتاج إلى صورة مرجعية واحدة على الأقل. لتحويل النص وحده إلى فيديو، استخدم نموذجًا آخر.
- لا إطار أخير. الانتقالات من نوع "حوّل A إلى B" خارج نطاقه.
- وضع المراجع أبطأ. مقاطعنا من الإطار الأول عادت خلال دقيقة أو دقيقتين، أما مقاطع المراجع فاستغرقت عدة دقائق.
- ما زال نسخة معاينة. قد يتغيّر سلوكه بين إصدار وآخر، فجرّبه على نطاق صغير قبل أي مشروع كبير.
- يجب أن تكون المراجع الصوتية بصيغة MP3، ومدة كل منها من 3 إلى 12 ثانية.
كيف تستفيد من Vidu Q4 إلى أقصى حد
هذا هو الترتيب الذي نجح معنا مع نموذج Vidu AI الجديد:
- اختبر الأوامر النصية وتركيبات المراجع بدقة 540p ولمدة 3 إلى 5 ثوانٍ، وتأكد من التعرّف على كل شخص وكل غرض؛
- حين يصبح الاتجاه صحيحًا، ولّد النسخة النهائية بدقة 1080p أو 2K أو 4K؛
- لعدة مقاطع لشخصية واحدة، أعد استخدام المرجع الصوتي نفسه ليبقى الصوت ثابتًا؛
- اجمع القطع على الكنفاس التوليدي.
إن كنت تحتاج فقط إلى بثّ الحياة في صورة، ولا تحتاج إلى عناصر متعددة أو صوت، فنتائج Q3 Pro و Q4 متقاربة، وأيّهما يفي بالغرض.
الخلاصة
Vidu Q4 ليس أفضل من الجيل السابق في كل شيء؛ ففي لقطة بسيطة من الإطار الأول يتعادل مع Vidu Q3 Pro. قيمته في أنه يضع عدة أشخاص وأغراض محدّدة في لقطة واحدة، ويثبّت الصوت بمقطع صوتي، وهما أمران كانا في السابق مستحيلين أو يحتاجان إلى إصلاح في مرحلة ما بعد الإنتاج. لشخصيات العلامات التجارية، والمقاطع القصيرة المتسلسلة، والإعلانات التي يظهر فيها عدة أشخاص، يستحق نموذج Vidu AI الجديد التجربة.
المواصفات ومزيد من الأمثلة في صفحة نموذج Vidu Q4.