Grok Imagine Image 2.0 Low vs Medium: Uji Teks dan Edit Gambar
Ulasan Grok Imagine 2.0: Low dan Medium vs Grok Imagine pertama dan GPT Image 2.6 di poster, kemasan, menu, potret, edit 3 gambar, dan kecepatan.
xAI merilis Grok Imagine Image 2.0 pada 7 Agustus. Pengumuman resminya membuat beberapa janji: mengikuti prompt sampai ke detail, menata huruf seperti desainer, menjaga teks kecil tetap terbaca, dan mempertahankan apa pun yang Anda berikan saat mengedit. Per 15 November, Anda juga bisa memakainya di ZOOOP.
ZOOOP sudah punya Grok Imagine generasi pertama, jadi saya ingin jawaban untuk dua pertanyaan: apa yang benar-benar lebih baik dari Grok Imagine 2.0, dan apakah Low dan Medium layak diperlakukan sebagai alat yang terpisah. Saya menjalankan prompt yang sama di kedua tingkat kualitas 2.0, model generasi pertama, dan GPT Image 2.6, lalu membandingkannya berdampingan. Versi singkatnya: soal teks, keempatnya seri kali ini. Keunggulan Grok Imagine Image 2.0 ada pada edit yang menjaga subjek Anda tetap utuh, tidak menambahkan hal yang tidak Anda minta, dan tata letak yang lebih mendekati karya jadi.
Apa itu Grok Imagine Image 2.0, dan bedanya dengan versi pertama
Grok Imagine Image 2.0 adalah model gambar generasi kedua dari xAI. Di ZOOOP cara kerjanya sama dengan Grok Imagine generasi pertama: buat langsung dari prompt, atau tambahkan hingga 3 gambar referensi untuk mengedit atau menggabungkannya. Ada tujuh rasio aspek, 16:9, 3:2, 4:3, 1:1, 3:4, 2:3, dan 9:16, di 1K atau 2K. Kotak prompt menampung hingga 8.000 karakter, jadi teks, hierarki, dan warna muat semua dalam satu paragraf.
Perubahan paling jelas dari versi pertama adalah pilihan baru dua tingkat kualitas, Low dan Medium. Low lebih murah dari Medium, meski keduanya ada di kelompok murah di antara model-model di Pembuat Gambar AI ZOOOP. Model generasi pertama belum dipensiunkan, dan ikut muncul di setiap perbandingan di bawah.
Cara kami menguji
Empat prompt, masing-masing dijalankan sekali di empat model, semuanya di 1K: Grok Imagine Image 2.0 di Low dan di Medium, Grok Imagine generasi pertama, dan GPT Image 2.6 di Medium sebagai pembanding. Saya memilih prompt yang mengenai area yang menurut xAI paling banyak membaik:
- Poster malam jazz, 2:3. Judul utama "MIDNIGHT TIDE", satu baris teks kecil di bagian bawah, "Live at Harbor Hall · Friday 21 November · Doors 8 PM", dengan gaya sablon.
- Kemasan kaleng teh, 1:1. Label bertuliskan "CHAMOMILE CALM", dengan satu baris teks kecil di bawahnya, "Organic herbal infusion · 20 pyramid bags", dan bunga chamomile gambar tangan.
- Potret jalanan, 3:4. Lisbon di tengah hujan: seorang perempuan berusia enam puluhan dengan rambut ikal keperakan dan jas hujan kuning, tertawa di bawah kanopi kafe.
- Menu papan tulis kapur, 4:3. Judul "TODAY'S BREWS", enam minuman ditulis tangan satu per baris, masing-masing dengan ikon kecil. Harga tidak disebut dalam prompt.
Saya juga menjalankan komposit tiga gambar secara terpisah, hanya di 2.0 Medium dan model generasi pertama.
Poster dan kemasan: apakah teksnya benar-benar tepat?
Pertama, hasil yang tidak saya duga. Keempat model mengeja judul utama dan teks kecil dengan benar, termasuk model generasi pertama. Baris bawah dengan tanggal dan jam keluar tepat huruf per huruf di keempat poster.
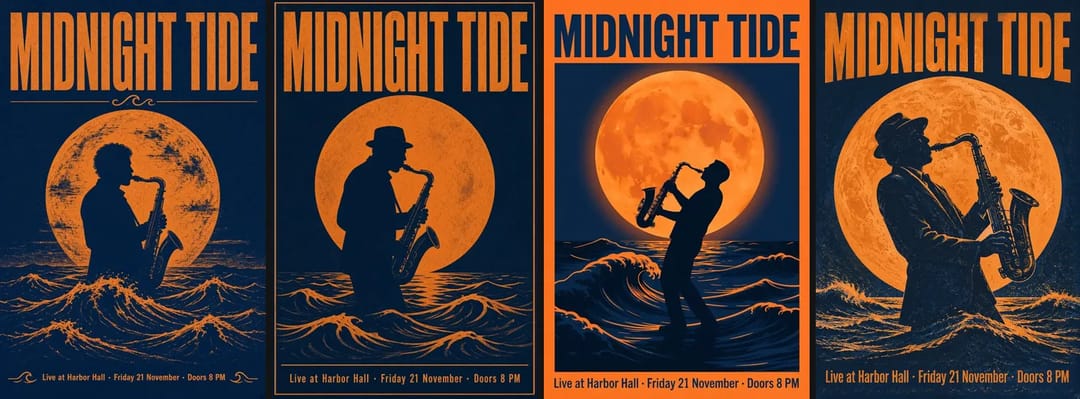
Dari kiri ke kanan: Grok Imagine Image 2.0 Low, 2.0 Medium, Grok Imagine generasi pertama, GPT Image 2.6.
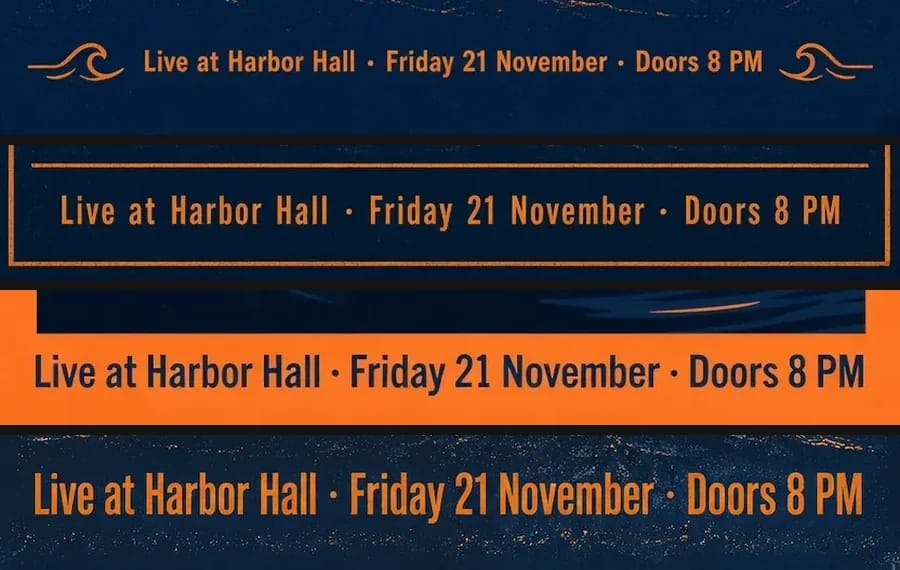
Dari atas ke bawah: 2.0 Low, 2.0 Medium, Grok Imagine generasi pertama, GPT Image 2.6.
Jadi, jujur saja: dengan teks sependek ini, peningkatan "teks lebih akurat" tidak terlihat. Teks kecilnya tajam, tapi model generasi pertama pun sudah sanggup menangani baris sepanjang ini. Tata letak yang lebih sulit, seperti satu halaman penuh petunjuk atau beberapa kolom teks kecil, tidak termasuk dalam pengujian ini.
Bedanya ada di tata letak. Keempat poster punya bulan, ombak, dan siluet pemain saksofon. 2.0 Low membingkai teks kecil dengan ornamen ombak mungil. 2.0 Medium menarik garis tipis mengelilingi seluruh poster dan menyelipkan teks kecil di dalamnya, sehingga terlihat seperti poster konser yang benar-benar sudah masuk percetakan. Model generasi pertama mengecilkan ilustrasinya menjadi satu blok di atas latar oranye, dan komposisinya jadi lebih datar. GPT Image 2.6 punya tekstur grain yang paling terasa seperti sablon sungguhan.
Kaleng teh menunjukkan selisih yang lebih besar.
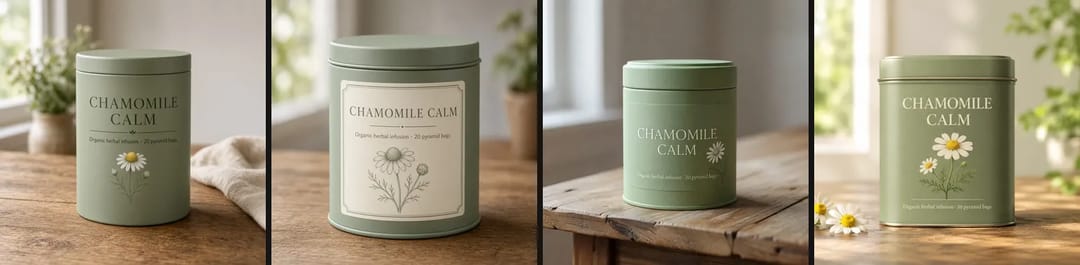
Dari kiri ke kanan: 2.0 Low, 2.0 Medium, Grok Imagine generasi pertama, GPT Image 2.6.
Grok Imagine Image 2.0 di Medium mengubah labelnya menjadi stiker putih gading dengan bingkai tipis dan bunga chamomile bergaya gambar garis, dan seluruh kalengnya terlihat seperti barang yang bisa Anda ambil dari rak. Low mencetak tulisannya langsung di kaleng. Hierarkinya tetap jelas, dan cukup bagus untuk pitch. Teks kecil model generasi pertama sedikit kabur saat diperbesar, meski ejaannya benar.
Menu dan potret: di sini Low dan Medium berpisah jalan
Menu papan tulis adalah satu-satunya saat Grok Imagine Image 2.0 Low jelas melakukan kesalahan.
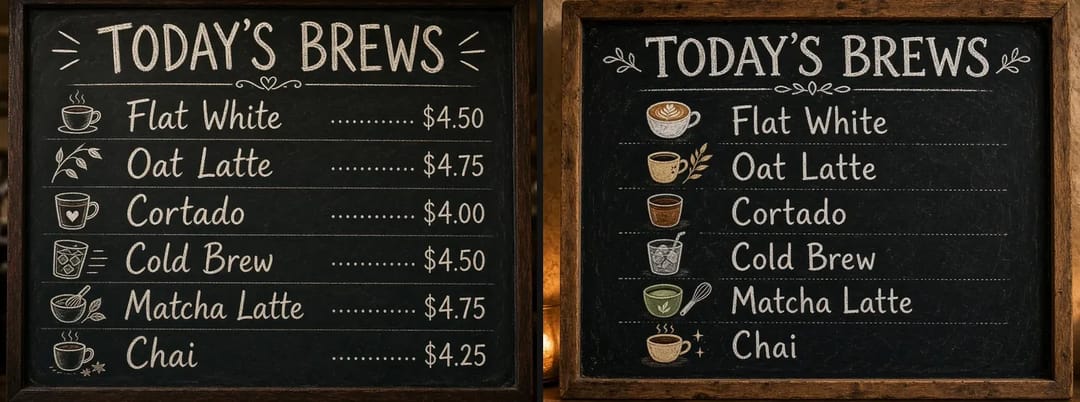
Kiri: 2.0 Low. Kanan: 2.0 Medium.
Keduanya menampilkan keenam minuman beserta ikonnya. Tapi Low menambahkan harga di akhir setiap baris atas inisiatif sendiri, padahal prompt sama sekali tidak menyebut harga. Kalau sebuah kafe benar-benar memakai papan ini, seseorang harus membetulkan angka-angka itu satu per satu. Medium hanya menulis apa yang diminta. Satu pengujian tidak membuktikan Low selalu begitu, tapi perlu diingat bahwa Low kadang menambahkan hal yang tidak diminta siapa pun.
Potret tidak punya jawaban benar atau salah. Keempatnya bagus, dan bedanya soal selera.
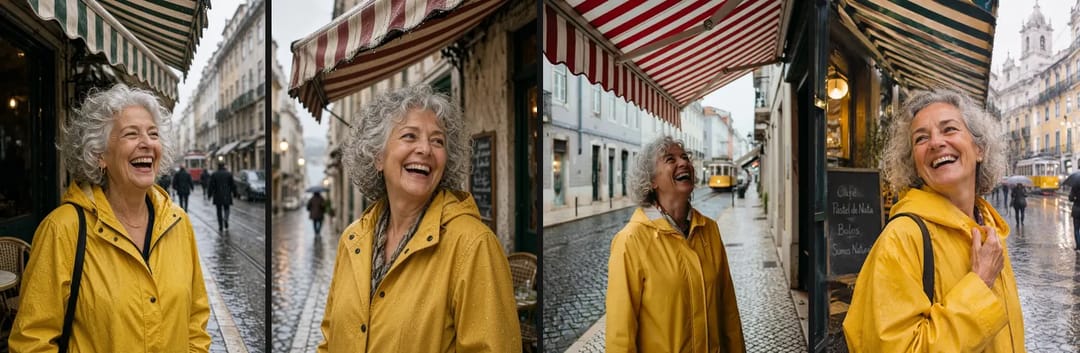
Dari kiri ke kanan: 2.0 Low, 2.0 Medium, Grok Imagine generasi pertama, GPT Image 2.6.
Di 2.0 Low, ia tertawa langsung ke arah kamera, yang terasa sedikit dibuat-buat. Di Medium, ia memiringkan kepala dan tertawa lepas, seperti momen yang kebetulan tertangkap seseorang. Model generasi pertama mengambil jarak lebih jauh, dan jalanan mengisi sebagian besar frame. GPT Image 2.6 juga terasa candid, dan papan tulis kecil di belakangnya mencantumkan beberapa kue dalam bahasa Portugis, sentuhan khas Lisbon yang manis. Tidak satu pun dari keempatnya melewatkan apa yang diminta prompt.
Edit dan komposit: tiga gambar jadi satu
Di sinilah Grok Imagine Image 2.0 akhirnya meninggalkan generasi pertama. Ada tiga gambar referensi: foto ponsel seekor corgi, sepeda antik merah dengan keranjang, dan sebuah gang tepi laut yang cerah. Prompt meminta corgi duduk di keranjang depan sepeda, dengan sepeda diparkir di gang itu.
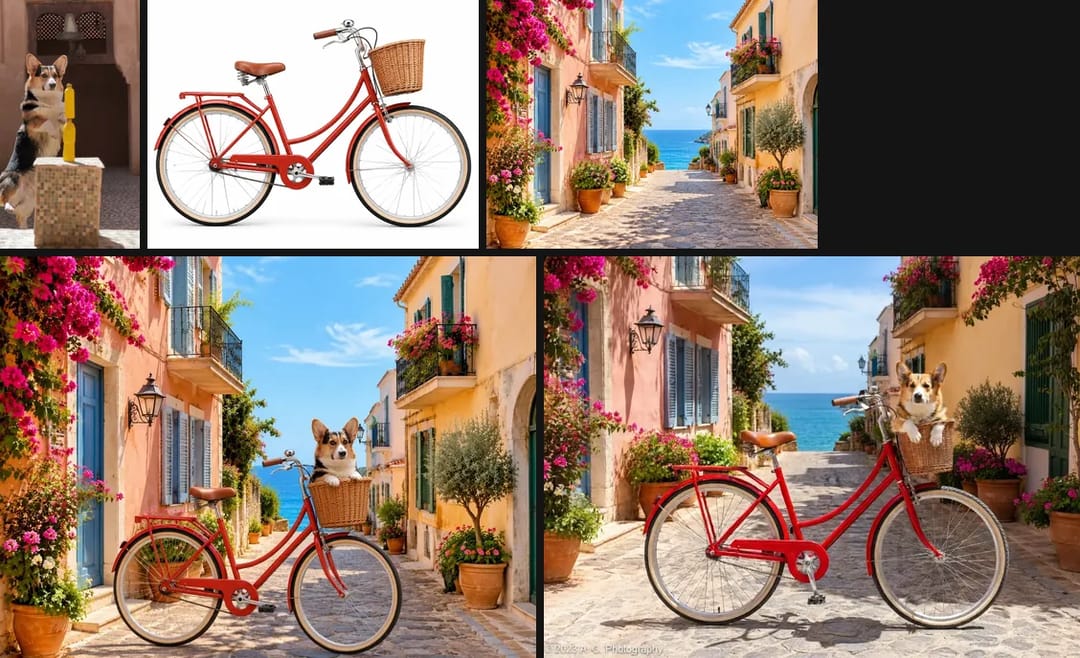
Baris atas, tiga referensi: foto corgi, sepeda, dan gang tepi laut. Baris bawah: komposit 2.0 Medium di kiri, komposit generasi pertama di kanan.
Sekilas keduanya berhasil. Corgi ada di keranjang, sepeda dan gang cocok dengan referensinya, bahkan lampu dinding dan pot bunganya ikut masuk. Anda harus memperbesar untuk melihat bedanya.
Pertama, anjingnya. Corgi di foto referensi berwarna tricolor, dengan bulu hitam di atas mata dan di sepanjang punggung. 2.0 Medium mempertahankan corak hitam itu. Corgi model generasi pertama keluar berwarna cokelat muda dan putih, dan dari dekat ia sudah bukan anjing Anda lagi. Kedua, di pojok kiri bawah, model generasi pertama menambahkan sebaris teks kecil yang tampak seperti nama fotografer. 2.0 tidak. Watermark yang muncul entah dari mana adalah satu hal lagi yang harus dibersihkan sebelum Anda posting.
Klaim xAI bahwa model ini mempertahankan apa yang Anda berikan saat mengedit terlihat di sini. Kalau Anda memakai Sunting Gambar untuk hewan peliharaan Anda, potret, atau foto produk, hal ini lebih penting daripada apakah judul utamanya dieja dengan benar.
Kecepatan: berapa lama Low dan Medium
Berikut berapa lama setiap gambar dalam pengujian ini, semuanya di 1K:
- 2.0 Low: 14 sampai 57 detik, kebanyakan di bawah 30
- 2.0 Medium: 68 sampai 90 detik
- Grok Imagine generasi pertama: 11 sampai 14 detik
- GPT Image 2.6 Medium: 26 sampai 51 detik
Medium di Grok Imagine Image 2.0 jelas lambat. Setiap gambar butuh lebih dari satu menit, lebih lama dari GPT Image 2.6 di pengaturan Medium-nya. Model generasi pertama yang tercepat, dan sangat stabil. Saat peluncuran kami juga mencoba dua uji cepat di 2.0 Low: teks ke gambar 1K butuh 18 detik dan mengubah foto menjadi lukisan cat air butuh 17 detik, jadi edit berjalan kurang lebih secepat membuat dari nol.
Kapan memakainya, dan kapan beralih ke GPT Image 2.6
Kalau sebuah gambar ada teksnya, atau saya sedang mengedit foto dan tidak ingin orang atau benda bergeser, Grok Imagine Image 2.0 jadi pilihan default saya. Mulai di Low untuk mencoba arah. Lebih murah dan cepat, jadi Anda bisa menjalankan beberapa komposisi sekaligus. Lalu jalankan ulang prompt yang Anda suka di Medium untuk hasil final: tata letaknya terlihat lebih jadi, dan lebih kecil kemungkinannya menyelipkan hal yang tidak pernah disebut prompt. Apa pun yang keluar dari Low, periksa teksnya.
Kalau Anda hanya butuh poster dengan judul pendek, Grok Imagine generasi pertama juga bisa menghasilkannya dengan benar, dan jauh lebih cepat, jadi pilihan yang baik saat Anda terburu-buru. Tapi begitu ada gambar referensi, terutama komposit yang menuntut hewan peliharaan, wajah, atau detail produk terbawa utuh, beralihlah ke Grok Imagine 2.0.
Untuk 4K, lebih dari 3 gambar referensi, atau tata letak yang panjang dan padat, beralihlah ke GPT Image 2.6. Grok Imagine Image 2.0 maksimal 2K dan menerima paling banyak 3 gambar referensi, dan itu batas mutlak.
Semua model ini ada di halaman Pembuat Gambar AI yang sama, jadi Anda bisa berganti di antara mereka tanpa pergi ke mana-mana. Menjalankan satu prompt di masing-masing akan memberi tahu Anda lebih banyak daripada ulasan mana pun.
Pertanyaan umum
Grok Imagine Image 2.0 Low atau Medium: mana yang sebaiknya dipakai?
Low untuk mencoba arah dan membuat draf dalam jumlah banyak: lebih murah, dan kebanyakan gambar selesai dalam setengah menit. Medium untuk gambar final: tata letaknya lebih rapi dan lebih kecil kemungkinannya menambahkan sesuatu sendiri, tapi setiap gambar butuh lebih dari satu menit.
Berapa banyak gambar referensi yang bisa dipakai?
Hingga 3. Tanpa gambar, ini teks ke gambar; satu gambar menjadikannya edit, dan dua atau tiga gambar memungkinkan Anda menggabungkannya.
Bisakah membuat gambar lebih besar dari 2K?
Tidak, 2K adalah maksimalnya. Kalau butuh 4K, beralihlah ke GPT Image 2.6.
Bisakah membuat latar belakang transparan?
Tidak, model ini tidak menghasilkan latar belakang transparan. Kalau Anda ingin PNG potongan langsung jadi, gunakan Seedream 5.5.
Bisakah saya menulis prompt dalam bahasa selain Inggris?
Bisa diketik. Tapi semua prompt dalam pengujian ini berbahasa Inggris, dan saya belum membandingkan hasilnya dalam bahasa lain, jadi saya tidak bisa bilang seberapa baik hasilnya.