Я сделал 8 обложек для YouTube с помощью ИИ: размеры, композиция и четыре, которые выбросил
Кликнут ли по видео, зависит от обложки сильнее, чем принято думать. Я потратил день, чтобы сделать целый комплект из 8 обложек для YouTube с помощью генерации изображений ИИ. Четыре кадра по дороге отправились в корзину, один результат опроверг совет, который я считал само собой разумеющимся, и я допустил более принципиальную ошибку — она заслуживает отдельного раздела.
Сначала измерьте требования, потом генерируйте
Рекомендуемый размер обложки для YouTube — 1280×720, то есть 16:9. Это число знают многие. На итоговый результат сильнее влияют две другие вещи.
Во-первых, правый нижний угол закрывается плашкой с длительностью видео. В пересчёте на 1280×720 она занимает примерно 132×36, и всё, что туда положено, теряет половину себя.
Во-вторых, о чём забывают чаще: в ленте обложка никогда не показывается в исходном размере. На главной странице десктопа она около 360px шириной, а в мобильной ленте рекомендаций часто всего около 168px. Я уменьшил одну и ту же обложку YouTube до трёх этих размеров и поставил рядом. На 360px ещё читаются реквизит и выражение лица. На 168px остаётся только цветное пятно и человеческий силуэт.
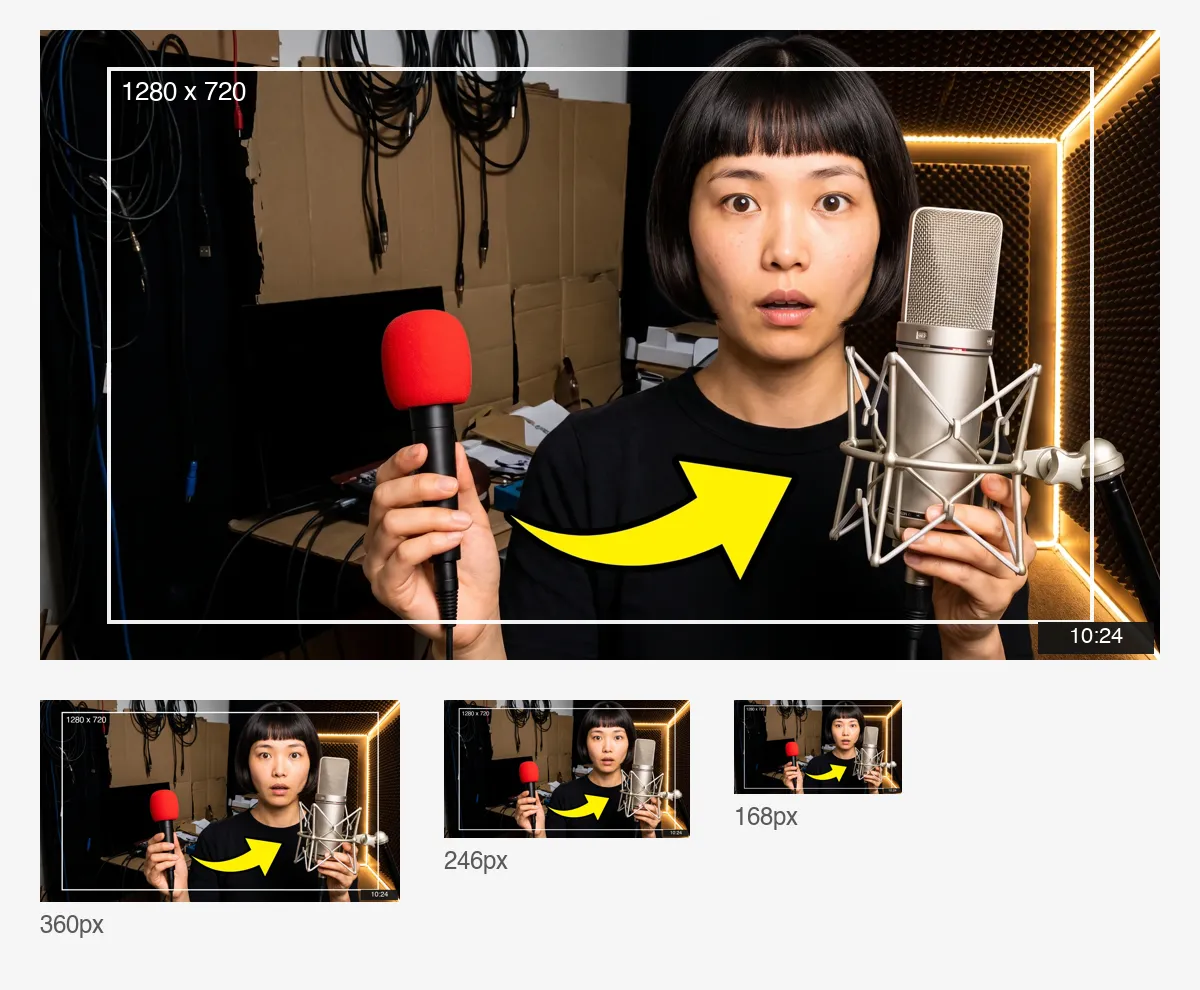
Поэтому до первой генерации я установил два правила. Держать героя и всё важное внутри центральной безопасной зоны с полями 6% со всех сторон, а правый нижний угол оставлять пустым. И оставлять в кадре одну чистую область, куда потом ляжет заголовок.
Начните с пробной фотографии — это фундамент всего комплекта
Самое трудное во всей работе в том, что человек на всех восьми обложках должен быть одним и тем же.
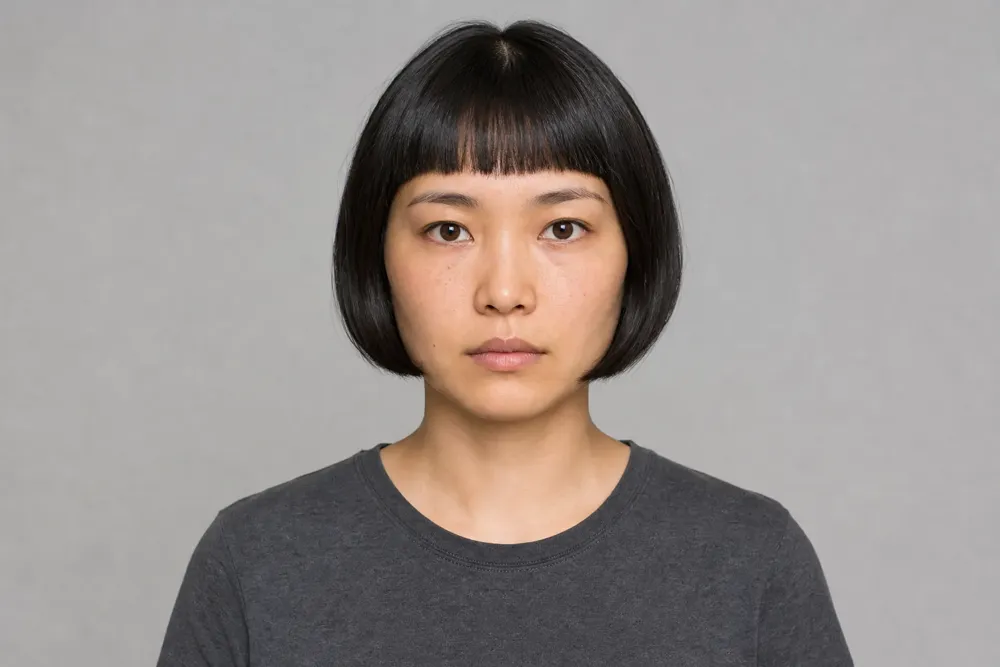
Мой подход: сначала сделать один чистый эталонный кадр через генерацию изображений ИИ — анфас, на уровне глаз, без макияжа, без эмоции, серый фон, ровный плоский свет, как проба на роль. Этот кадр совершенно непривлекателен и никогда не предназначался к публикации. Его единственная задача — служить референсом для всех последующих.
А теперь об ошибке.
В первом заходе я зафиксировал ещё и композицию. Героиня в левой трети, белый вырезной контур вокруг неё, лучи за головой, плоская заливка цветом на правой половине. Меняться разрешалось только выражению лица и цвету фона. Восемь кадров спустя лицо не поплыло ни на волос, но комплект выглядел как таблица эмоций, а не как восемь обложек. Другое лицо, другой цвет — и всё.
Причина простая. Настоящая обложка проектируется вокруг того, о чём видео, а единственная переменная, которую я дал модели, — мимика. Проектировать было нечего, и она просто повторила мой шаблон восемь раз.
Исправление состояло в том, чтобы вернуть модели дизайн. Фиксированный блок теперь запирает только то, что действительно нужно запереть: тот же человек, лицо освещено и не перекрыто, в кадре верхняя часть корпуса. Место действия, реквизит, графические элементы, палитра, свет, глубина и композиция — решение модели. Переменный блок превратился в одну фразу: о чём это видео.
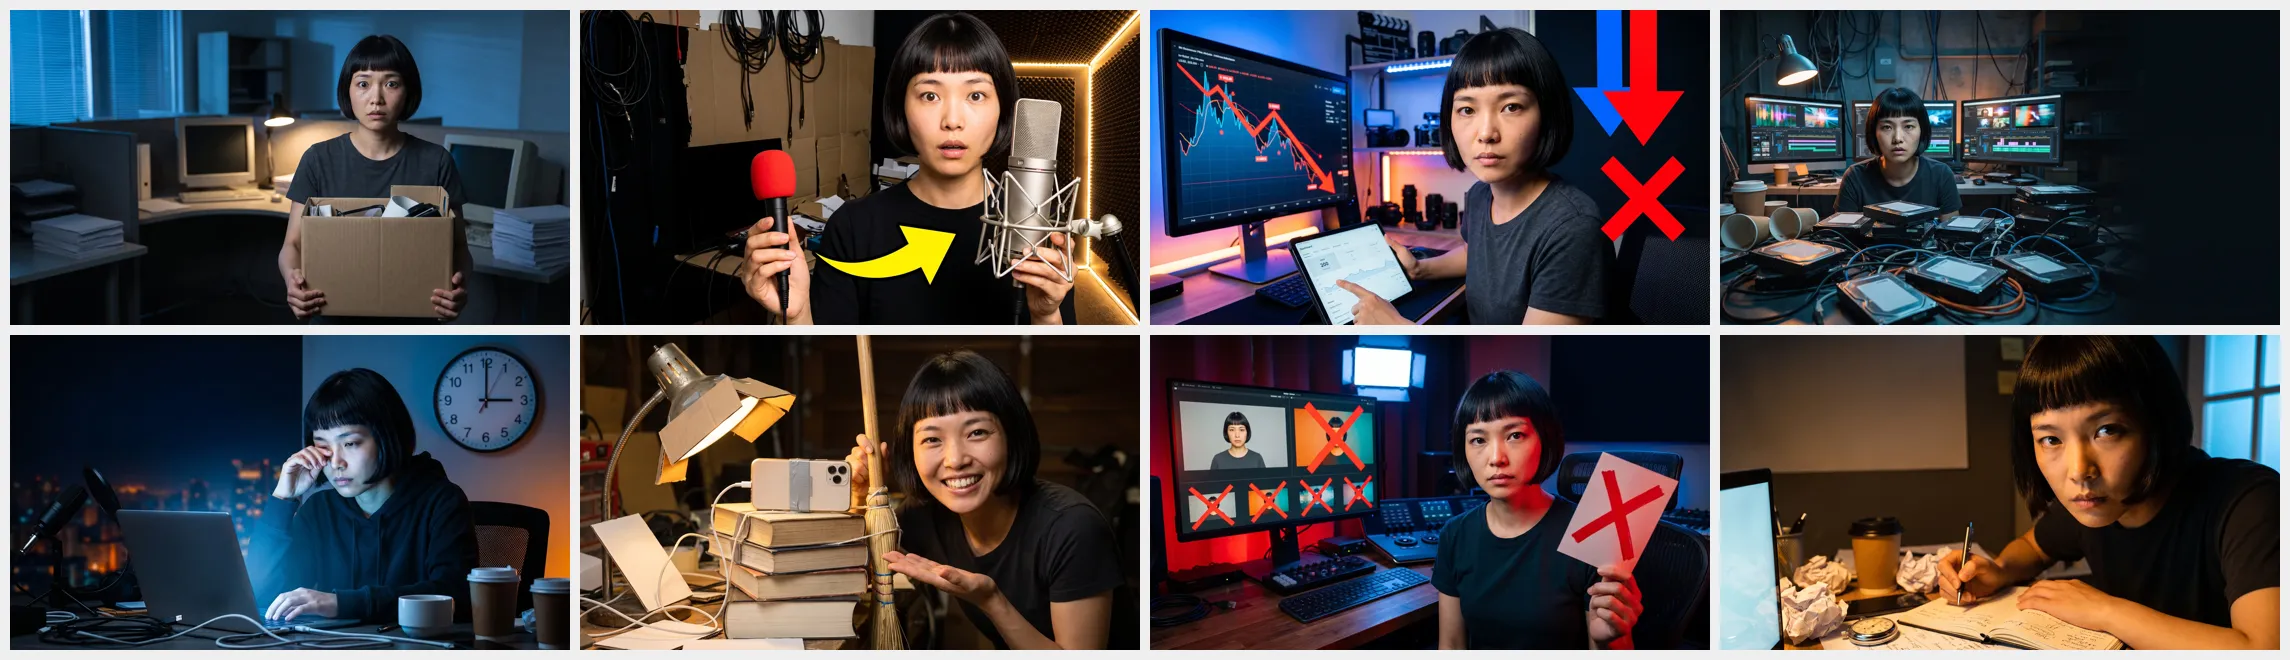
Восемь переменных были такие: уйти с офисной работы, микрофон за тридцать долларов обыгрывает микрофон за триста, застрять на двухстах просмотрах, смонтировать сто роликов за неделю, месяц публиковаться в три часа ночи, весь съёмочный комплект дешевле телефона, пять цветовых пресетов, от которых пора отказаться, и написать сценарий за двенадцать минут.
То, что вернулось, играет в другой лиге по сравнению с первым заходом. Жёлтая стрелка между красным ручным микрофоном и конденсаторным. Красная линия, обрушивающаяся по монитору, и красный крест рядом. Ряд превью пресетов, перечёркнутых по одному. Настенные часы на фоне ночного города в три часа. Ничего из этого графического языка не было в моём запросе — всё придумала модель изображений ИИ.
Я думал, она не умеет писать текст. Умеет.
О генерации изображений ИИ часто повторяют один совет: модели не умеют выводить читаемый текст, поэтому любые надписи получатся исковерканными. Я ему следовал, и каждый запрос заканчивался указанием не выводить текст в кадре.
Под конец я проверил и попросил модель написать заголовок прямо в свободной области.
Она написала верно. Ни одной ошибочной буквы, чистые формы, уместная насыщенность, разумные переносы в трёх строках. Со сегодняшними моделями изображений ИИ это старое правило уже почти не работает.
Мнения я всё же не поменял, потому что второй тест обнажил настоящую проблему. Я заменил в заголовке 200 на 500, не тронув ни одного другого слова, и запустил снова. Текст остался верным, но весь кадр пересобрали заново: она из положения вполоборота перешла в анфас по центру, монитор переехал с левого края прямо ей за спину, а размер и положение шрифта изменились следом. Поставленные рядом, эти два кадра не выглядят как один комплект.
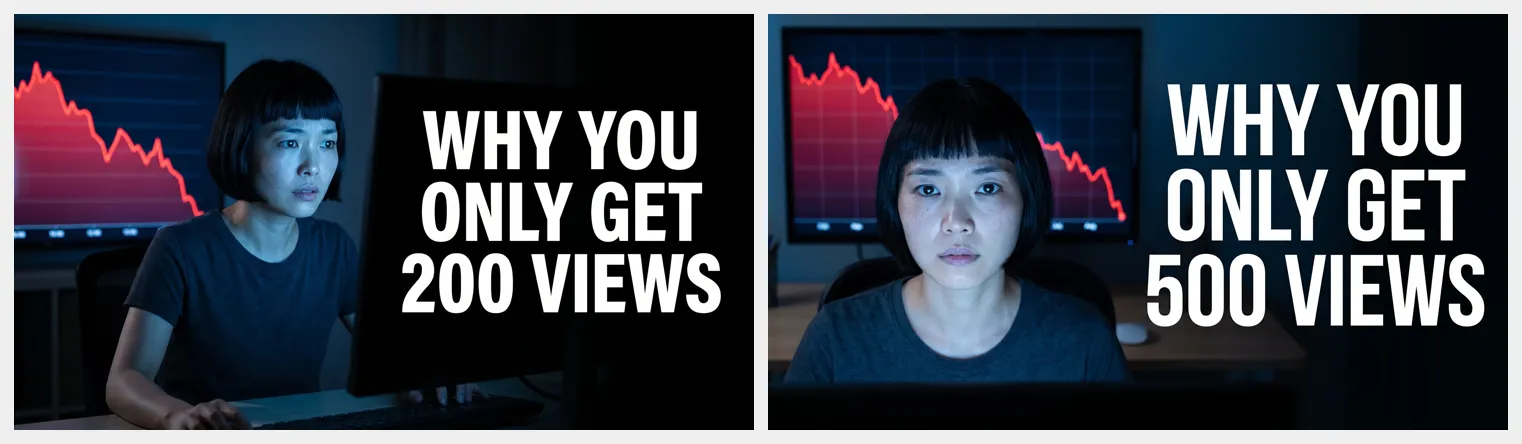
Так что вывод остаётся, но обоснование меняется. Проблема не в том, что модель не умеет писать, а в том, что вёрстка невоспроизводима. Если вы делаете целый комплект обложек для YouTube и рассчитываете потом менять заголовки или гонять A/B-тесты, держите текст вне изображения и накладывайте его отдельно. Для единичного кадра, к которому вы больше не вернётесь, пусть модель пишет сама — это экономит шаг.
Четыре, которые я выбросил
За передачу дизайнерских решений модели изображений ИИ приходится платить: она с удовольствием положит в кадр то, о чём вы не просили. Четыре переделки, три разных сбоя.
Реальные бренды. В кадре про уход с работы она вложила героине микрофон с названием настоящего производителя на боку. В кадре про сто монтажей на столе оказались две мгновенно узнаваемые банки энергетика. Ни то, ни другое не годится для публикуемого изображения.
Дублирование героя. Я добавил пункт про запрет брендов и перезапустил кадр про уход с работы — и получил её в двух экземплярах: одна печатает за столом, вторая стоит рядом с картонной коробкой в руках. Модель прочитала «уйти из офиса» как сцену, для которой нужны две актрисы.
Текст на реквизите. В кадре про дешёвый набор оборудования она аккуратно написала на картонной коробке два английских слова. Здесь это самое неприятное: изображения общие для 21 языка, поэтому текст на одном языке становится шумом для читателей остальных двадцати.
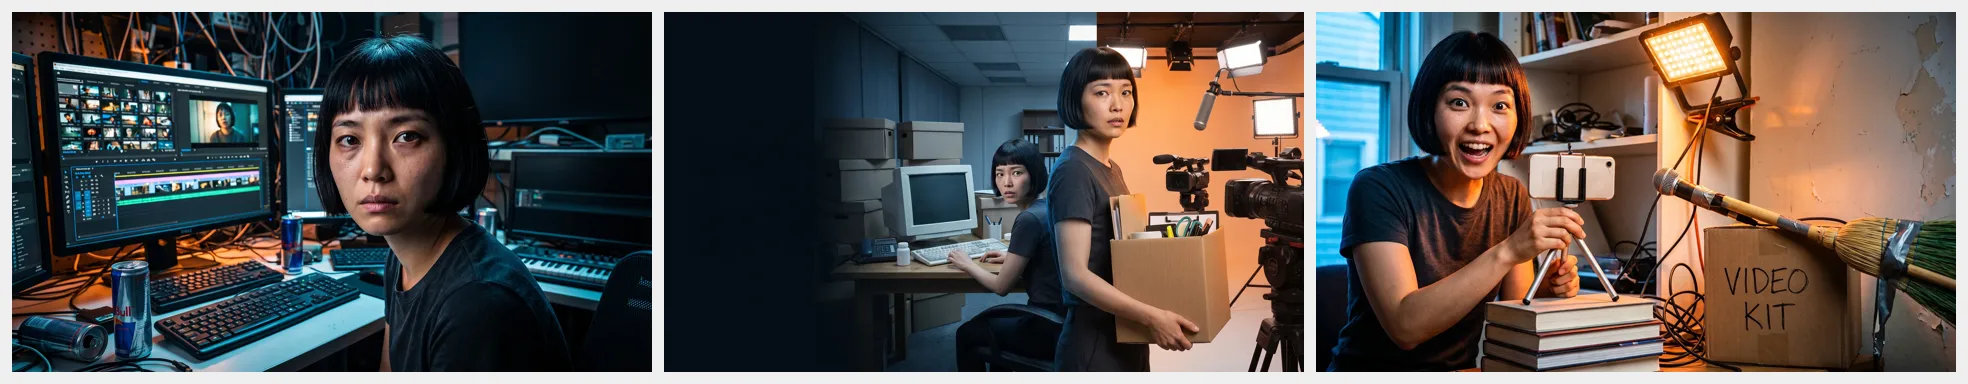
Все три превратились в пункты фиксированного блока, и формулировать их нужно предметно. «Без текста» недостаточно — нужно писать: никаких надписей на экранах, упаковке, этикетках, оборудовании и вывесках. «Один человек» тоже недостаточно: придётся отдельно исключить её второй экземпляр, отражение и её портрет на заднем плане.
Структура запроса, которую можно списать
Фиксированный блок вставляется без изменений в каждый запрос и звучит примерно так.
Используй того же человека, что на референсе, ту же причёску. Она должна мгновенно узнаваться как тот же человек, лицо освещено, не перекрыто и примерно обращено к камере, в кадре верхняя часть корпуса. Ты арт-директор и проектируешь обложку для YouTube, которая обязана заработать клик при ширине 168 пикселей: всё, кроме её внешности, решаешь ты — место действия, реквизит, графические элементы, палитра, свет, глубина и композиция. Сделай смело, контрастно и по существу этой темы, а не портретом на цветном фоне. Оставь в кадре чистую область для заголовка, который добавят позже. Нигде никакого текста, букв и цифр, в том числе на экранах, упаковке, этикетках, оборудовании и вывесках. Никаких логотипов и узнаваемых товарных знаков; весь реквизит без маркировки. Ровно один человек в кадре.
Переменный блок — одна фраза: о чём это видео.
Последние три запрета появились после переделок, по одному пункту на сбой. Структура переносится на другие модели изображений ИИ без изменений, отличаются только привычные формулировки.
Одна обложка, два применения
Когда восемь кадров были закреплены, у изображений ИИ оставалась ещё одна работа. Я взял кадр про три часа ночи как первый и через генерацию видео по первому и последнему кадру сделал пятисекундную заставку.
Здесь тоже есть настоящая ловушка. Сгенерированный ролик перекадрировал сцену, и чистая область, которую я старательно берёг под заголовок, была почти съедена. Для заставки это неважно. Для финальной карточки пришлось бы верстать заново.
Чтобы прогнать целую партию разом, восемь задач на изображения ИИ удобнее разложить по генеративному холсту, чем идти по одной: сразу видно, что оставить, а что переделать. Если писать запросы с нуля не хочется, в разделе шаблонов есть готовые портретные стили.
Восемь финальных кадров за один день
Весь комплект обложек для YouTube занял день от первого запуска до восьми закреплённых кадров, четыре ушли в брак. Долгим оказалось не генерирование и не ретушь, а понимание, что именно отдать модели: сначала я держал слишком крепко, прибил композицию гвоздями и получил восемь одинаковых картинок.
Если хотите повторить, порядок такой: измерить безопасную зону и три реальных размера отображения, сгенерировать невзрачный, но чистый эталонный кадр, свести фиксированный блок к человеку плюс эти несколько запретов и считать тему каждого кадра единственной переменной. Что до текста — для комплекта добавляйте после, для единичного кадра пусть пишет модель.
Весь комплект обложек для YouTube обошёлся ровно двумя инструментами изображений ИИ: генерацией изображений ИИ и редактированием изображений ИИ.