Ho creato 8 miniature YouTube con l'IA: misure, inquadratura e le quattro che ho buttato
Che un video venga cliccato o meno dipende dalla miniatura più di quanto si creda. Ho passato un pomeriggio a produrre un set completo di 8 miniature YouTube con la generazione di immagini IA. Quattro sono finite nel cestino strada facendo, un risultato ha smentito un consiglio che davo per scontato, e ho commesso un errore più di fondo che merita una sezione a sé.
Misura le specifiche prima di generare qualsiasi cosa
La dimensione consigliata per una miniatura YouTube è 1280×720, cioè 16:9. Questo numero lo sanno in molti. Sono altre due cose a pesare di più sulla resa finale.
Primo: l'angolo in basso a destra viene coperto dal badge con la durata del video. Rapportato a 1280×720 occupa circa 132×36, e qualunque cosa metti lì ne perde metà.
Secondo, ed è più facile da dimenticare: nel feed le miniature non vengono mai mostrate a dimensione reale. La home page da desktop le mostra intorno ai 360px di larghezza, e il feed di consigliati da telefono spesso si ferma a circa 168px. Ho ridotto la stessa miniatura YouTube a queste tre misure e le ho messe una accanto all'altra. A 360px si leggono ancora gli oggetti di scena e l'espressione. A 168px sopravvive solo una macchia di colore e una sagoma umana.
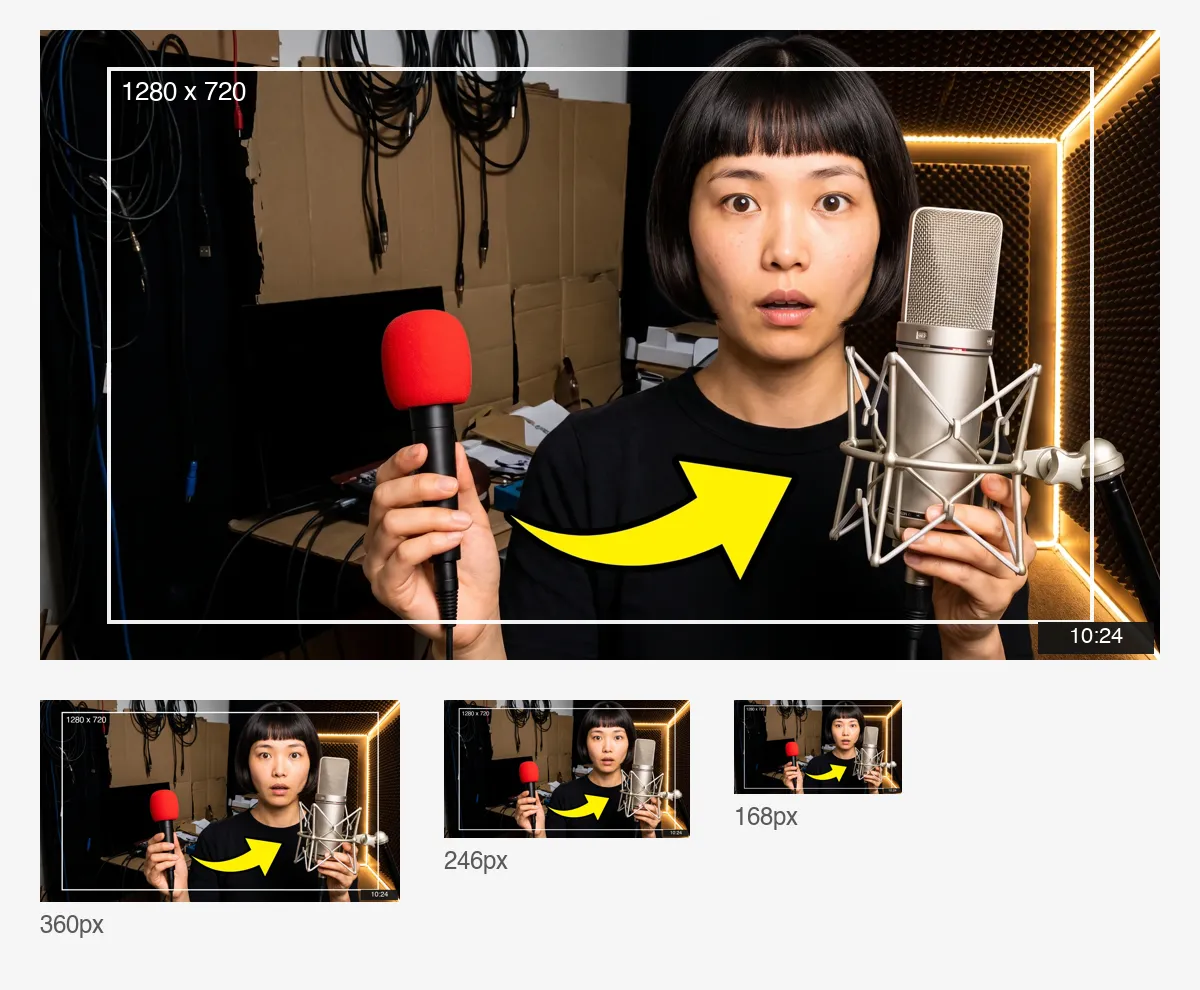
Così ho fissato due regole prima di generare. Tenere il soggetto e tutto ciò che conta dentro un'area di sicurezza centrale con il 6% di margine sui quattro lati, e lasciare vuoto l'angolo in basso a destra. Poi riservare nell'inquadratura una zona pulita su cui appoggiare più tardi un titolo.
Parti da una foto di provino: è la base dell'intero set
La parte più difficile di tutto il lavoro è che la persona nelle otto miniature deve essere la stessa.
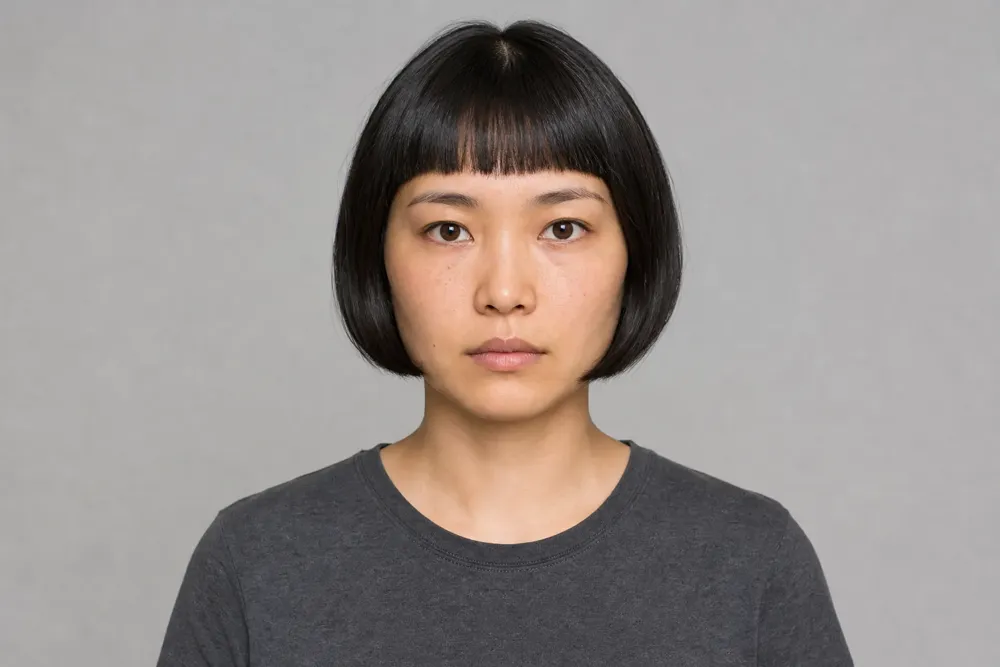
Il mio metodo è stato produrre prima un fotogramma di riferimento pulito con la generazione di immagini IA: frontale, all'altezza degli occhi, senza trucco, senza espressione, fondo grigio, luce piatta e uniforme, come una foto di provino. Quell'immagine non ha alcun fascino e non è mai stata pensata per la pubblicazione. Il suo unico compito è fare da riferimento a tutti i fotogrammi successivi.
E qui arriva l'errore.
Nella prima passata avevo bloccato anche la composizione. Soggetto nel terzo sinistro, contorno bianco ritagliato attorno a lei, un raggiera dietro la testa, un blocco piatto di colore a riempire la metà destra. Potevano cambiare solo l'espressione e il colore di fondo. Otto immagini dopo il volto non era slittato di un millimetro, e il set sembrava una tabella di emozioni più che otto miniature. Altra faccia, altro colore, nient'altro.
Il motivo è semplice. Una miniatura vera si progetta attorno all'argomento del video, e l'unica variabile che avevo dato al modello era un'espressione facciale. Non c'era nulla da progettare, così ha ripetuto il mio schema otto volte.
La correzione è stata restituirgli la progettazione. Il blocco fisso ora blocca soltanto ciò che va bloccato: la stessa persona, il volto illuminato e non coperto, busto nell'inquadratura. Ambientazione, oggetti di scena, elementi grafici, palette, luce, profondità e inquadratura sono decisione del modello. Il blocco variabile è diventato una sola frase: di cosa parla questo video.
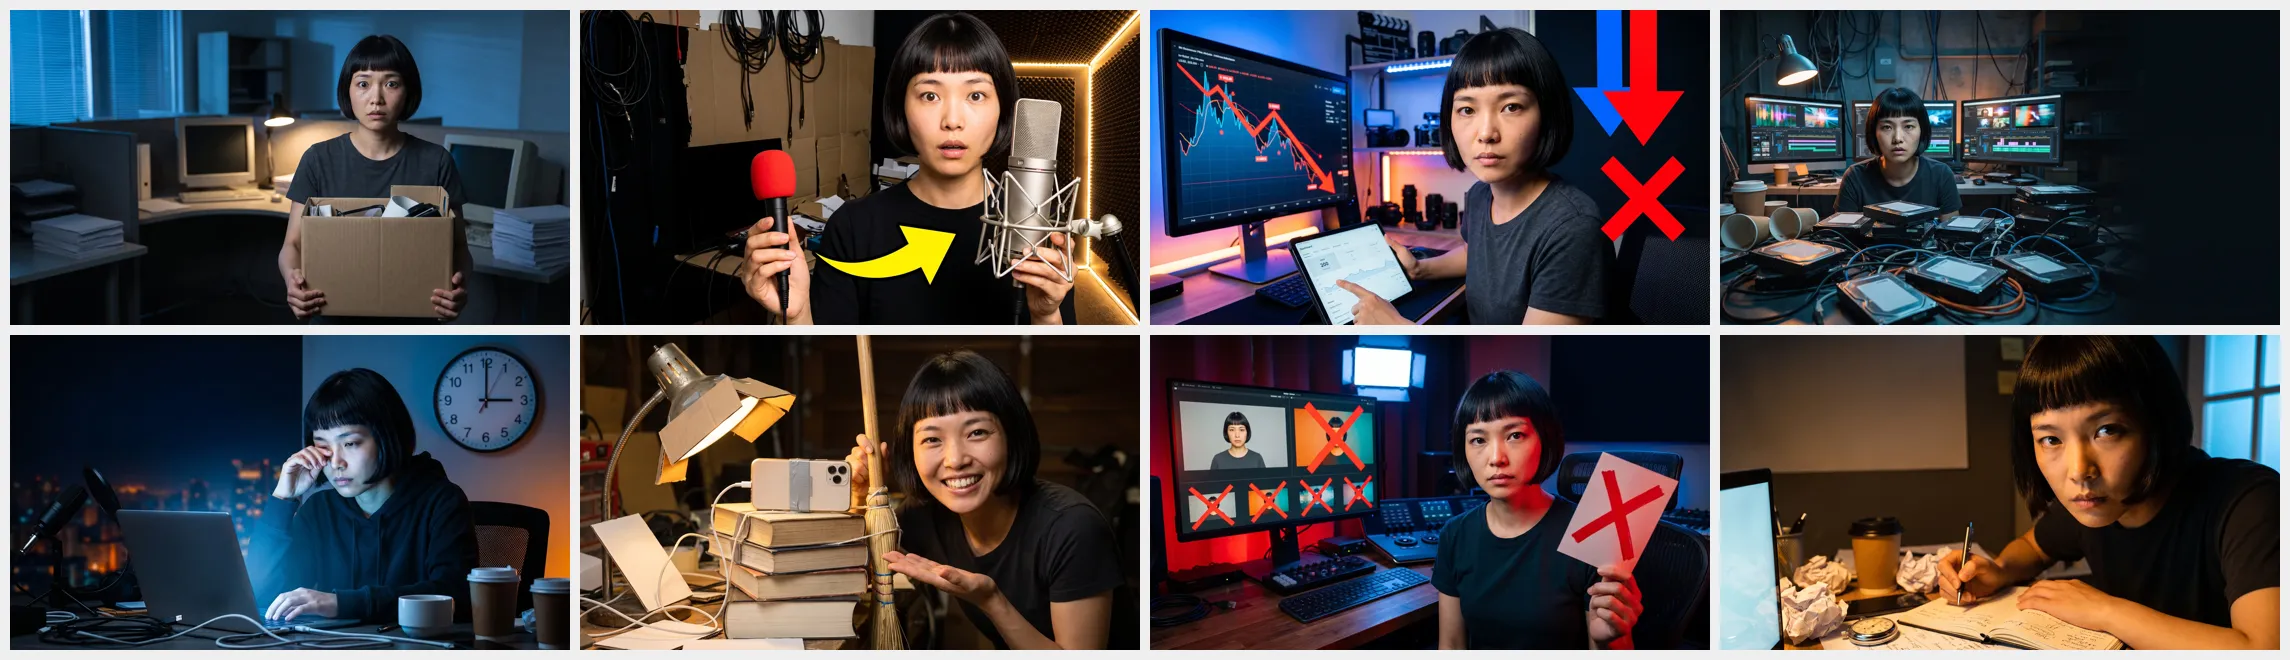
Le otto variabili erano: lasciare il lavoro d'ufficio, un microfono da trenta euro che batte uno da trecento, essere fermi a duecento visualizzazioni, montare cento video in una settimana, pubblicare alle tre di notte per un mese, un set di ripresa completo che costa meno di un telefono, cinque preset di colore da smettere di usare, e scrivere un copione in dodici minuti.
Quello che è tornato non gioca nello stesso campionato della prima passata. Una freccia gialla tra un microfono a mano rosso e un condensatore. Una linea rossa che precipita su un monitor con una croce rossa accanto. Una fila di anteprime di preset barrate una a una. Un orologio da parete contro lo skyline notturno alle tre. Niente di quel linguaggio grafico era nel mio prompt: l'ha inventato tutto il modello di immagini IA.
Credevo non sapesse scrivere. Sa scrivere.
Sulla generazione di immagini IA circola molto un consiglio: i modelli non sanno produrre testo leggibile, quindi qualsiasi scritta in uscita risulterà sfasata. Lo seguivo, e ogni prompt finiva con l'istruzione di tenere il testo fuori dall'inquadratura.
Alla fine ho provato e ho chiesto al modello di scrivere il titolo direttamente nella zona libera.
L'ha scritto giusto. Nemmeno una lettera sbagliata, forme pulite, peso adeguato, andate a capo sensate su tre righe. Quella vecchia regola non regge più davvero con i modelli di immagini IA di oggi.
Non ho comunque cambiato idea, perché il secondo test ha svelato il problema vero. Ho sostituito 200 con 500 nel titolo, senza toccare nessun'altra parola, e ho rilanciato. Il testo era ancora corretto, ma l'intera scena era stata rimontata: da seduta di profilo passa a inquadrata frontalmente al centro, il monitor si sposta dal margine sinistro a dietro di lei, e la tipografia cambia dimensione e posizione di conseguenza. Messe fianco a fianco, le due immagini non appartengono allo stesso set.
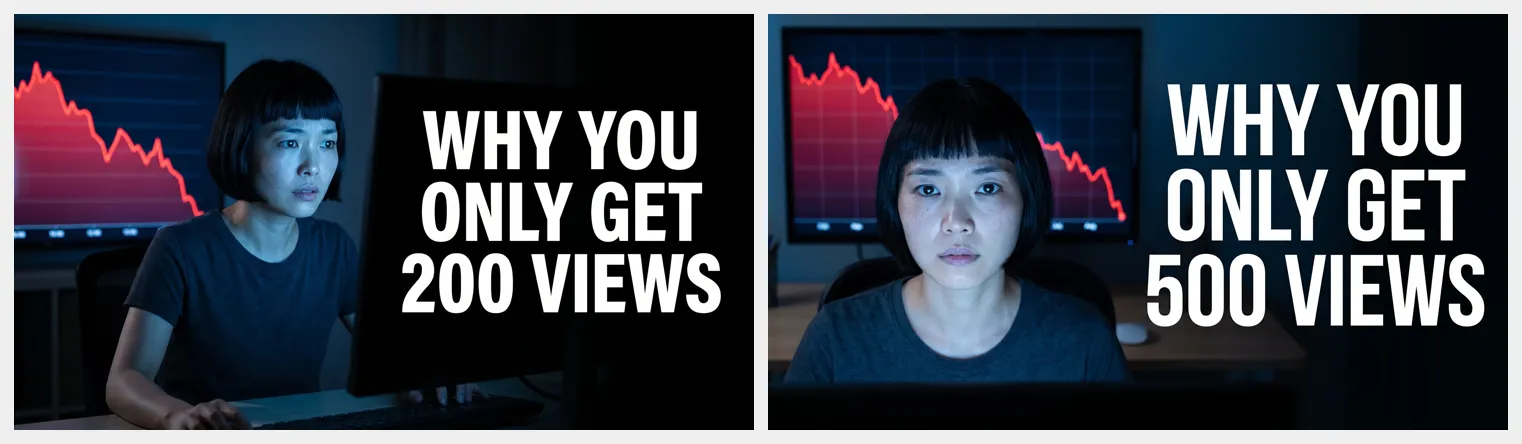
La conclusione quindi regge, ma cambia la ragione. Il problema non è che non sappia scrivere, è che l'impaginazione non è riproducibile. Se stai facendo un set intero di miniature YouTube e prevedi di cambiare i titoli o di testarli in A/B più avanti, tieni il testo fuori dall'immagine e sovrapponilo a parte. Per un pezzo unico che non toccherai più, lasciarlo scrivere al modello ti risparmia un passaggio.
Le quattro che ho buttato
Cedere la direzione artistica a un modello di immagini IA ha un costo: mette volentieri nell'inquadratura cose che non hai mai chiesto. Quattro rifacimenti, tre difetti distinti.
Marchi reali. Nell'immagine sul lasciare il lavoro le ha messo in mano un microfono con il nome di un produttore reale stampato sul fianco. In quella dei cento montaggi ha appoggiato sulla scrivania due lattine di energy drink riconoscibili all'istante. Nessuna delle due cose può stare in un'immagine destinata alla pubblicazione.
Soggetto duplicato. Ho aggiunto una clausola contro i marchi e ho rilanciato l'immagine sul lasciare il lavoro: mi sono ritrovato due copie di lei, una che digita alla scrivania e una in piedi accanto con uno scatolone in braccio. Il modello aveva letto "lasciare l'ufficio" come una scena che richiede due attrici.
Testo sugli oggetti di scena. Nell'immagine del set economico ha scritto ordinatamente due parole inglesi sullo scatolone. Qui è il difetto che pesa di più: queste immagini sono condivise fra 21 lingue, quindi del testo in una sola lingua diventa rumore per i lettori delle altre venti.
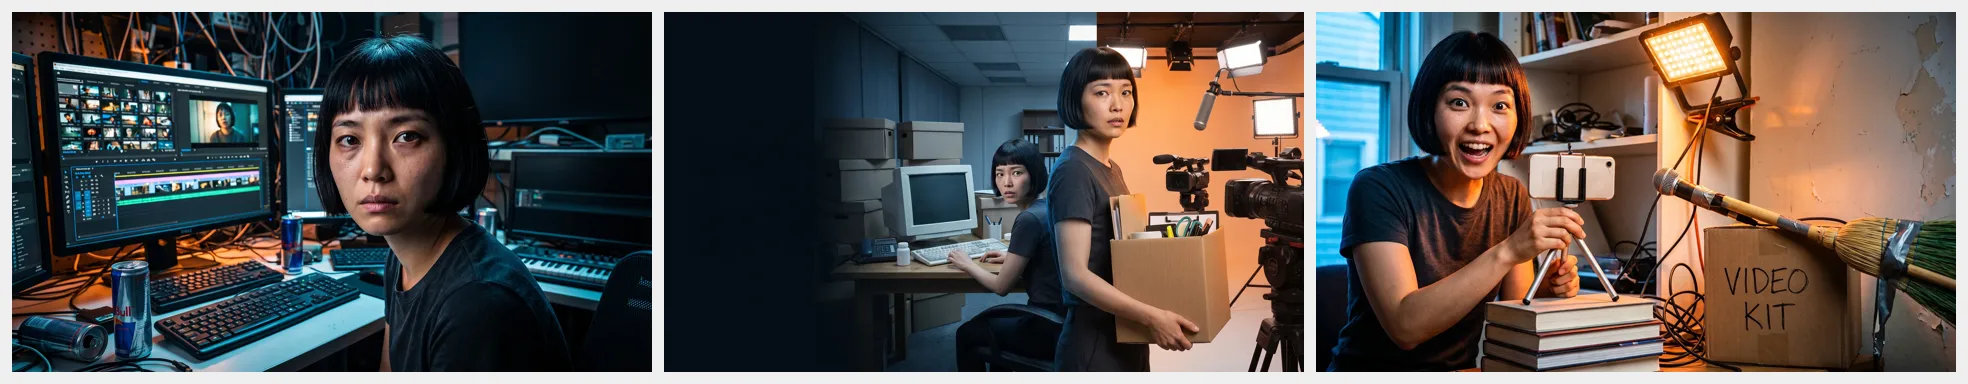
Tutte e tre sono diventate clausole del blocco fisso, e vanno scritte in modo specifico. "Niente testo" non basta: bisogna dire nessuna scritta su schermi, confezioni, etichette, attrezzature o insegne. Nemmeno "una sola persona" basta; va escluso anche un suo secondo esemplare, un riflesso e un suo ritratto sullo sfondo.
Una struttura di prompt da copiare
Il blocco fisso viene incollato invariato in ogni prompt, e dice più o meno così.
Usa la stessa persona dell'immagine di riferimento, stessa pettinatura. Deve essere riconoscibile all'istante come la stessa persona, con il volto illuminato, non coperto e grossomodo rivolto verso l'obiettivo, busto nell'inquadratura. Sei il direttore artistico e progetti una miniatura YouTube che deve guadagnarsi un clic a 168 pixel di larghezza: tutto tranne la sua identità lo decidi tu, ambientazione, oggetti di scena, elementi grafici, palette, luce, profondità e inquadratura. Falla audace, ad alto contrasto e specifica per questo argomento, non un ritratto su fondo colorato. Lascia nell'inquadratura una zona pulita per un titolo aggiunto in seguito. Nessun testo, lettera o numero da nessuna parte, nemmeno su schermi, confezioni, etichette, attrezzature o insegne. Nessun logo di marca o marchio riconoscibile; tutti gli oggetti di scena senza marchiatura. Esattamente una persona nell'inquadratura.
Il blocco variabile è una frase: di cosa parla questo video.
Queste ultime tre proibizioni sono state aggiunte tutte dopo un rifacimento, una clausola per difetto. La struttura si trasferisce invariata su altri modelli di immagini IA; cambiano solo le abitudini di formulazione.
Una miniatura, due usi
Una volta chiuse le otto, alle immagini IA restava un ultimo compito. Ho preso quella delle tre di notte come fotogramma iniziale e ho usato la generazione video da primo e ultimo fotogramma per produrre una sigla di cinque secondi.
Anche qui c'è una trappola concreta. La clip generata ha reinquadrato la scena, e la zona pulita che avevo riservato con cura al titolo è stata mangiata quasi del tutto. Per una sigla non importa. Per una card finale bisognerebbe rifare l'impaginazione.
Per far girare un lotto intero in una volta, distribuire gli otto lavori di immagini IA sulla tela generativa conviene più che procedere uno alla volta: si vede a colpo d'occhio cosa tenere e cosa rifare. Se preferisci non scrivere i prompt da zero, in modelli ci sono stili di ritratto da applicare direttamente.
Otto immagini finali in un pomeriggio
L'intero set di miniature YouTube ha richiesto un pomeriggio, dal primo invio agli otto fotogrammi definitivi, con quattro scartati. La parte lenta non è stata né generare né ritoccare, ma capire cosa affidare al modello: all'inizio ho stretto troppo, ho inchiodato la composizione e mi sono ritrovato otto immagini tutte uguali.
Se vuoi riprodurre il procedimento, l'ordine è: misura l'area di sicurezza e le tre dimensioni reali di visualizzazione, genera un fotogramma di riferimento poco attraente ma pulito, riduci il blocco fisso alla persona più quelle poche proibizioni, e tratta l'argomento di ogni immagine come unica variabile. Quanto al testo: per un set aggiungilo dopo, per un pezzo unico lascialo scrivere al modello.
L'intero set di miniature YouTube ha usato esattamente due strumenti di immagini IA, generazione di immagini IA e modifica di immagini IA.