صنعت 8 صور مصغّرة ليوتيوب بالذكاء الاصطناعي: المقاسات والتكوين والأربع التي استبعدتها
اعتماد نقرة المشاهد على الصورة المصغّرة أكبر مما يفترض معظم الناس. أمضيت فترة بعد الظهر كاملة في إنتاج مجموعة من 8 صور مصغّرة ليوتيوب باستخدام توليد الصور بالذكاء الاصطناعي. استبعدت أربعًا منها في الطريق، وجاءت نتيجة تناقض نصيحة كنت أعدّها مسلَّمة، ووقعت في خطأ أعمق يستحق قسمًا خاصًا به.
قِس المواصفات قبل أن تولّد أي شيء
المقاس الموصى به للصورة المصغّرة في يوتيوب هو 1280×720، أي 16:9. كثيرون يعرفون هذا الرقم، لكن هناك أمرين آخرين يؤثران في النتيجة النهائية أكثر منه.
الأول: الركن السفلي الأيمن يغطيه شارة مدة الفيديو. بمقياس 1280×720 تشغل نحو 132×36، وأي عنصر يوضع هناك يفقد نصفه.
الثاني، وهو الأسهل نسيانًا: الصورة المصغّرة لا تُعرض أبدًا بحجمها الأصلي داخل القوائم. الصفحة الرئيسية على الحاسب تعرضها بعرض 360 بكسل تقريبًا، وقائمة التوصيات على الهاتف كثيرًا ما تكتفي بنحو 168 بكسل. صغّرت الصورة المصغّرة نفسها إلى هذه المقاسات الثلاثة ووضعتها جنبًا إلى جنب. عند 360 بكسل تظل الإكسسوارات وتعبير الوجه مقروءة. وعند 168 بكسل لا يبقى سوى بقعة لون وظل بشري.
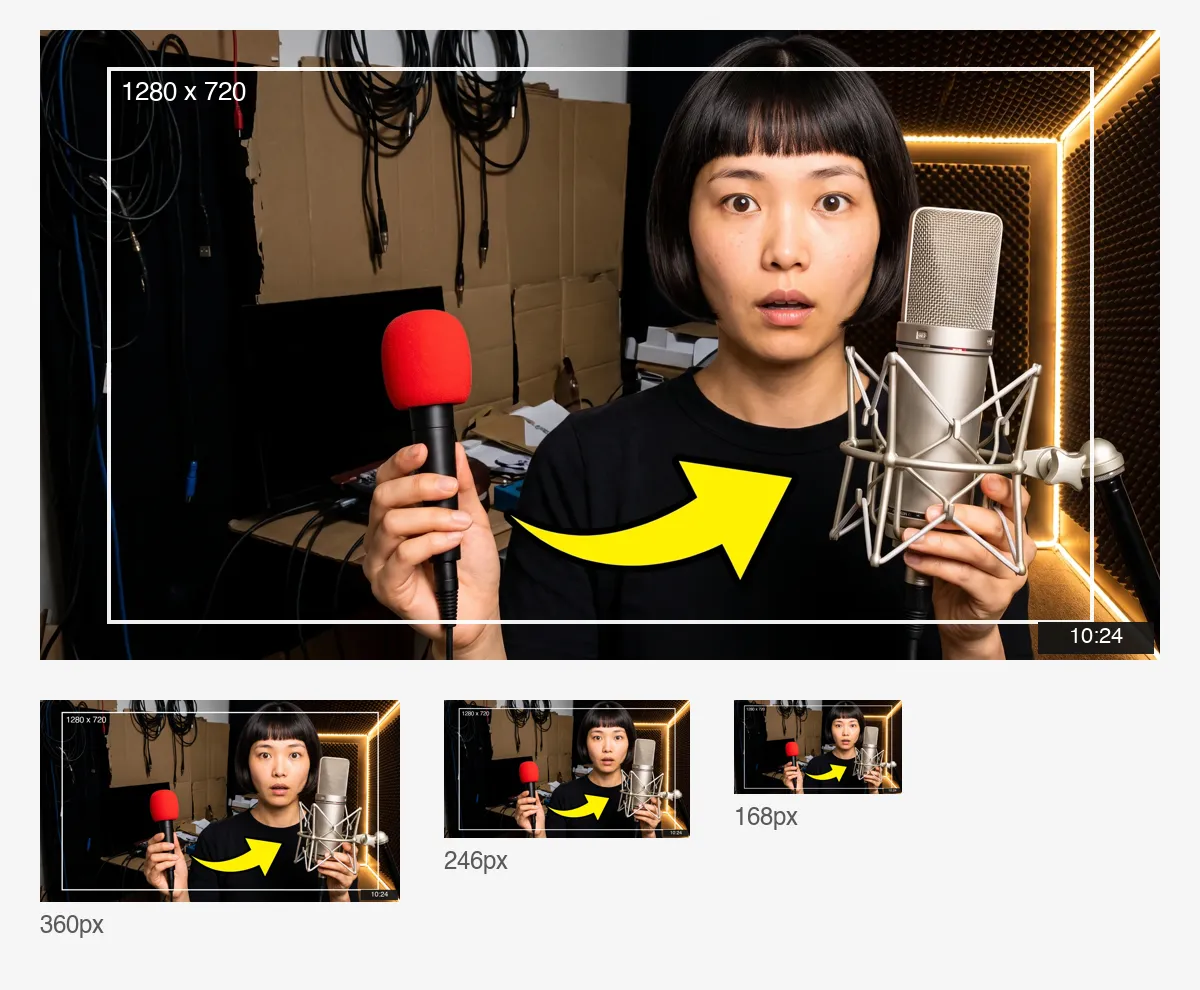
لذلك وضعت قاعدتين قبل أي توليد. إبقاء الشخصية وكل ما يهم داخل منطقة آمنة مركزية بهامش 6% من الجهات الأربع، وترك الركن السفلي الأيمن فارغًا. ثم حجز مساحة نظيفة واحدة داخل الكادر يوضع عليها العنوان لاحقًا.
ابدأ بصورة اختبار أداء — فهي أساس المجموعة كلها
أصعب ما في العمل كله أن الشخص في الصور الثماني يجب أن يكون الشخص نفسه.
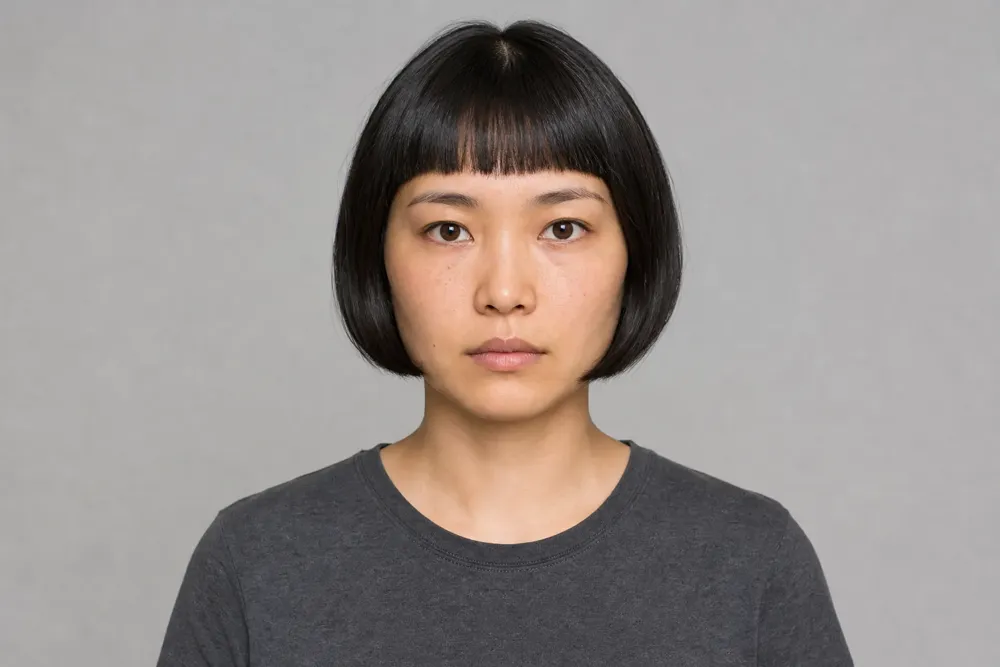
طريقتي كانت إنتاج إطار مرجعي نظيف أولًا عبر توليد الصور بالذكاء الاصطناعي: من الأمام، بمستوى العين، دون مكياج، دون تعبير، خلفية رمادية، إضاءة مسطحة متساوية، أشبه بصورة اختبار أداء. هذه الصورة ليست جذابة إطلاقًا ولم تكن معدّة للنشر. مهمتها الوحيدة أن تكون مرجعًا لكل إطار يليها.
وهنا يأتي الخطأ.
في المحاولة الأولى ثبّتُّ التكوين أيضًا. الشخصية في الثلث الأيسر، حد أبيض مقصوص حولها، أشعة متفجرة خلف رأسها، وكتلة لون مسطحة تملأ النصف الأيمن. المسموح بتغييره هو تعبير الوجه ولون الخلفية فقط. بعد ثماني صور لم ينحرف وجهها قيد أنملة، لكن المجموعة بدت جدول مشاعر لا ثماني صور مصغّرة. وجه مختلف، لون مختلف، ولا شيء غير ذلك.
السبب بسيط. الصورة المصغّرة الحقيقية تُصمَّم حول موضوع الفيديو، والمتغير الوحيد الذي أعطيته للنموذج كان تعبير وجه. لم يكن أمامه ما يصممه، فكرّر قالبي ثماني مرات.
كان الإصلاح أن أعيد إليه قرار التصميم. الكتلة الثابتة صارت تقيّد ما يجب تقييده فقط: الشخص نفسه، وجهها مضاء وغير محجوب، والجزء العلوي من الجسم داخل الكادر. أما المكان والإكسسوارات والعناصر الرسومية ولوحة الألوان والإضاءة والعمق والتكوين فكلها قرار النموذج. وصارت الكتلة المتغيرة جملة واحدة: عمّ يتحدث هذا الفيديو.
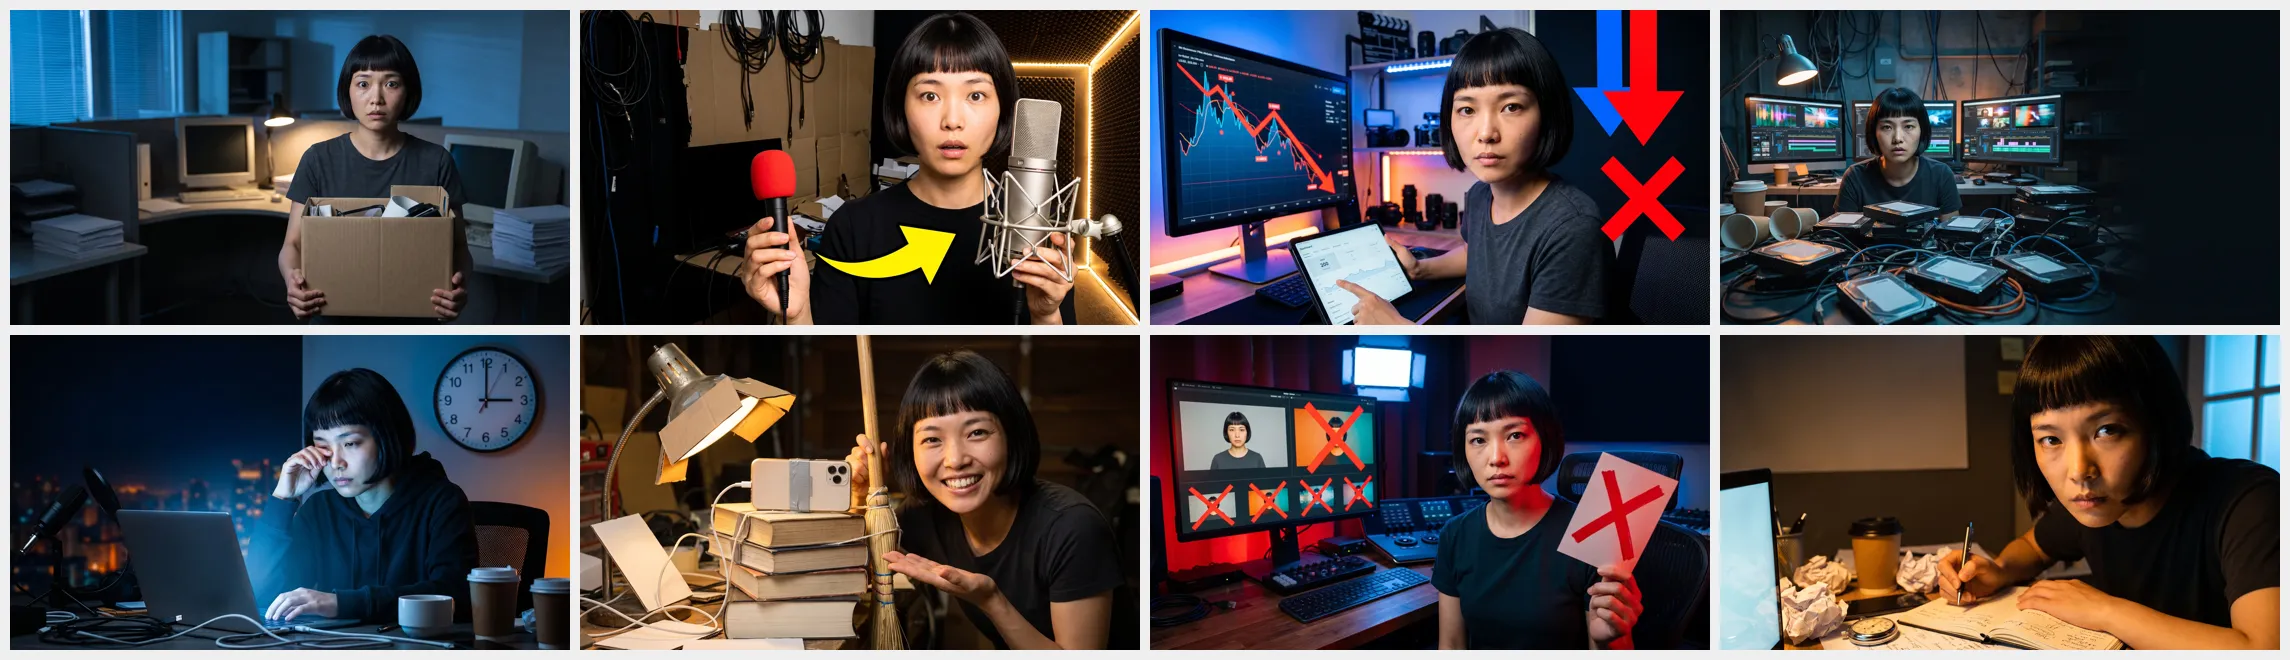
المتغيرات الثمانية كانت: ترك الوظيفة المكتبية، ميكروفون بثلاثين دولارًا يتفوق على آخر بثلاثمئة، التوقف عند مئتي مشاهدة، مونتاج مئة فيديو في أسبوع، النشر عند الثالثة فجرًا لمدة شهر، عدّة تصوير كاملة أرخص من هاتف، خمسة إعدادات ألوان يجب التوقف عن استخدامها، وكتابة نص في اثنتي عشرة دقيقة.
ما عاد إليّ لا يقارن بالمحاولة الأولى. سهم أصفر بين ميكروفون يدوي أحمر وآخر مكثّف. خط أحمر ينهار عبر الشاشة وإلى جانبه علامة خطأ حمراء. صف من معاينات الإعدادات مشطوب واحدًا تلو الآخر. ساعة حائط أمام أفق المدينة ليلًا عند الثالثة فجرًا. لم يكن شيء من هذه اللغة البصرية في موجّهي؛ ابتكرها نموذج الصور بالذكاء الاصطناعي بنفسه.
ظننت أنه لا يكتب نصًا. لكنه يكتب.
تتردد نصيحة شائعة عن توليد الصور بالذكاء الاصطناعي: النماذج لا تستطيع كتابة نص مقروء، فأي حروف في المخرجات ستخرج مشوّهة. كنت ألتزم بها، وكل موجّه ينتهي بتعليمة تمنع ظهور النص داخل الكادر.
في النهاية جرّبت وطلبت من النموذج كتابة العنوان مباشرة في المساحة الخالية.
كتبه صحيحًا. ولا حرف خاطئ، أشكال نظيفة، وزن مناسب، وفواصل أسطر منطقية عبر ثلاثة أسطر. تلك القاعدة القديمة لم تعد صامدة فعليًا مع نماذج الصور بالذكاء الاصطناعي اليوم.
لكنني لم أغيّر رأيي، لأن الاختبار الثاني كشف المشكلة الحقيقية. غيّرت 200 إلى 500 في العنوان دون المساس بأي كلمة أخرى، وأعدت التشغيل. بقي النص صحيحًا، لكن الكادر كله أُعيد إخراجه: انتقلت من جلسة جانبية إلى مواجهة الكاميرا في المنتصف، وانتقلت الشاشة من أقصى اليسار إلى خلفها مباشرة، وتغيّر حجم الخط وموضعه تبعًا لذلك. وضعهما جنبًا إلى جنب يكشف أنهما لا ينتميان إلى مجموعة واحدة.
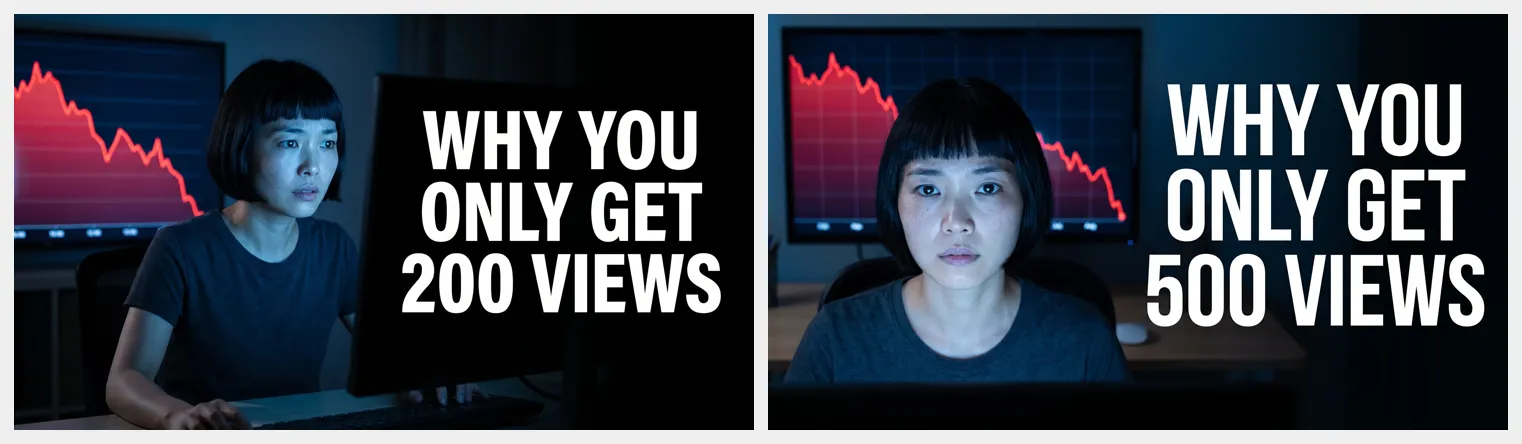
إذن الخلاصة تصمد لكن سببها تغيّر. المشكلة ليست عجزه عن الكتابة، بل أن التخطيط غير قابل للتكرار. إن كنت تنتج مجموعة كاملة من الصور المصغّرة ليوتيوب وتتوقع تبديل العناوين أو اختبارها لاحقًا، فأبقِ النص خارج الصورة وضعه في طبقة منفصلة. أما للصورة الواحدة التي لن تعود إليها، فترك النموذج يكتبها يوفّر عليك خطوة.
الأربع التي استبعدتها
تسليم قرار التصميم لنموذج صور بالذكاء الاصطناعي له ثمن: سيضع في الكادر بارتياح أشياء لم تطلبها. أربع إعادات، وثلاثة أنواع من الأخطاء.
علامات تجارية حقيقية. في صورة ترك الوظيفة وضع في يدها ميكروفونًا مطبوعًا على جانبه اسم مصنّع حقيقي. وفي صورة المئة مونتاج وضع على المكتب علبتي مشروب طاقة يمكن تمييزهما فورًا. وكلاهما لا مكان له في صورة ستُنشر.
تكرار الشخصية. أضفت بندًا يمنع العلامات التجارية وأعدت تشغيل صورة ترك الوظيفة، فحصلت على نسختين منها: واحدة تطبع على المكتب، وأخرى واقفة بجانبها تحمل صندوقًا كرتونيًا. قرأ النموذج عبارة "مغادرة المكتب" على أنها مشهد يحتاج ممثلتين.
ظهور نص على الإكسسوارات. في صورة العدّة الرخيصة كتب كلمتين إنجليزيتين بعناية على الصندوق الكرتوني. وهذا أثقل الأخطاء هنا: الصور مشتركة بين 21 لغة، فوجود نص بلغة واحدة يصبح ضجيجًا لقرّاء اللغات العشرين الأخرى.
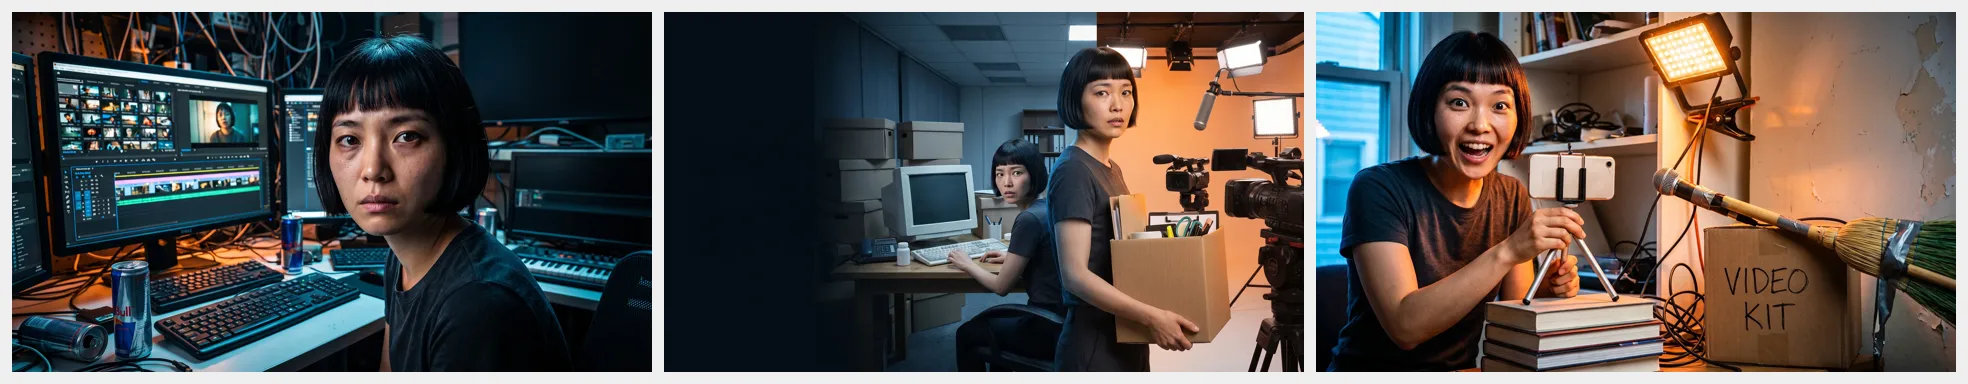
دخلت الثلاثة جميعًا في الكتلة الثابتة لاحقًا، ويجب أن تُصاغ بدقة. عبارة "بلا نص" لا تكفي، بل يجب أن تنص على منع الحروف على الشاشات والعبوات والملصقات والمعدات واللافتات. وعبارة "شخص واحد" لا تكفي أيضًا؛ يجب استبعاد نسخة ثانية منها، وانعكاسها، وصورة شخصية لها في الخلفية.
بنية موجّه يمكنك نسخها
تُلصق الكتلة الثابتة دون تغيير في كل موجّه، ونصها تقريبًا كالتالي.
استخدم الشخص نفسه من الصورة المرجعية، والتسريحة نفسها. يجب أن تُعرف فورًا أنها الشخص نفسه، بوجه مضاء غير محجوب متجه تقريبًا نحو الكاميرا، والجزء العلوي من الجسم داخل الكادر. أنت المدير الفني وتصمم صورة مصغّرة ليوتيوب عليها أن تكسب نقرة بعرض 168 بكسل — كل شيء عدا هويتها متروك لك: المكان والإكسسوارات والعناصر الرسومية ولوحة الألوان والإضاءة والعمق والتكوين. اجعلها جريئة وعالية التباين وخاصة بهذا الموضوع، لا صورة شخصية على خلفية ملوّنة. اترك داخل الكادر مساحة نظيفة لعنوان يُضاف لاحقًا. ممنوع أي نص أو حروف أو أرقام في أي مكان، بما في ذلك الشاشات والعبوات والملصقات والمعدات واللافتات. ممنوع أي شعار تجاري أو علامة تجارية يمكن تمييزها؛ وكل الإكسسوارات دون أي علامات. شخص واحد بالضبط داخل الكادر.
أما الكتلة المتغيرة فجملة واحدة: عمّ يتحدث هذا الفيديو.
هذه المحظورات الثلاثة الأخيرة أضيفت جميعًا بعد إعادة، بندٌ مقابل كل خطأ. والبنية تنتقل كما هي إلى نماذج صور أخرى بالذكاء الاصطناعي؛ ما يختلف هو عادات الصياغة فقط.
صورة مصغّرة واحدة تُستخدم مرتين
بعد تثبيت الصور الثماني، بقيت للصور المولّدة بالذكاء الاصطناعي مهمة أخيرة. أخذت صورة الثالثة فجرًا كإطار بداية، واستعملت توليد الفيديو من الإطار الأول والأخير لإنتاج مقدمة مدتها خمس ثوانٍ.
وهنا أيضًا مطبّ حقيقي. أعاد المقطع المولّد تأطير المشهد، فالتهم معظم المساحة النظيفة التي حجزتها بعناية للعنوان. هذا لا يهم في مقدمة، أما في بطاقة نهاية فسيتطلب إعادة تخطيط.
لتشغيل دفعة كاملة مرة واحدة، فردُ مهام الصور الثماني على اللوحة التوليدية أفضل من العمل واحدة تلو الأخرى؛ ترى بلمحة ما تبقيه وما تعيده. وإن كنت تفضّل ألا تكتب الموجّهات من الصفر، ففي القوالب أنماط بورتريه جاهزة للتطبيق مباشرة.
ثماني صور نهائية في فترة بعد ظهر واحدة
استغرقت مجموعة الصور المصغّرة ليوتيوب كاملةً فترة بعد ظهر واحدة، من أول تشغيل حتى ثماني صور مثبّتة، مع استبعاد أربع. لم يكن البطء في التوليد ولا في المعالجة، بل في إدراك ما ينبغي تسليمه للنموذج: أمسكت الأمور بقبضة شديدة في البداية، وثبّتُّ التكوين، فحصلت على ثماني صور متشابهة.
إن أردت تكرار التجربة، فالترتيب هو: قِس المنطقة الآمنة ومقاسات العرض الثلاثة الفعلية، ثم ولّد إطارًا مرجعيًا غير جذاب لكنه نظيف، ثم اختصر الكتلة الثابتة إلى الشخصية مع تلك المحظورات القليلة، وعامل موضوع كل صورة بوصفه المتغير الوحيد. أما النص فأضفه لاحقًا إن كانت مجموعة، ودع النموذج يكتبه إن كانت صورة واحدة.
لم تحتج مجموعة الصور المصغّرة ليوتيوب كاملةً سوى أداتين للصور بالذكاء الاصطناعي: توليد الصور بالذكاء الاصطناعي وتحرير الصور بالذكاء الاصطناعي.