Zrobiłem 8 miniatur na YouTube z pomocą AI: wymiary, kadr i cztery, które wyrzuciłem
To, czy ktoś kliknie w film, zależy od miniatury bardziej, niż się powszechnie sądzi. Spędziłem popołudnie na wyprodukowaniu pełnego zestawu 8 miniatur na YouTube przy użyciu generowania obrazów AI. Cztery po drodze wylądowały w koszu, jeden wynik obalił radę, którą uważałem za pewnik, a ja popełniłem bardziej zasadniczy błąd, który zasługuje na osobną sekcję.
Najpierw zmierz wymagania, potem generuj
Zalecany rozmiar miniatury na YouTube to 1280×720, czyli 16:9. Tę liczbę zna wielu. Na końcowy efekt mocniej wpływają dwie inne rzeczy.
Po pierwsze, prawy dolny róg zasłania plakietka z długością filmu. W przeliczeniu na 1280×720 zajmuje około 132×36, a wszystko, co się tam położy, traci połowę siebie.
Po drugie, i o tym łatwiej zapomnieć: miniatury nigdy nie są wyświetlane w pełnym rozmiarze na liście. Strona główna na komputerze pokazuje je przy szerokości około 360px, a mobilny kanał rekomendacji często poprzestaje na jakichś 168px. Zmniejszyłem tę samą miniaturę na YouTube do wszystkich trzech rozmiarów i ustawiłem obok siebie. Przy 360px rekwizyty i wyraz twarzy nadal są czytelne. Przy 168px zostaje tylko plama koloru i ludzka sylwetka.
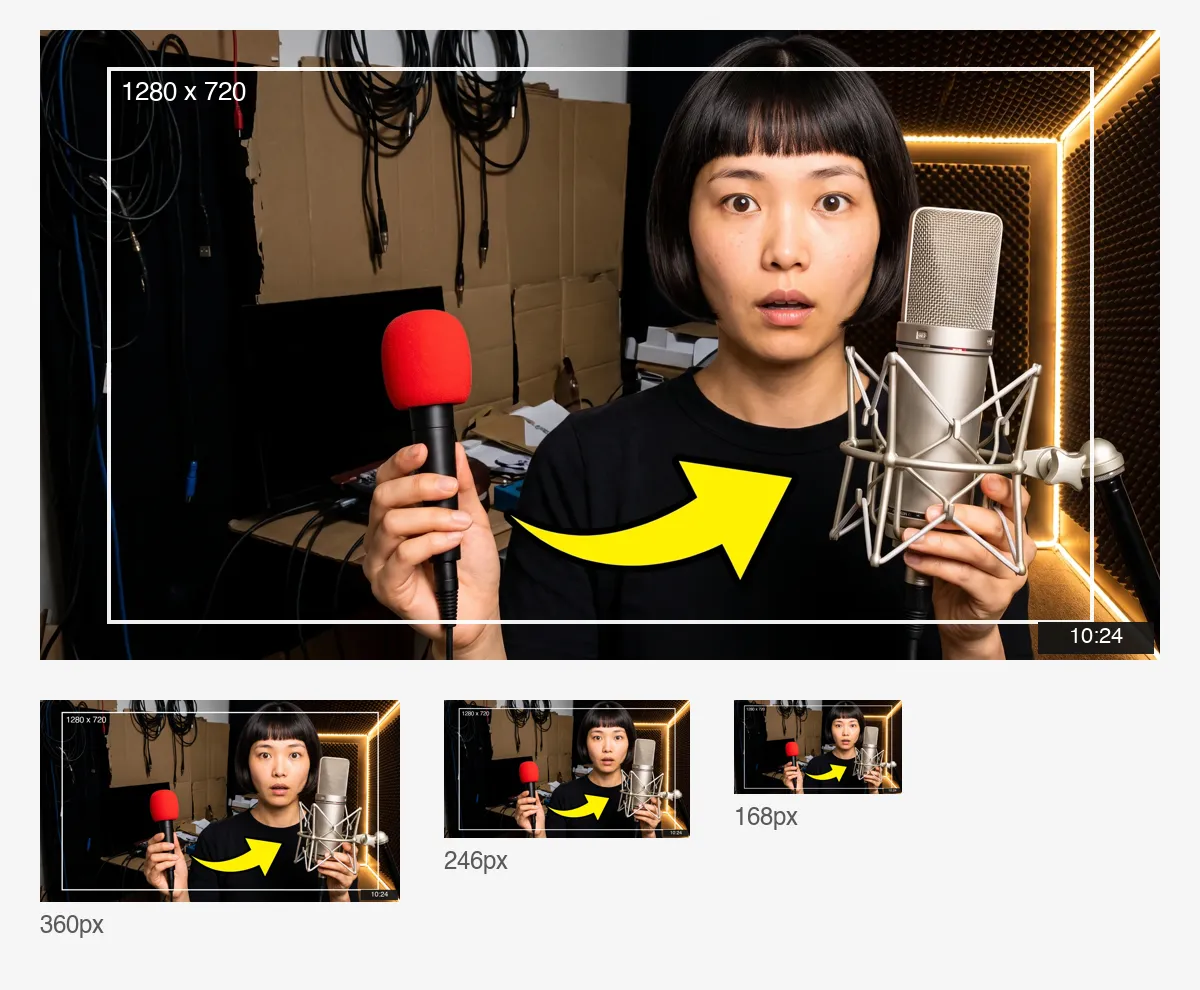
Dlatego przed pierwszym generowaniem ustaliłem dwie zasady. Trzymaj bohaterkę i wszystko, co istotne, w centralnym bezpiecznym obszarze z 6% marginesem ze wszystkich stron, a prawy dolny róg zostaw pusty. I zarezerwuj w kadrze jeden czysty obszar, na który później trafi nagłówek.
Zacznij od zdjęcia castingowego — to fundament całego zestawu
Najtrudniejsze w całej robocie jest to, że osoba na wszystkich ośmiu miniaturach musi być tą samą osobą.
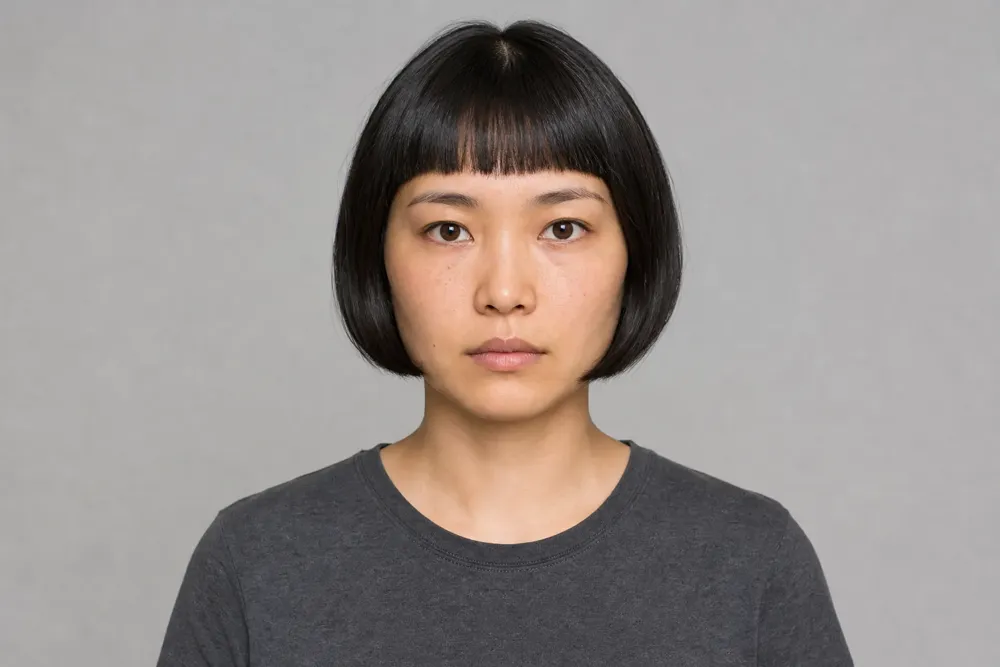
Moje podejście: najpierw jedna czysta klatka referencyjna z generowania obrazów AI — na wprost, na wysokości oczu, bez makijażu, bez wyrazu twarzy, szare tło, płaskie równomierne światło, jak zdjęcie castingowe. Ten obraz nie jest atrakcyjny i nigdy nie był przeznaczony do publikacji. Jego jedynym zadaniem jest być referencją dla każdej kolejnej klatki.
I tu pojawia się błąd.
W pierwszym podejściu przygwoździłem także kompozycję. Postać w lewej jednej trzeciej, biały kontur wycięcia wokół niej, wybuch promieni za głową, płaski blok koloru wypełniający prawą połowę. Zmieniać mogły się wyłącznie wyraz twarzy i kolor tła. Osiem obrazów później jej twarz nie odpłynęła ani o włos, a zestaw wyglądał jak tabela emocji, a nie osiem miniatur. Inna mina, inny kolor i tyle.
Powód jest prosty. Prawdziwą miniaturę projektuje się wokół tematu filmu, a jedyną zmienną, którą dałem modelowi, była mimika. Nie było czego projektować, więc powtórzył mój szablon osiem razy.
Poprawka polegała na oddaniu projektowania modelowi. Blok stały blokuje teraz tylko to, co zablokować trzeba: ta sama osoba, twarz oświetlona i niezasłonięta, górna część sylwetki w kadrze. Sceneria, rekwizyty, elementy graficzne, paleta, światło, głębia i kadrowanie to decyzja modelu. Blok zmienny zamienił się w jedno zdanie: o czym jest ten film.
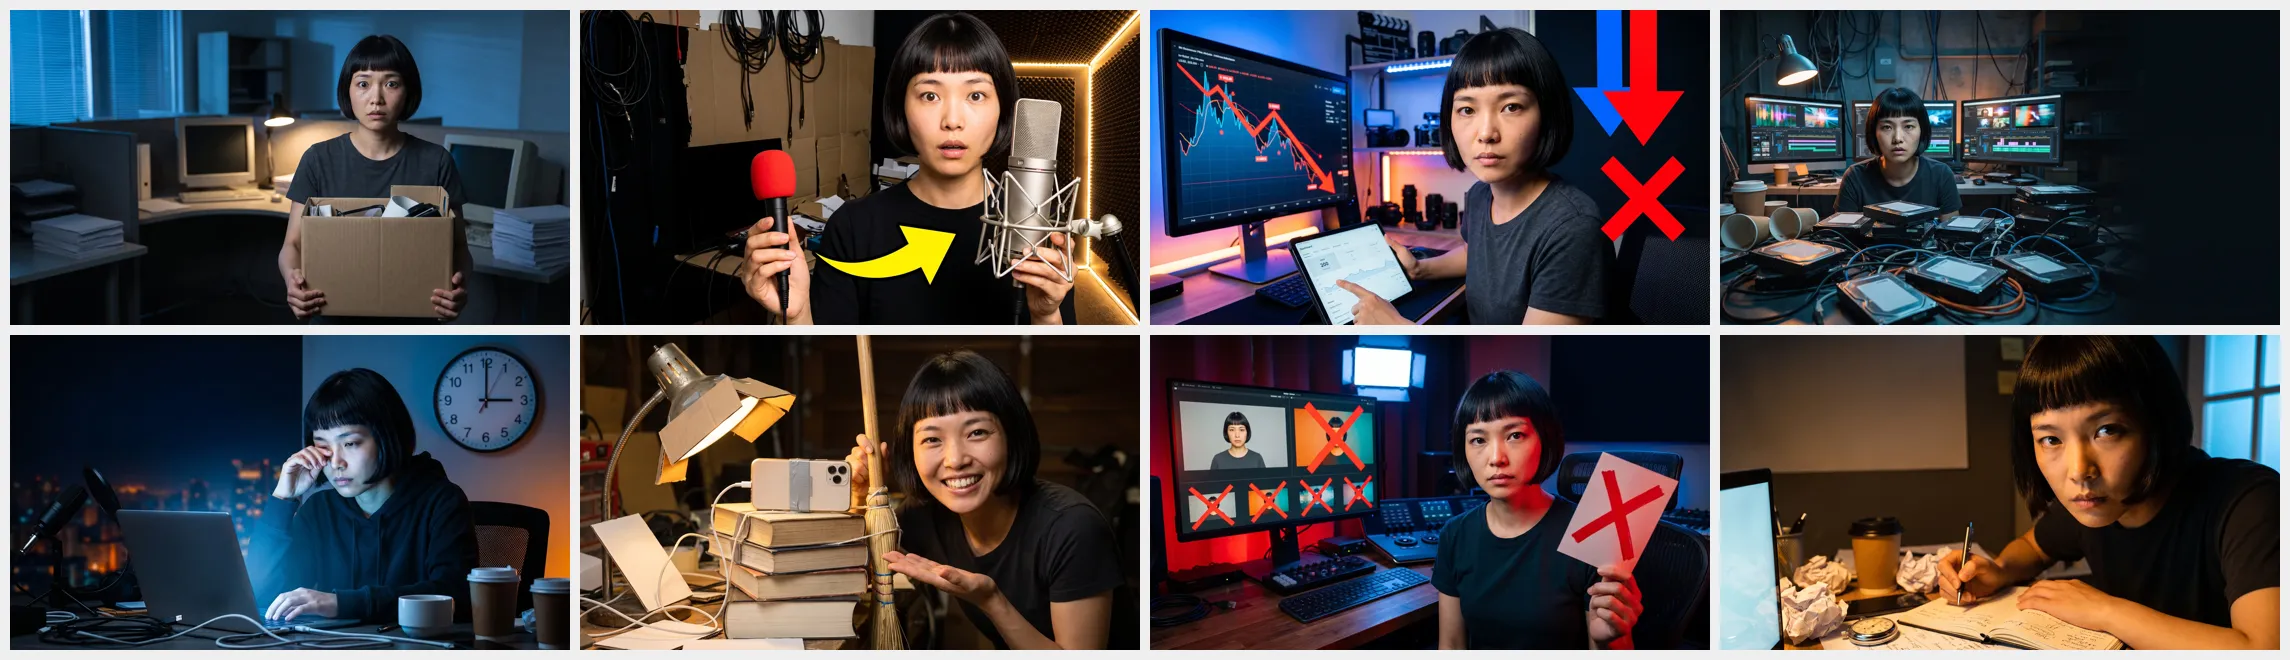
Osiem zmiennych brzmiało tak: rzucić pracę biurową, mikrofon za sto złotych bijący ten za tysiąc, utknąć na dwustu wyświetleniach, zmontować sto filmów w tydzień, publikować przez miesiąc o trzeciej nad ranem, cały zestaw do nagrywania tańszy niż telefon, pięć presetów kolorystycznych, z których trzeba przestać korzystać, i napisać scenariusz w dwanaście minut.
To, co wróciło, nie gra w tej samej lidze co pierwsze podejście. Żółta strzałka między czerwonym mikrofonem ręcznym a pojemnościowym. Czerwona linia załamująca się na monitorze i czerwony krzyżyk obok. Rząd miniatur presetów przekreślonych jedna po drugiej. Zegar ścienny na tle nocnej panoramy miasta o trzeciej. Nic z tego języka graficznego nie było w moim poleceniu — model obrazów AI wymyślił to wszystko sam.
Myślałem, że nie potrafi pisać. Potrafi.
O generowaniu obrazów AI krąży często powtarzana rada: modele nie umieją składać czytelnego tekstu, więc każdy napis w wyniku wyjdzie zniekształcony. Trzymałem się jej, a każde polecenie kończyło się instrukcją, żeby w kadrze nie było tekstu.
Na koniec sprawdziłem to i poprosiłem model, żeby wpisał nagłówek prosto w wolny obszar.
Napisał poprawnie. Ani jednej błędnej litery, czyste kształty, sensowna grubość, sensowne łamanie w trzech wierszach. Ta stara zasada przy dzisiejszych modelach obrazów AI już właściwie nie obowiązuje.
Zdania jednak nie zmieniłem, bo drugi test obnażył prawdziwy problem. Zmieniłem w nagłówku 200 na 500, nie ruszając żadnego innego słowa, i uruchomiłem ponownie. Tekst nadal był poprawny, ale cały kadr został zainscenizowany od nowa: bohaterka z pozycji siedzącej z profilu przeszła na ujęcie na wprost, na środku, monitor przewędrował od lewej krawędzi wprost za jej plecy, a typografia zmieniła rozmiar i pozycję razem z tym. Zestawione obok siebie te dwa obrazy nie należą do jednego zestawu.
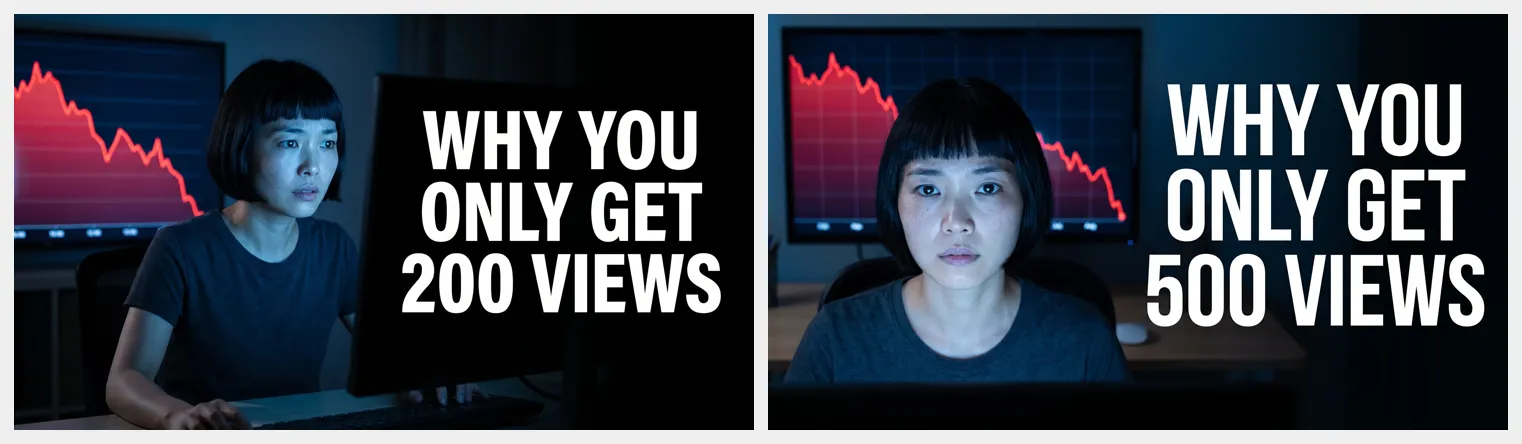
Wniosek więc się broni, ale zmienia się uzasadnienie. Problemem nie jest to, że model nie umie pisać, tylko że układ nie jest odtwarzalny. Jeśli robisz cały zestaw miniatur na YouTube i zamierzasz później podmieniać nagłówki albo testować je w A/B, trzymaj tekst poza obrazem i nakładaj go osobno. Przy pojedynczym obrazie, którego już nie ruszysz, pozwolenie modelowi na napisanie tekstu oszczędza jeden krok.
Cztery, które wyrzuciłem
Oddanie decyzji projektowych modelowi obrazów AI ma swoją cenę: chętnie wstawi do kadru rzeczy, o które nigdy nie prosiłeś. Cztery poprawki, trzy różne usterki.
Prawdziwe marki. Na obrazie o rzuceniu pracy włożył jej w ręce mikrofon z nazwą istniejącego producenta wydrukowaną z boku. Na obrazie ze stoma montażami postawił na biurku dwie natychmiast rozpoznawalne puszki napoju energetycznego. Żadna z tych rzeczy nie może znaleźć się w obrazie przeznaczonym do publikacji.
Zduplikowana bohaterka. Dodałem klauzulę zakazującą marek i uruchomiłem obraz o rzuceniu pracy jeszcze raz — dostałem ją w dwóch egzemplarzach: jedna pisze przy biurku, druga stoi obok z kartonowym pudłem w rękach. Model odczytał "wyjść z biura" jako scenę wymagającą dwóch aktorek.
Tekst na rekwizytach. Na obrazie z tanim zestawem starannie napisał na kartonie dwa angielskie słowa. To waży tu najwięcej: te obrazy są wspólne dla 21 języków, więc tekst w jednym z nich staje się szumem dla czytelników pozostałych dwudziestu.
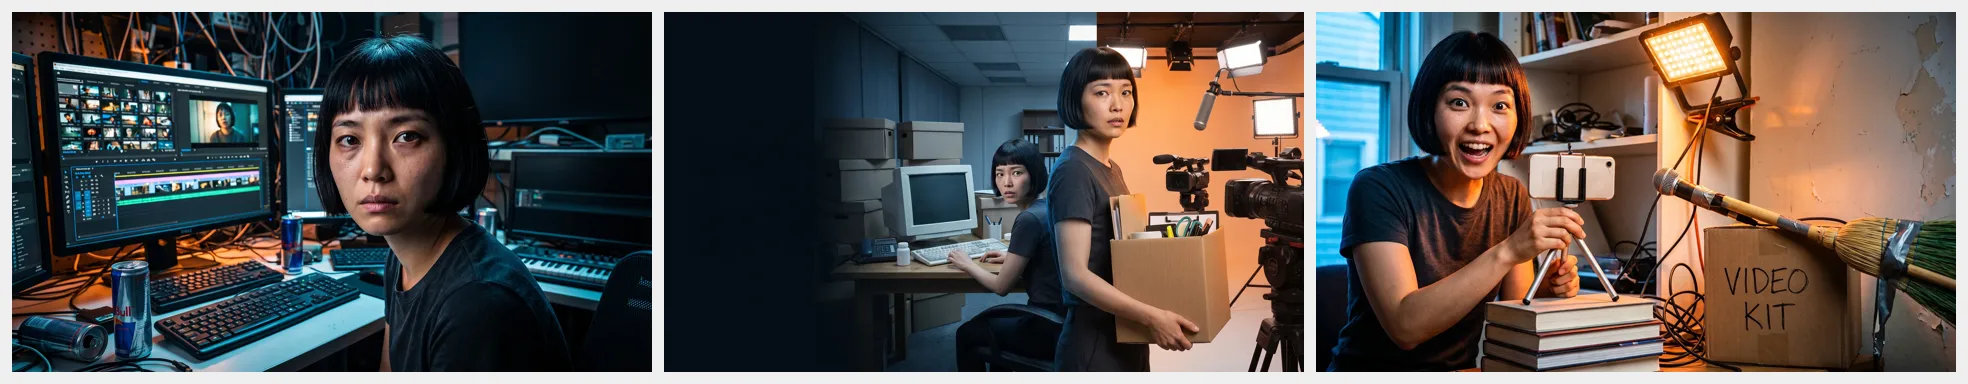
Wszystkie trzy trafiły potem do bloku stałego i muszą być sformułowane konkretnie. "Bez tekstu" nie wystarczy — trzeba napisać: żadnych napisów na ekranach, opakowaniach, etykietach, sprzęcie ani szyldach. "Jedna osoba" też nie wystarczy; trzeba dodatkowo wykluczyć jej drugi egzemplarz, odbicie oraz jej portret w tle.
Struktura polecenia do skopiowania
Blok stały wkleja się bez zmian do każdego polecenia i brzmi mniej więcej tak.
Użyj tej samej osoby co na obrazie referencyjnym, ta sama fryzura. Musi być natychmiast rozpoznawalna jako ta sama osoba, twarz oświetlona, niezasłonięta i mniej więcej zwrócona do obiektywu, górna część sylwetki w kadrze. Jesteś dyrektorem artystycznym i projektujesz miniaturę na YouTube, która musi zapracować na kliknięcie przy szerokości 168 pikseli — wszystko poza jej tożsamością zależy od ciebie: sceneria, rekwizyty, elementy graficzne, paleta, światło, głębia i kadrowanie. Zrób to odważnie, kontrastowo i konkretnie pod ten temat, a nie jako portret na kolorowym tle. Zostaw w kadrze czysty obszar na nagłówek dodany później. Nigdzie żadnego tekstu, liter ani cyfr, także na ekranach, opakowaniach, etykietach, sprzęcie i szyldach. Żadnych logotypów ani rozpoznawalnych znaków towarowych; wszystkie rekwizyty bez oznaczeń. Dokładnie jedna osoba w kadrze.
Blok zmienny to jedno zdanie: o czym jest ten film.
Te trzy ostatnie zakazy dopisano po kolejnych poprawkach, jedna klauzula na jedną usterkę. Struktura przenosi się bez zmian na inne modele obrazów AI; różnią się tylko nawyki sformułowań.
Jedna miniatura, dwa zastosowania
Kiedy osiem obrazów było gotowych, obrazy AI miały jeszcze jedno zadanie. Wziąłem kadr z trzeciej nad ranem jako klatkę początkową i przez generowanie wideo z pierwszej i ostatniej klatki zrobiłem pięciosekundową czołówkę.
Tu też czyha realna pułapka. Wygenerowany klip przekadrował scenę, a czysty obszar, który starannie zarezerwowałem na nagłówek, został w większości zjedzony. Dla czołówki to bez znaczenia. Dla planszy końcowej trzeba by rozplanować wszystko od nowa.
Żeby puścić całą partię naraz, lepiej rozłożyć osiem zadań obrazów AI na płótnie generatywnym niż iść pojedynczo — od razu widać, co zostaje, a co do poprawki. Jeśli wolisz nie pisać poleceń od zera, w szablonach są gotowe style portretowe do bezpośredniego zastosowania.
Osiem gotowych obrazów w jedno popołudnie
Cały zestaw miniatur na YouTube zajął popołudnie od pierwszego uruchomienia do ośmiu zatwierdzonych kadrów, przy czterech odrzuconych. Wolne było nie generowanie ani retusz, lecz zrozumienie, co oddać modelowi — na początku trzymałem zbyt mocno, przygwoździłem kompozycję i dostałem osiem obrazów wyglądających tak samo.
Jeśli chcesz to powtórzyć, kolejność jest taka: zmierz bezpieczny obszar i trzy rzeczywiste rozmiary wyświetlania, wygeneruj nieefektowną, ale czystą klatkę referencyjną, ogranicz blok stały do osoby plus tych kilku zakazów i traktuj temat każdego kadru jako jedyną zmienną. Co do tekstu — przy zestawie dodawaj go później, przy pojedynczym obrazie pozwól modelowi go napisać.
Cały zestaw miniatur na YouTube wykorzystał dokładnie dwa narzędzia obrazów AI: generowanie obrazów AI i edycję obrazów AI.