मैंने AI से 8 YouTube थंबनेल बनाए: नाप, फ़्रेमिंग और वे चार जो हटाने पड़े
किसी वीडियो पर क्लिक होगा या नहीं, यह उसके थंबनेल पर उससे कहीं ज़्यादा निर्भर करता है जितना ज़्यादातर लोग मानते हैं। मैंने एक दोपहर AI इमेज जनरेशन से 8 YouTube थंबनेल का पूरा सेट बनाने में लगाई। रास्ते में चार हटाने पड़े, एक नतीजे ने उस सलाह को झुठला दिया जिसे मैं पक्का मानकर चल रहा था, और मुझसे एक ज़्यादा बुनियादी गलती भी हुई जो अपने अलग हिस्से की हकदार है।
कुछ भी जनरेट करने से पहले नाप ले लीजिए
YouTube थंबनेल का सुझाया गया आकार 1280×720 है, यानी 16:9। यह संख्या बहुत लोग जानते हैं। तैयार तस्वीर कैसा काम करती है, इस पर दो दूसरी बातें ज़्यादा असर डालती हैं।
पहली, नीचे दाहिना कोना वीडियो की अवधि वाले बैज से ढक जाता है। 1280×720 पर यह लगभग 132×36 जगह घेरता है, और वहाँ रखी कोई भी चीज़ आधी कट जाती है।
दूसरी, और यह भूलना ज़्यादा आसान है: फ़ीड में थंबनेल कभी असली आकार में नहीं दिखता। कंप्यूटर का होम पेज उसे लगभग 360px चौड़ाई में दिखाता है, और मोबाइल की सिफ़ारिश फ़ीड अक्सर करीब 168px पर ही टिकी रहती है। मैंने एक ही YouTube थंबनेल को तीनों आकारों में छोटा करके अगल-बगल रखा। 360px पर प्रॉप्स और चेहरे का भाव अब भी पढ़े जाते हैं। 168px पर बस रंग का एक धब्बा और एक मानव आकृति बचती है।
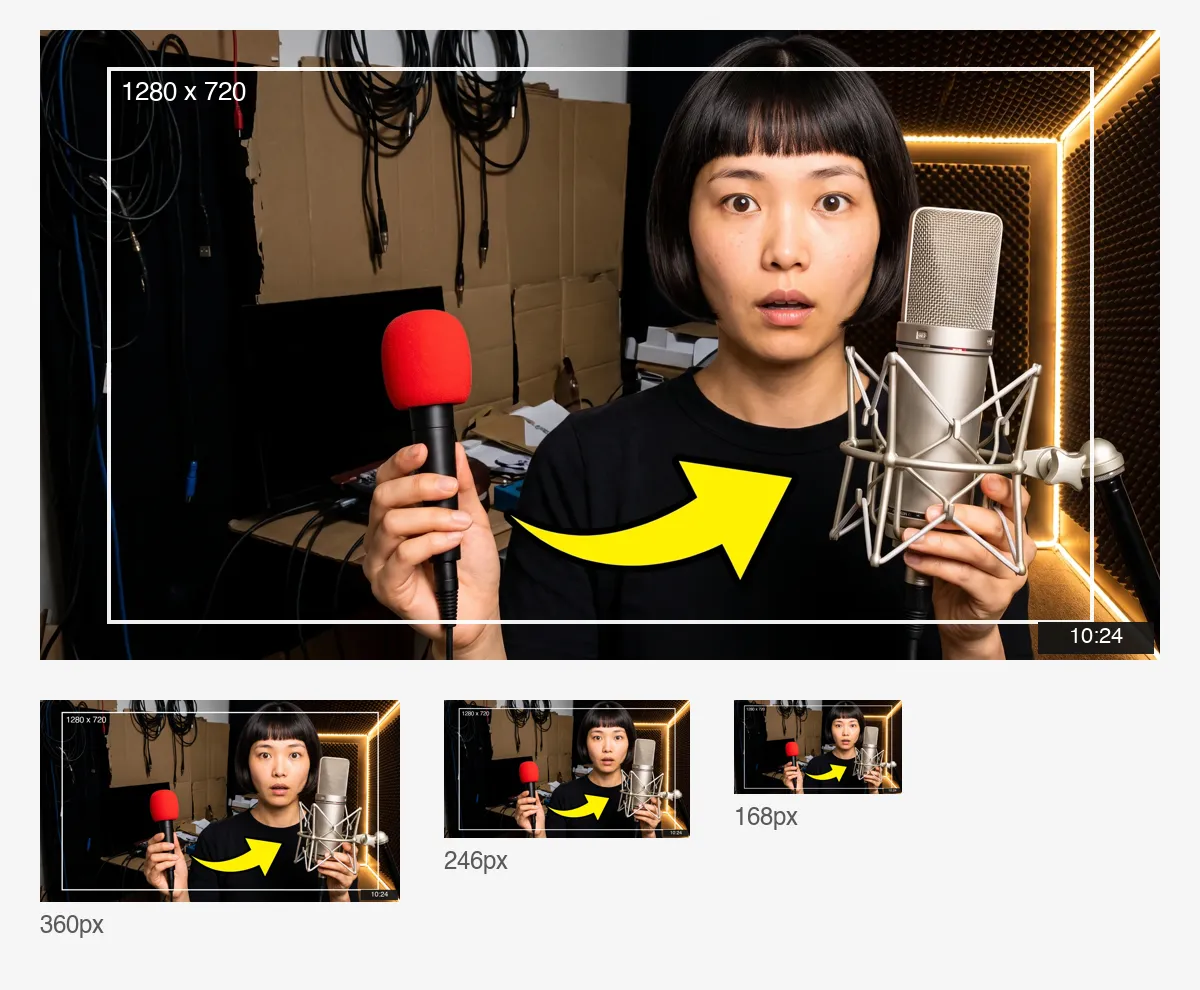
तो जनरेट करने से पहले मैंने दो नियम तय किए। विषय और हर ज़रूरी चीज़ को चारों तरफ़ 6% हाशिये वाले केंद्रीय सुरक्षित क्षेत्र के भीतर रखो, और नीचे दाहिना कोना खाली छोड़ो। साथ ही फ़्रेम में एक साफ़ जगह छोड़ो जहाँ बाद में शीर्षक रखा जाएगा।
एक कास्टिंग फ़ोटो से शुरू कीजिए, पूरे सेट की नींव वही है
पूरे काम का सबसे मुश्किल हिस्सा यह है कि आठों थंबनेल में मौजूद व्यक्ति एक ही होना चाहिए।
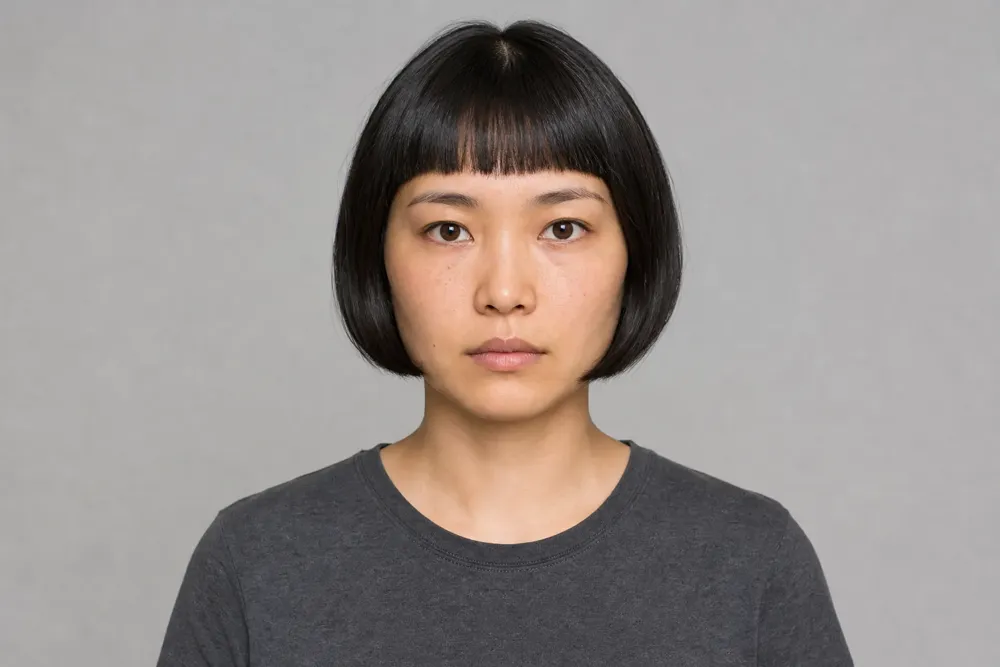
मेरा तरीका यह था कि पहले AI इमेज जनरेशन से एक साफ़ संदर्भ फ़्रेम बनाया जाए: सामने से, आँखों की ऊँचाई पर, बिना मेकअप, बिना भाव, धूसर पृष्ठभूमि, सपाट और एकसमान रोशनी, ठीक किसी कास्टिंग फ़ोटो जैसी। यह तस्वीर देखने में ज़रा भी आकर्षक नहीं है और इसे कभी प्रकाशित करने का इरादा भी नहीं था। इसका एकमात्र काम आगे की हर तस्वीर के लिए संदर्भ बनना है।
और अब उस गलती की बात।
पहले दौर में मैंने कंपोज़िशन भी ठोक दी थी। विषय बाएँ एक-तिहाई में, उसके चारों ओर सफ़ेद कटआउट रेखा, सिर के पीछे किरणों का गुच्छा, दाहिने आधे हिस्से को भरता सपाट रंग का ब्लॉक। बदलने की छूट सिर्फ़ चेहरे के भाव और पृष्ठभूमि के रंग को थी। आठ तस्वीरों के बाद उसका चेहरा रत्ती भर नहीं खिसका था, पर पूरा सेट आठ थंबनेल के बजाय भावों की एक तालिका जैसा दिख रहा था। दूसरा चेहरा, दूसरा रंग, बस इतना ही।
वजह सीधी है। असली थंबनेल इस बात के इर्द-गिर्द डिज़ाइन होता है कि वीडियो किस बारे में है, जबकि मैंने मॉडल को इकलौता चर दिया था चेहरे का भाव। डिज़ाइन करने को कुछ था ही नहीं, तो उसने मेरा टेम्पलेट आठ बार दोहरा दिया।
सुधार यह था कि डिज़ाइन का ज़िम्मा वापस उसे सौंप दिया जाए। स्थिर ब्लॉक अब सिर्फ़ वही बाँधता है जो बाँधना ज़रूरी है: वही व्यक्ति, चेहरा रोशन और बिना ढका, धड़ का ऊपरी हिस्सा फ़्रेम में। परिवेश, प्रॉप्स, ग्राफ़िक तत्व, रंग-पट्टी, रोशनी, गहराई और फ़्रेमिंग सब मॉडल का फ़ैसला। चर ब्लॉक एक वाक्य में सिमट गया — यह वीडियो किस बारे में है।
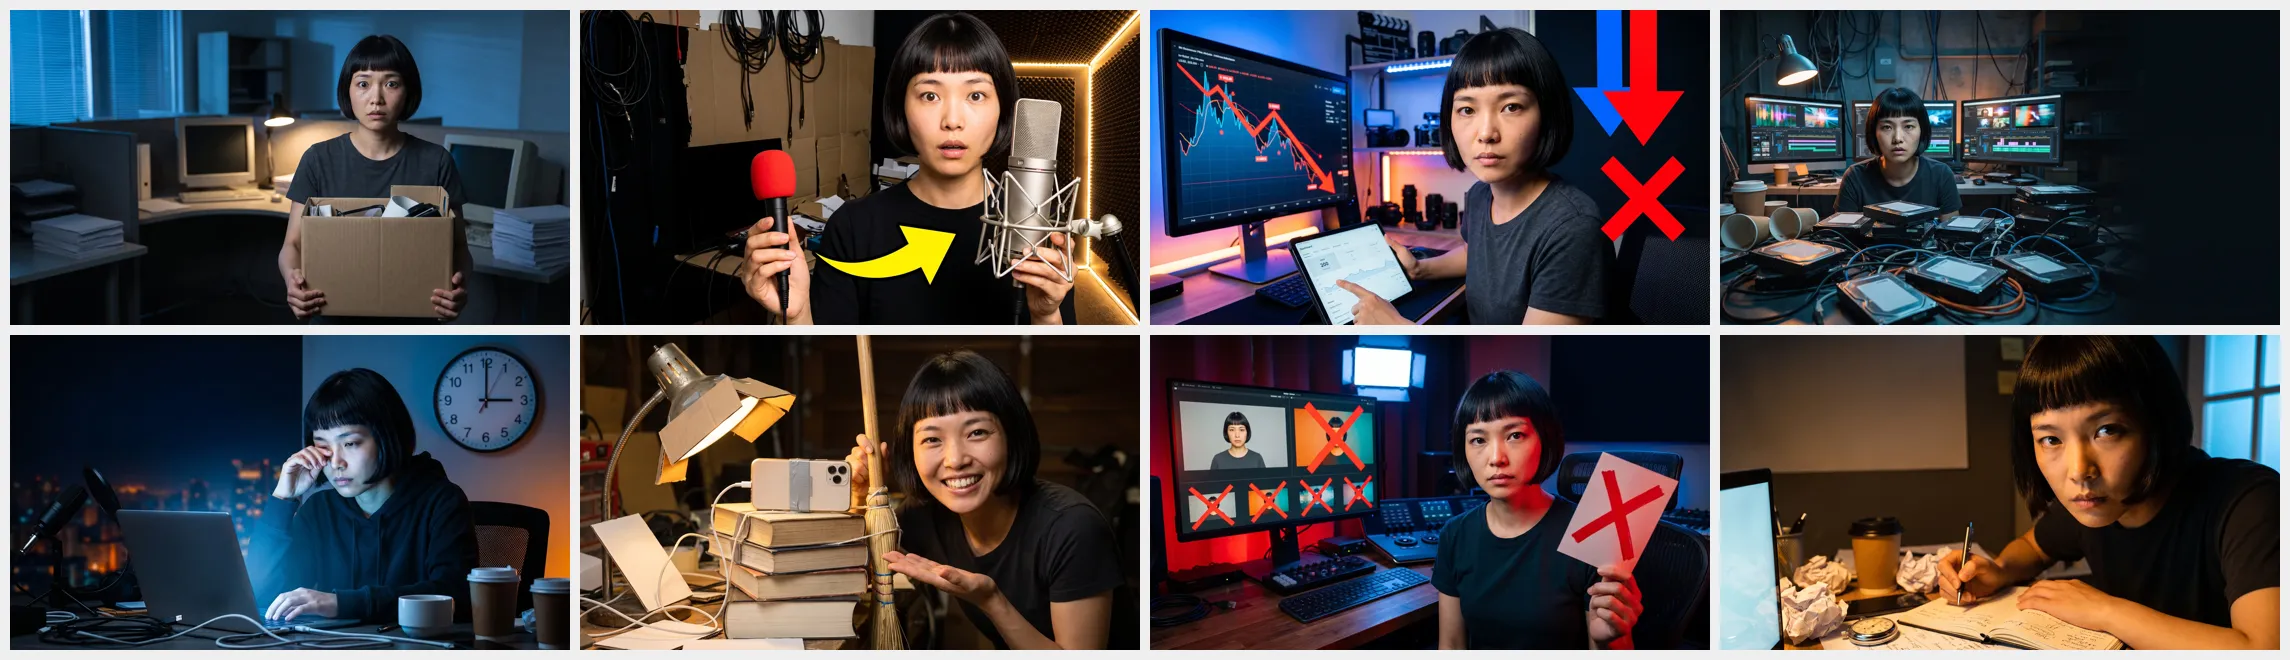
आठ चर ये थे: दफ़्तर की नौकरी छोड़ना, तीन सौ रुपये का माइक जो तीन हज़ार वाले को मात दे दे, दो सौ व्यूज़ पर अटक जाना, एक हफ़्ते में सौ वीडियो एडिट करना, एक महीने तक रात तीन बजे अपलोड करना, फ़ोन से भी सस्ता पूरा शूटिंग सेटअप, पाँच कलर प्रीसेट जिन्हें छोड़ देना चाहिए, और बारह मिनट में स्क्रिप्ट लिख डालना।
जो वापस आया वह पहले दौर की तुलना में बिलकुल दूसरे स्तर का था। एक लाल हैंडहेल्ड माइक और एक कंडेंसर माइक के बीच पड़ा पीला तीर। मॉनिटर पर लुढ़कती लाल रेखा और उसके बगल में लाल क्रॉस। प्रीसेट के थंबनेल की एक कतार, हर एक पर काट का निशान। रात तीन बजे शहर की सिल्हूट के सामने टँगी दीवार घड़ी। इस दृश्य-भाषा का एक भी हिस्सा मेरे प्रॉम्प्ट में नहीं था — AI इमेज मॉडल ने यह सब खुद गढ़ा।
मुझे लगा यह अक्षर नहीं लिख सकता। यह लिख सकता है।
AI इमेज जनरेशन को लेकर एक सलाह खूब दोहराई जाती है: मॉडल पढ़ने लायक टेक्स्ट नहीं लिख पाते, इसलिए नतीजे में आया कोई भी अक्षर बिगड़ा हुआ ही निकलेगा। मैं इसी पर चल रहा था, और हर प्रॉम्प्ट इस निर्देश के साथ खत्म होता था कि फ़्रेम में टेक्स्ट न आए।
आख़िर में मैंने परखा और मॉडल से कहा कि शीर्षक सीधे उस खाली जगह में लिख दे।
उसने सही लिखा। एक भी अक्षर गलत नहीं, आकार साफ़, मोटाई ठीक, तीन पंक्तियों में पंक्ति-विभाजन भी समझदारी भरा। आज के AI इमेज मॉडलों पर वह पुराना नियम अब वाकई नहीं टिकता।
फिर भी मैंने राय नहीं बदली, क्योंकि दूसरे परीक्षण ने असली दिक्कत उजागर कर दी। मैंने शीर्षक में 200 की जगह 500 किया, बाकी एक भी शब्द नहीं छुआ, और दोबारा चलाया। टेक्स्ट अब भी सही था, पर पूरा फ़्रेम नए सिरे से रचा गया था: वह बगल से बैठी मुद्रा से हटकर बीच में सामने की ओर आ गई, मॉनिटर सबसे बाएँ किनारे से खिसककर ठीक उसके पीछे पहुँच गया, और अक्षरों का आकार और जगह भी उसी के साथ बदल गए। दोनों को अगल-बगल रखिए तो वे एक ही सेट के नहीं लगते।
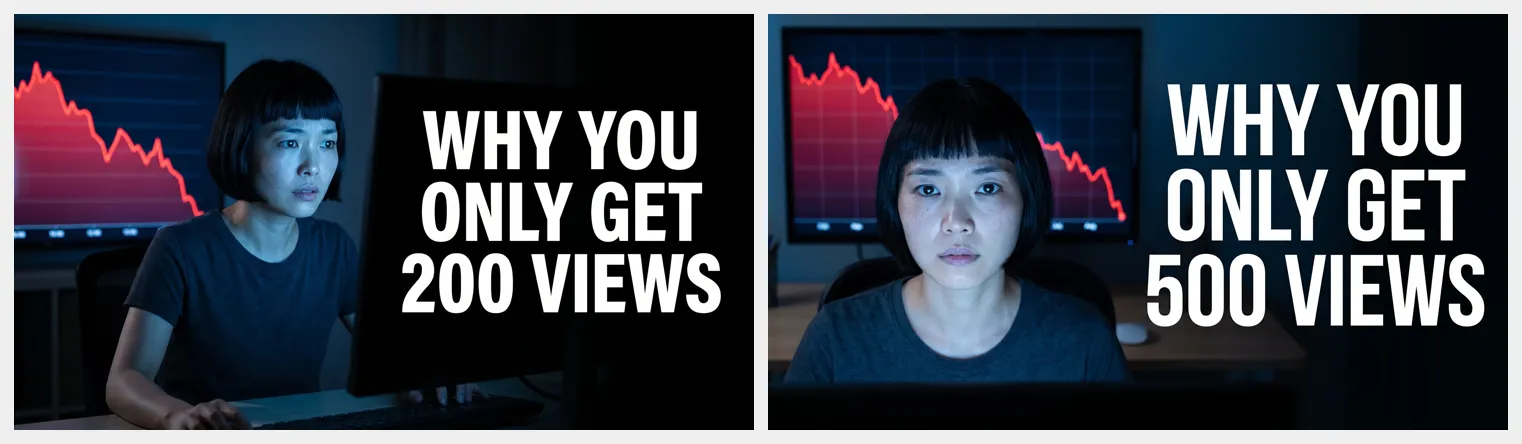
तो निष्कर्ष कायम है, पर उसका कारण बदल गया। दिक्कत यह नहीं कि वह लिख नहीं सकता, दिक्कत यह है कि लेआउट दोहराया नहीं जा सकता। अगर आप YouTube थंबनेल का पूरा सेट बना रहे हैं और आगे चलकर शीर्षक बदलने या A/B परीक्षण करने का इरादा है, तो टेक्स्ट को तस्वीर से बाहर रखिए और अलग से ऊपर बिछाइए। जिस इकलौती तस्वीर को दोबारा छूना ही नहीं है, उसमें मॉडल से लिखवा लेना एक कदम बचा देता है।
वे चार जो हटाने पड़े
डिज़ाइन का ज़िम्मा AI इमेज मॉडल को सौंपने की कीमत यह है कि वह बड़ी सहजता से फ़्रेम में वे चीज़ें डाल देता है जो आपने कभी माँगी ही नहीं थीं। चार बार दोबारा बनाना पड़ा, तीन अलग-अलग किस्म की गड़बड़ियाँ।
असली ब्रांड। नौकरी छोड़ने वाली तस्वीर में उसने उसके हाथ में ऐसा माइक थमा दिया जिसकी बगल में एक असली निर्माता का नाम छपा था। सौ एडिट वाली तस्वीर में मेज़ पर तुरंत पहचान में आ जाने वाले दो एनर्जी ड्रिंक के डिब्बे रख दिए। दोनों में से कोई भी प्रकाशित होने वाली तस्वीर में नहीं चल सकता।
विषय का दोहराव। मैंने ब्रांड पर रोक वाली शर्त जोड़कर नौकरी वाली तस्वीर दोबारा चलाई, और वह मुझे दो प्रतियों में मिली: एक मेज़ पर टाइप करती हुई, दूसरी बगल में खड़ी गत्ते का डिब्बा थामे। मॉडल ने "दफ़्तर छोड़ना" को ऐसा दृश्य समझ लिया जिसमें दो कलाकार चाहिए।
प्रॉप्स पर अक्षर उभर आना। सस्ते सेटअप वाली तस्वीर में उसने गत्ते के डिब्बे पर करीने से दो अंग्रेज़ी शब्द लिख दिए। यहाँ यही सबसे भारी पड़ता है: ये तस्वीरें 21 भाषाओं में साझा होती हैं, इसलिए किसी एक भाषा का टेक्स्ट बाकी बीस भाषाओं के पाठकों के लिए शोर बन जाता है।
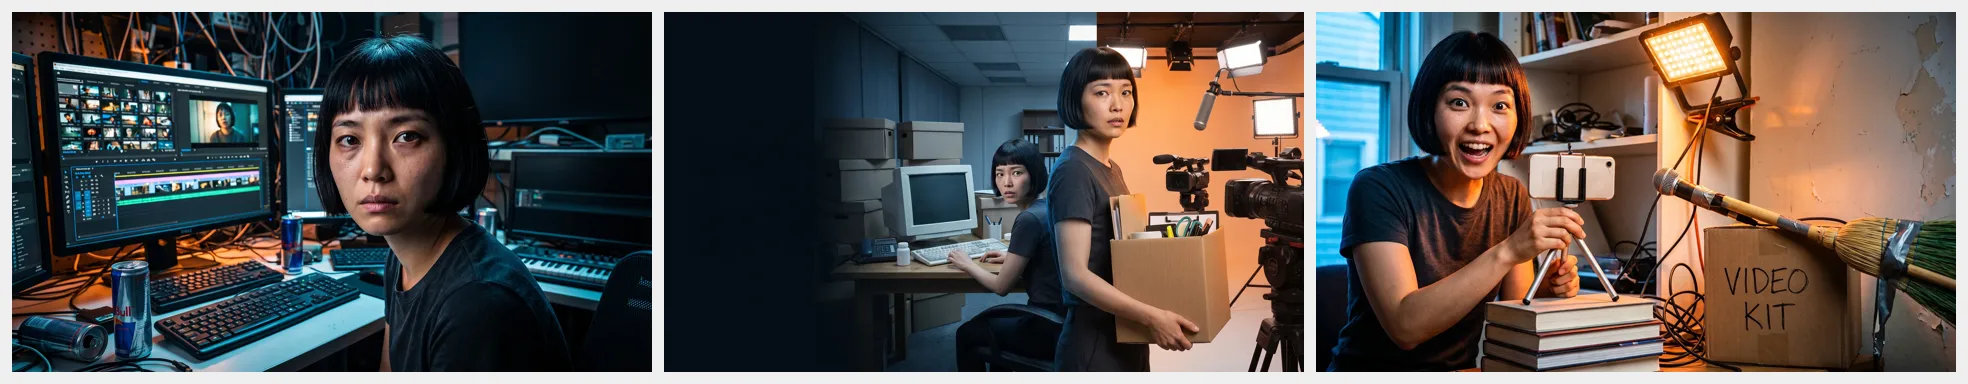
तीनों बाद में स्थिर ब्लॉक की शर्तें बन गईं, और उन्हें ठोस शब्दों में लिखना ज़रूरी है। "कोई टेक्स्ट नहीं" काफ़ी नहीं — लिखना पड़ता है कि स्क्रीन, पैकेजिंग, लेबल, उपकरण या साइनबोर्ड किसी पर अक्षर न हों। "सिर्फ़ एक व्यक्ति" भी काफ़ी नहीं; उसकी दूसरी प्रति, उसका प्रतिबिंब और पृष्ठभूमि में लगी उसकी तस्वीर, इन सबको अलग से मना करना पड़ता है।
एक प्रॉम्प्ट ढाँचा जिसे आप उतार सकते हैं
स्थिर ब्लॉक हर प्रॉम्प्ट में ज्यों का त्यों चिपकाया जाता है, और मोटे तौर पर ऐसा है।
संदर्भ तस्वीर वाली उसी व्यक्ति का इस्तेमाल करो, वही बाल। उसे देखते ही वही व्यक्ति पहचाना जाना चाहिए, चेहरा रोशन, बिना ढका और मोटे तौर पर कैमरे की ओर, धड़ का ऊपरी हिस्सा फ़्रेम में। तुम आर्ट डायरेक्टर हो और ऐसा YouTube थंबनेल डिज़ाइन कर रहे हो जिसे 168 पिक्सल चौड़ाई पर क्लिक कमाना है — उसकी शक्ल के अलावा सब कुछ तुम तय करोगे: परिवेश, प्रॉप्स, ग्राफ़िक तत्व, रंग-पट्टी, रोशनी, गहराई और फ़्रेमिंग। इसे साहसी, तीखे कंट्रास्ट वाला और इसी विषय के लिए ख़ास बनाओ, रंगीन पृष्ठभूमि पर टिका कोई साधारण पोर्ट्रेट नहीं। फ़्रेम में एक साफ़ जगह छोड़ो जहाँ बाद में शीर्षक जोड़ा जाएगा। कहीं भी कोई टेक्स्ट, अक्षर या अंक नहीं, स्क्रीन, पैकेजिंग, लेबल, उपकरण और साइनबोर्ड पर भी नहीं। कोई ब्रांड लोगो या पहचाना जा सकने वाला ट्रेडमार्क नहीं; सारे प्रॉप्स बिना किसी निशान के। फ़्रेम में ठीक एक व्यक्ति।
चर ब्लॉक एक वाक्य है — यह वीडियो किस बारे में है।
आख़िरी तीन मनाहियाँ हर बार किसी दोबारा बनाई गई तस्वीर के बाद जुड़ीं, एक गड़बड़ी पर एक शर्त। यह ढाँचा दूसरे AI इमेज मॉडलों पर ज्यों का त्यों चल जाता है; बस लिखने की आदतें बदलती हैं।
एक थंबनेल, दो बार काम आया
आठों तस्वीरें तय हो जाने के बाद भी AI इमेज से बने इन स्थिर फ़्रेमों में एक काम बाकी था। मैंने रात तीन बजे वाली तस्वीर को शुरुआती फ़्रेम बनाकर पहले और आख़िरी फ़्रेम से वीडियो की मदद से पाँच सेकंड का इंट्रो बनाया।
यहाँ भी एक असली अड़चन है। बने हुए क्लिप ने दृश्य को दोबारा फ़्रेम कर दिया, और शीर्षक के लिए मैंने जो साफ़ जगह सँभालकर छोड़ी थी वह लगभग पूरी खा ली गई। इंट्रो के लिए इससे फ़र्क नहीं पड़ता। एंड कार्ड के लिए पूरा लेआउट दोबारा करना पड़ेगा।
पूरा जत्था एक साथ चलाना हो तो आठों AI इमेज कामों को जनरेटिव कैनवस पर फैला देना एक-एक करके चलने से बेहतर पड़ता है — एक नज़र में दिख जाता है कि क्या रखना है और क्या दोबारा बनाना है। प्रॉम्प्ट शुरू से नहीं लिखने हों तो टेम्पलेट में सीधे लगाने लायक पोर्ट्रेट शैलियाँ मौजूद हैं।
एक दोपहर में आठ तैयार तस्वीरें
YouTube थंबनेल का पूरा सेट पहली बार चलाने से लेकर आठ तय फ़्रेम तक एक दोपहर में बना, चार तस्वीरें हटानी पड़ीं। धीमा हिस्सा न जनरेट करना था न रीटच करना, बल्कि यह समझना था कि मॉडल को क्या सौंपना है — शुरू में मैंने मुट्ठी बहुत कस ली, कंपोज़िशन ठोक दी, और आठ ऐसी तस्वीरें मिलीं जो सब एक जैसी लगती थीं।
दोहराना हो तो क्रम यह है: सुरक्षित क्षेत्र और तीनों वास्तविक प्रदर्शन आकार नाप लीजिए, एक अनाकर्षक पर साफ़ संदर्भ फ़्रेम बनाइए, स्थिर ब्लॉक को उस व्यक्ति और उन थोड़ी-सी मनाहियों तक समेटिए, और हर तस्वीर के विषय को इकलौता चर मानिए। टेक्स्ट का मामला — सेट बना रहे हों तो बाद में जोड़िए, अकेली तस्वीर हो तो मॉडल से लिखवा लीजिए।
YouTube थंबनेल के इस पूरे सेट में ठीक दो AI इमेज उपकरण लगे, AI इमेज जनरेशन और AI इमेज एडिटिंग।