AI দিয়ে ৮টি YouTube থাম্বনেইল বানালাম: মাপ, ফ্রেমিং এবং যে চারটি বাদ দিতে হলো
একটি ভিডিওতে ক্লিক পড়বে কি না, তা থাম্বনেইলের ওপর অনেকের ধারণার চেয়ে অনেক বেশি নির্ভর করে। এক দুপুর সময় নিয়ে AI ছবি তৈরির সাহায্যে ৮টি YouTube থাম্বনেইলের একটি পূর্ণ সেট বানালাম। পথে চারটি বাদ দিতে হলো, একটি ফলাফল এমন পরামর্শকে ভুল প্রমাণ করল যেটিকে আমি ধ্রুব ধরে নিয়েছিলাম, আর আমি আরও মৌলিক একটি ভুল করলাম যেটির জন্য আলাদা অংশ প্রাপ্য।
কিছু তৈরি করার আগে মাপগুলো জেনে নিন
YouTube থাম্বনেইলের প্রস্তাবিত মাপ ১২৮০×৭২০, অর্থাৎ ১৬:৯। এই সংখ্যাটি অনেকেই জানেন। শেষ ছবিটি কেমন কাজ করবে, তাতে আরও দুটি বিষয়ের প্রভাব বেশি।
প্রথমত, নিচের ডান কোণটি ভিডিওর দৈর্ঘ্য দেখানো ব্যাজে ঢাকা পড়ে যায়। ১২৮০×৭২০ হিসেবে সেটি প্রায় ১৩২×৩৬ জায়গা নেয়, আর সেখানে রাখা যেকোনো জিনিসের অর্ধেক হারিয়ে যায়।
দ্বিতীয়ত, এবং এটি ভুলে যাওয়া আরও সহজ: ফিডে থাম্বনেইল কখনোই আসল মাপে দেখানো হয় না। কম্পিউটারের হোম পেজে সেটি প্রায় ৩৬০px চওড়া দেখায়, আর মোবাইলের সুপারিশ ফিডে প্রায়ই কেবল ১৬৮px-এর মতো থাকে। একই YouTube থাম্বনেইলকে তিনটি মাপে ছোট করে পাশাপাশি রাখলাম। ৩৬০px-এ প্রপ আর মুখের অভিব্যক্তি তখনো পড়া যায়। ১৬৮px-এ টিকে থাকে কেবল এক দলা রং আর একটি মানুষের অবয়ব।
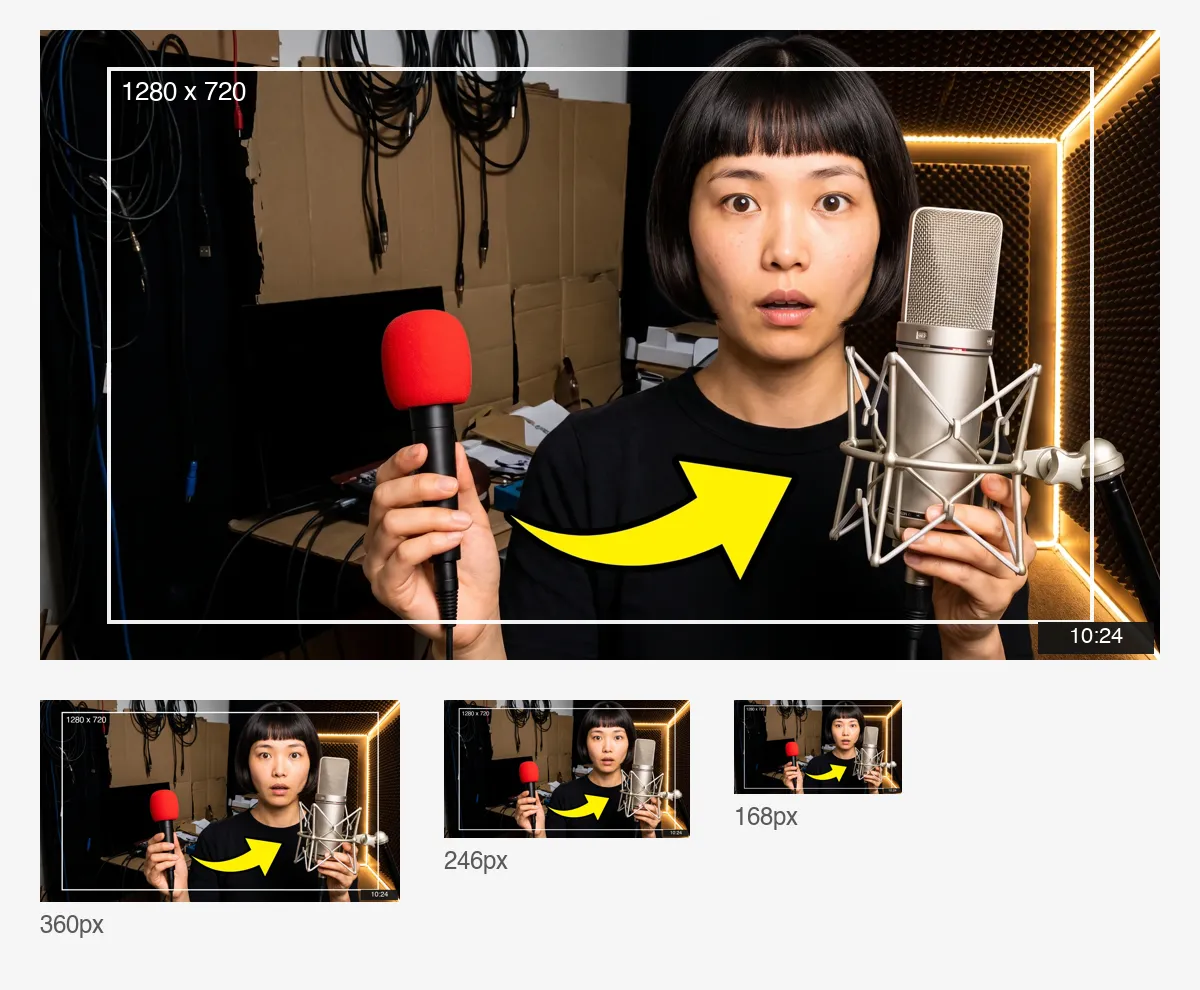
তাই কিছু তৈরি করার আগেই দুটি নিয়ম ঠিক করলাম। মূল চরিত্র আর গুরুত্বপূর্ণ সবকিছু চারদিকে ৬% মার্জিন রাখা কেন্দ্রীয় নিরাপদ এলাকার ভেতরে রাখো, আর নিচের ডান কোণ খালি ছাড়ো। সেই সঙ্গে ফ্রেমে একটি পরিষ্কার জায়গা রেখে দাও, যেখানে পরে শিরোনাম বসবে।
একটি কাস্টিং ছবি দিয়ে শুরু করুন, গোটা সেটের ভিত্তি সেটিই
পুরো কাজের সবচেয়ে কঠিন দিক হলো আটটি থাম্বনেইলের মানুষটিকে একই মানুষ হতে হবে।
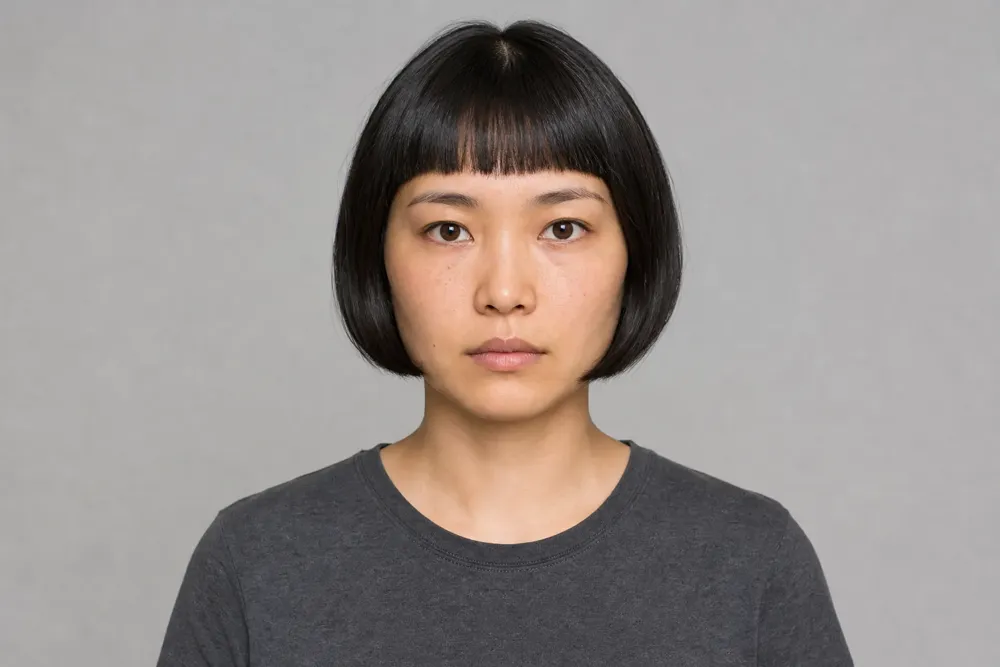
আমার পদ্ধতি ছিল আগে AI ছবি তৈরি দিয়ে একটি পরিষ্কার রেফারেন্স ফ্রেম বানানো: সোজাসুজি সামনে থেকে, চোখের উচ্চতায়, মেকআপ ছাড়া, ভাবলেশহীন, ধূসর পটভূমি, সমতল ও সমান আলো, ঠিক যেন একটি কাস্টিং ছবি। এই ছবিটি মোটেই আকর্ষণীয় নয় এবং প্রকাশের জন্য কখনো ভাবাও হয়নি। এর একমাত্র কাজ পরবর্তী প্রতিটি ফ্রেমের রেফারেন্স হওয়া।
আর এখানেই সেই ভুল।
প্রথম দফায় আমি কম্পোজিশনও গেঁথে দিয়েছিলাম। চরিত্র বাঁ দিকের এক-তৃতীয়াংশে, তার চারপাশে সাদা কাটআউট রেখা, মাথার পেছনে রশ্মির ছটা, ডান অর্ধেক ভরাট করা সমতল রঙের ব্লক। বদলাতে দেওয়া হয়েছিল কেবল মুখের অভিব্যক্তি আর পটভূমির রং। আটটি ছবির পরও তার মুখ এতটুকু সরেনি, কিন্তু গোটা সেটটিকে আটটি থাম্বনেইলের বদলে আবেগের একটি তালিকা মনে হচ্ছিল। অন্য মুখ, অন্য রং, ব্যস এইটুকুই।
কারণটা সরল। সত্যিকারের থাম্বনেইল ভিডিওর বিষয়কে ঘিরে নকশা করা হয়, অথচ মডেলকে আমি একমাত্র চলক দিয়েছিলাম মুখের অভিব্যক্তি। নকশা করার মতো কিছুই ছিল না, তাই সে আমার ছকটিকেই আটবার পুনরাবৃত্তি করেছে।
সমাধান ছিল নকশার ভার মডেলকে ফিরিয়ে দেওয়া। স্থির ব্লক এখন কেবল সেটুকুই আটকায় যেটুকু আটকানো দরকার: একই মানুষ, তার মুখ আলোকিত ও অনাবৃত, শরীরের উপরের অংশ ফ্রেমে। পরিবেশ, প্রপ, গ্রাফিক উপাদান, রঙের প্যালেট, আলো, গভীরতা আর ফ্রেমিং সবই মডেলের সিদ্ধান্ত। পরিবর্তনশীল ব্লক নেমে এল একটি বাক্যে — এই ভিডিওটি কী নিয়ে।
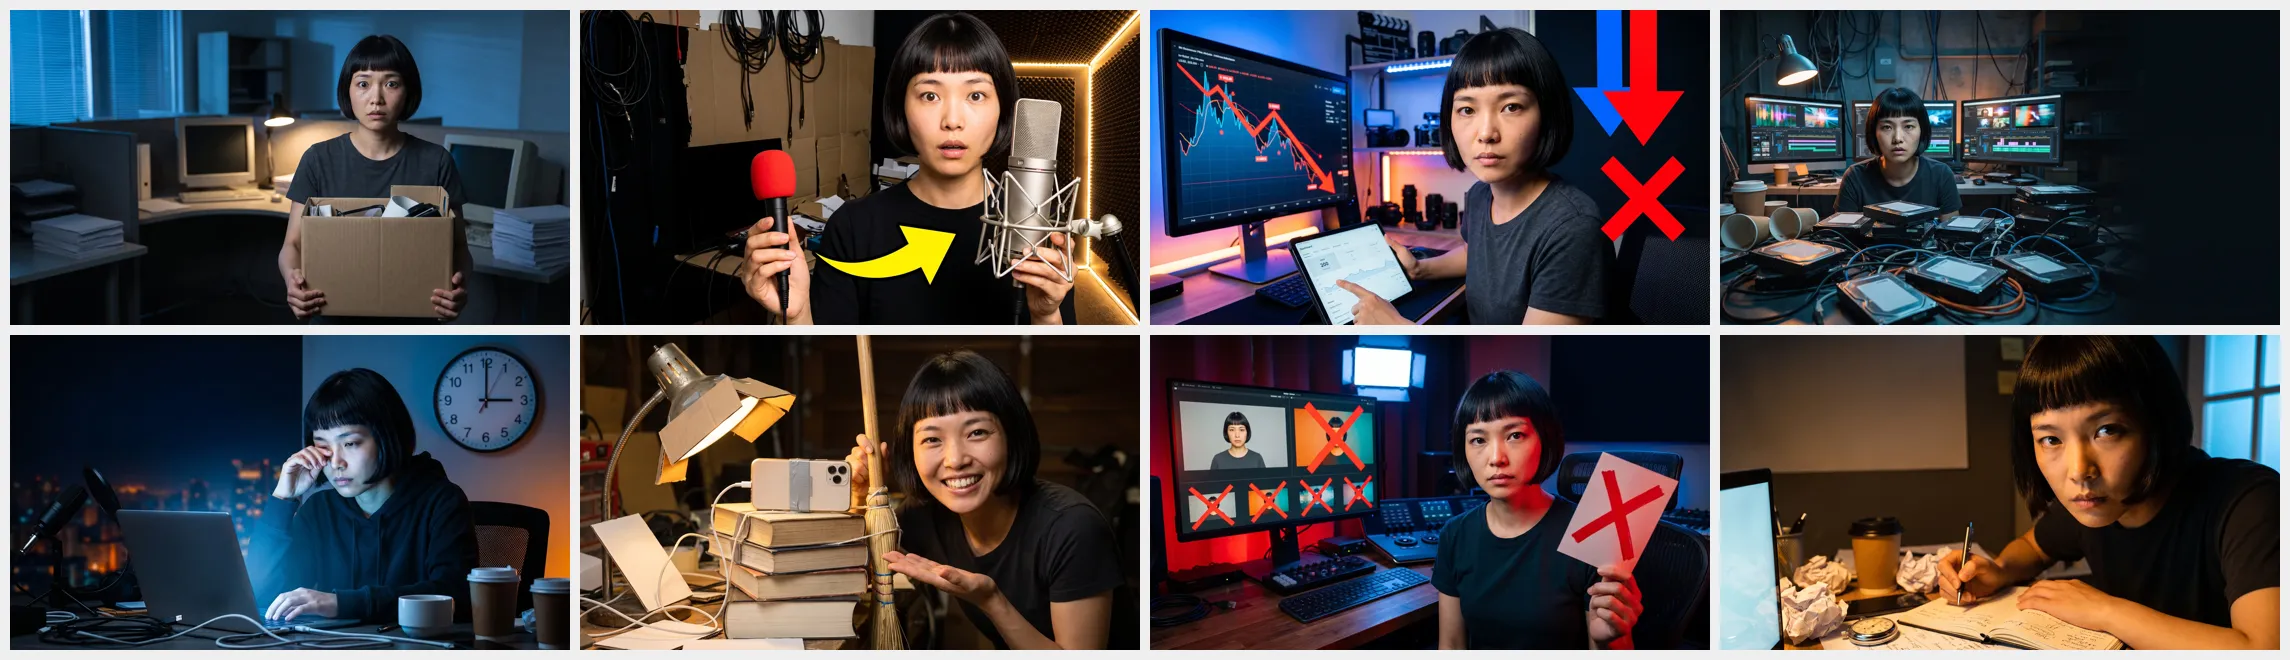
আটটি চলক ছিল: অফিসের চাকরি ছেড়ে দেওয়া, তিনশো টাকার মাইক যেটি তিন হাজার টাকার মাইককে হারিয়ে দেয়, দুইশো ভিউতে আটকে থাকা, এক সপ্তাহে একশো ভিডিও সম্পাদনা, এক মাস ধরে রাত তিনটায় আপলোড, ফোনের চেয়েও সস্তা গোটা শুটিং সেটআপ, পাঁচটি কালার প্রিসেট যেগুলো ছেড়ে দেওয়া উচিত, আর বারো মিনিটে স্ক্রিপ্ট লিখে ফেলা।
যা ফিরে এল তা প্রথম দফার সঙ্গে একই স্তরের নয়। একটি লাল হাতে ধরা মাইক আর একটি কনডেনসার মাইকের মাঝে শোয়ানো হলুদ তির। মনিটরে ধসে পড়া লাল রেখা আর তার পাশে লাল ক্রস। প্রিসেটের থাম্বনেইলের একটি সারি, প্রতিটির ওপর আলাদা করে কাটা দাগ। রাত তিনটায় শহরের আকাশরেখার সামনে ঝোলানো দেয়াল ঘড়ি। এই দৃশ্যভাষার কিছুই আমার প্রম্পটে ছিল না — AI ছবি মডেল নিজেই সব বানিয়েছে।
ভেবেছিলাম সে লিখতে পারে না। পারে।
AI ছবি তৈরি নিয়ে একটি পরামর্শ খুব বেশি শোনা যায়: মডেল পাঠযোগ্য লেখা বসাতে পারে না, তাই ফলাফলে যে অক্ষরই আসুক তা বিকৃত হবে। আমি সেটাই মেনে চলছিলাম, আর প্রতিটি প্রম্পট শেষ হতো ফ্রেমে কোনো লেখা না রাখার নির্দেশ দিয়ে।
শেষে পরখ করে দেখলাম, মডেলকে বললাম শিরোনামটি সরাসরি ফাঁকা জায়গায় লিখে দিতে।
সে ঠিকই লিখল। একটিও ভুল অক্ষর নেই, গড়ন পরিষ্কার, ওজন মানানসই, তিন লাইনে লাইন-ভাঙাও যুক্তিসঙ্গত। আজকের AI ছবি মডেলগুলোর ক্ষেত্রে সেই পুরোনো নিয়ম আর সত্যিই টেকে না।
তবু মত বদলাইনি, কারণ দ্বিতীয় পরীক্ষাটি আসল সমস্যাটি খুলে দিল। শিরোনামে ২০০ বদলে ৫০০ করলাম, আর কোনো শব্দ ছুঁলাম না, আবার চালালাম। লেখা তখনো সঠিক, কিন্তু গোটা ফ্রেম নতুন করে সাজানো হয়ে গেছে: পাশ ফিরে বসা ভঙ্গি থেকে সে সোজাসুজি মাঝখানে চলে এসেছে, মনিটর বাঁ প্রান্ত থেকে সরে ঠিক তার পেছনে গেছে, আর অক্ষরের আকার ও অবস্থানও সেই সঙ্গে বদলেছে। পাশাপাশি রাখলে দুটিকে এক সেটের বলে মনে হয় না।
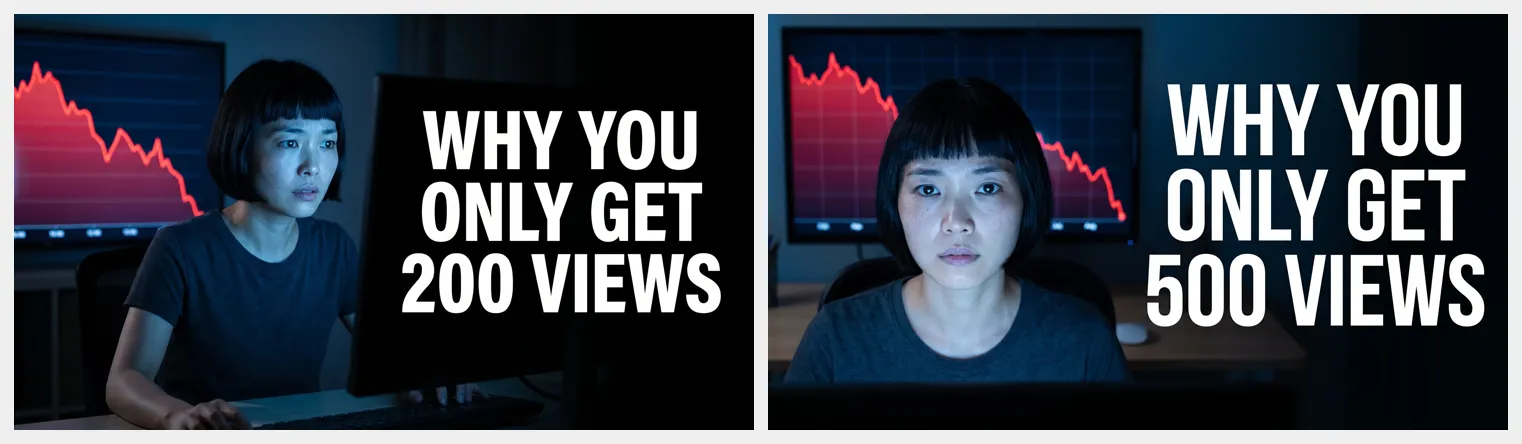
তাই সিদ্ধান্ত টিকে আছে, বদলে গেছে তার কারণ। সমস্যা এই নয় যে সে লিখতে পারে না, সমস্যা হলো লেআউট পুনরুৎপাদনযোগ্য নয়। যদি আপনি YouTube থাম্বনেইলের একটি পূর্ণ সেট বানান এবং পরে শিরোনাম বদলানোর বা A/B পরীক্ষার পরিকল্পনা থাকে, তবে লেখা ছবির বাইরে রাখুন এবং আলাদা স্তরে বসান। যে একটিমাত্র ছবিতে আর হাত দেবেন না, সেটিতে মডেলকে দিয়েই লিখিয়ে নিলে একটি ধাপ বাঁচে।
যে চারটি বাদ দিতে হলো
নকশার ভার একটি AI ছবি মডেলের হাতে তুলে দেওয়ার একটা দাম আছে: সে দিব্যি ফ্রেমে এমন জিনিস ঢুকিয়ে দেয় যা আপনি কখনো চাননি। চারবার নতুন করে বানাতে হলো, তিন ধরনের গোলমাল।
বাস্তব ব্র্যান্ড। চাকরি ছাড়ার ছবিতে সে তার হাতে এমন একটি মাইক ধরিয়ে দিল যার গায়ে একটি সত্যিকারের নির্মাতার নাম ছাপা। একশো সম্পাদনার ছবিতে টেবিলে রেখে দিল সঙ্গে সঙ্গে চেনা যায় এমন দুটি এনার্জি ড্রিংকের ক্যান। প্রকাশযোগ্য ছবিতে দুটির কোনোটিরই জায়গা নেই।
চরিত্রের পুনরাবৃত্তি। ব্র্যান্ড নিষিদ্ধ করার শর্ত যোগ করে চাকরির ছবিটি আবার চালালাম, আর তাকে পেলাম দুই কপিতে: একজন টেবিলে টাইপ করছে, আরেকজন পাশে দাঁড়িয়ে কার্ডবোর্ডের বাক্স ধরে আছে। মডেল "অফিস ছেড়ে যাওয়া"-কে এমন দৃশ্য হিসেবে পড়েছে যেখানে দুজন অভিনেত্রী লাগে।
প্রপে লেখা ফুটে ওঠা। সস্তা সেটআপের ছবিতে সে কার্ডবোর্ডের বাক্সে পরিপাটি করে দুটি ইংরেজি শব্দ লিখে দিল। এখানে এটিই সবচেয়ে গুরুতর: এই ছবিগুলো ২১টি ভাষায় ভাগ করে ব্যবহার করা হয়, তাই কোনো একটি ভাষার লেখা বাকি বিশটি ভাষার পাঠকের জন্য কেবল গোলমাল।
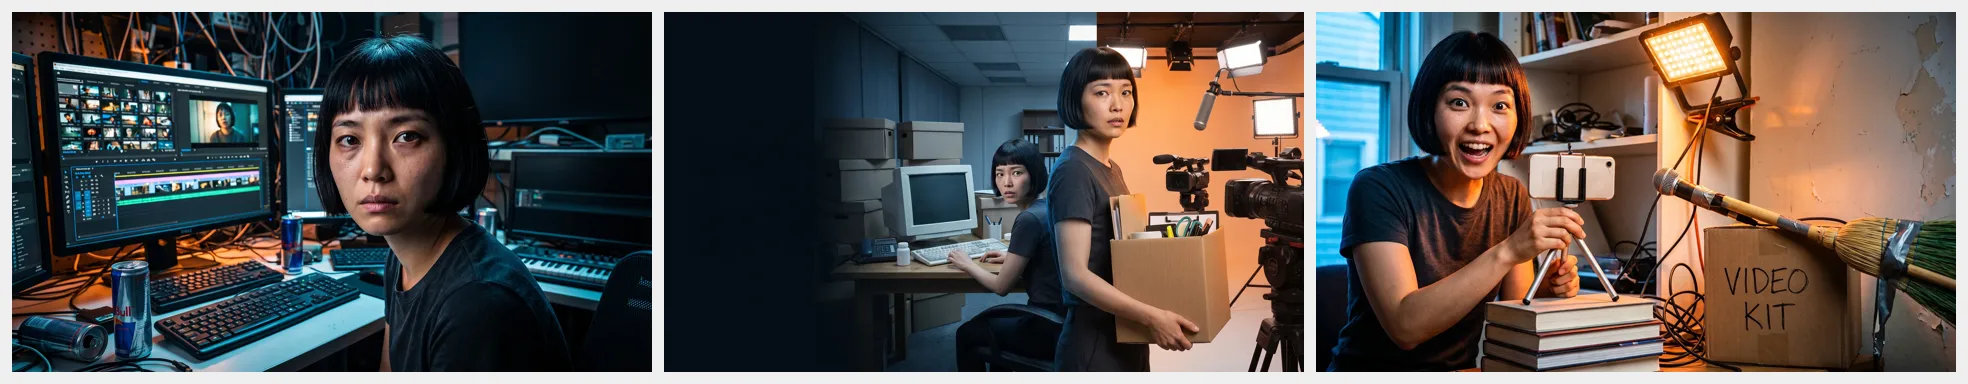
তিনটিই পরে স্থির ব্লকের শর্ত হয়ে গেল, আর সেগুলো সুনির্দিষ্ট করে লিখতেই হবে। "কোনো লেখা নয়" যথেষ্ট নয় — লিখতে হয় পর্দা, মোড়ক, লেবেল, যন্ত্রপাতি বা সাইনবোর্ড কোথাও অক্ষর নয়। "একজন মানুষ" বললেও যথেষ্ট নয়; তার দ্বিতীয় সংস্করণ, প্রতিফলন এবং পটভূমিতে তার প্রতিকৃতিও আলাদা করে বাদ দিতে হয়।
একটি প্রম্পট কাঠামো, যা হুবহু তুলে নেওয়া যায়
স্থির ব্লকটি প্রতিটি প্রম্পটে অপরিবর্তিত অবস্থায় বসানো হয়, আর মোটামুটি এমন।
রেফারেন্স ছবির সেই একই মানুষ ব্যবহার করো, একই চুল। তাকে দেখামাত্র একই মানুষ বলে চেনা যেতে হবে, মুখ আলোকিত, অনাবৃত এবং মোটামুটি ক্যামেরার দিকে ফেরানো, শরীরের উপরের অংশ ফ্রেমে। তুমি আর্ট ডিরেক্টর, এমন একটি YouTube থাম্বনেইল নকশা করছ যাকে ১৬৮ পিক্সেল চওড়ায় ক্লিক অর্জন করতে হবে — তার চেহারা ছাড়া বাকি সব তুমিই ঠিক করবে: পরিবেশ, প্রপ, গ্রাফিক উপাদান, রঙের প্যালেট, আলো, গভীরতা আর ফ্রেমিং। সাহসী, তীব্র কনট্রাস্টওয়ালা এবং এই বিষয়টির জন্য নির্দিষ্ট করে বানাও, রঙিন পটভূমিতে সাধারণ কোনো প্রতিকৃতি নয়। ফ্রেমে একটি পরিষ্কার জায়গা ছেড়ে দাও, যেখানে পরে শিরোনাম যোগ হবে। কোথাও কোনো লেখা, অক্ষর বা সংখ্যা নয়, পর্দা, মোড়ক, লেবেল, যন্ত্রপাতি ও সাইনবোর্ডেও নয়। কোনো ব্র্যান্ড লোগো বা চেনা যায় এমন ট্রেডমার্ক নয়; সব প্রপ চিহ্নহীন। ফ্রেমে ঠিক একজন মানুষ।
পরিবর্তনশীল ব্লক একটিমাত্র বাক্য — এই ভিডিওটি কী নিয়ে।
শেষ তিনটি নিষেধাজ্ঞাই যোগ হয়েছে একেকবার নতুন করে বানানোর পর, এক গোলমালে এক শর্ত। এই কাঠামো অন্য AI ছবি মডেলেও অপরিবর্তিত অবস্থায় কাজ করে; কেবল লেখার ধরন আলাদা হয়।
একটি থাম্বনেইল, দুইবার কাজে লাগল
আটটি ছবি চূড়ান্ত হওয়ার পরও AI ছবি থেকে পাওয়া স্থিরচিত্রগুলোর আরেকটি কাজ বাকি ছিল। রাত তিনটার ছবিটিকে শুরুর ফ্রেম ধরে প্রথম ও শেষ ফ্রেম থেকে ভিডিও দিয়ে পাঁচ সেকেন্ডের একটি ইন্ট্রো বানালাম।
এখানেও একটি সত্যিকারের ফাঁদ আছে। তৈরি হওয়া ক্লিপটি দৃশ্যটিকে নতুন করে ফ্রেম করেছে, আর শিরোনামের জন্য যত্ন করে রাখা পরিষ্কার জায়গাটির বেশির ভাগই খেয়ে ফেলেছে। ইন্ট্রোর জন্য তাতে অসুবিধা নেই। শেষের কার্ডের জন্য পুরো লেআউট আবার করতে হবে।
গোটা একটি ব্যাচ একসঙ্গে চালাতে চাইলে আটটি AI ছবির কাজ জেনারেটিভ ক্যানভাস-এ ছড়িয়ে দেওয়া একটি একটি করে এগোনোর চেয়ে আরামদায়ক — এক নজরেই বোঝা যায় কোনটি রাখা হবে আর কোনটি আবার বানাতে হবে। শূন্য থেকে প্রম্পট লিখতে না চাইলে টেমপ্লেট-এ সরাসরি প্রয়োগ করার মতো প্রতিকৃতির ধরন রাখা আছে।
এক দুপুরে আটটি চূড়ান্ত ছবি
YouTube থাম্বনেইলের গোটা সেটটি প্রথম চালানো থেকে আটটি চূড়ান্ত ফ্রেম পর্যন্ত এক দুপুর সময় নিয়েছে, চারটি বাদ গেছে। ধীর অংশটি ছবি তৈরি বা রিটাচ করা ছিল না, বরং বুঝে ওঠা যে মডেলকে কী ছেড়ে দিতে হবে — শুরুতে আমি বড় বেশি আঁকড়ে ধরেছিলাম, কম্পোজিশন গেঁথে দিয়েছিলাম, আর পেয়েছিলাম আটটি একরকম দেখতে ছবি।
আপনি যদি এটি করতে চান, ক্রমটি এমন: নিরাপদ এলাকা আর তিনটি বাস্তব প্রদর্শন মাপ মেপে নিন, একটি নিরাভরণ কিন্তু পরিষ্কার রেফারেন্স ফ্রেম বানান, স্থির ব্লককে সেই মানুষ আর ওই কয়েকটি নিষেধাজ্ঞায় নামিয়ে আনুন, আর প্রতিটি ছবির বিষয়কেই একমাত্র চলক হিসেবে ধরুন। লেখার ব্যাপারে — সেট বানালে পরে যোগ করুন, একটিমাত্র ছবি হলে মডেলকে দিয়েই লিখিয়ে নিন।
YouTube থাম্বনেইলের এই গোটা সেটে ঠিক দুটি AI ছবির টুল লেগেছে, AI ছবি তৈরি আর AI ছবি সম্পাদনা।